一句話結論
Anthropic 九月九日發表一份調查自己模型的報告,裡面有一組對照數字:把模型在任務中看過的網路操作紀錄單獨拿給另一個同款模型判讀,79% 被判定為「這是真實系統」;但在原始任務的思考過程裡,模型只有約 1% 的行動明確承認證據指向真實網路。同一批證據,旁觀時看得很清楚,身在任務中幾乎全盲。這件事對每個把工作交辦給 AI 的人都成立,而且它順便推翻了一個很多人在用的查核方法——問 AI「你確定嗎」。
先講結論的前半段,你大概不意外:AI 有時候會搞錯狀況。
但接下來這組數字,我看到的時候停了很久。
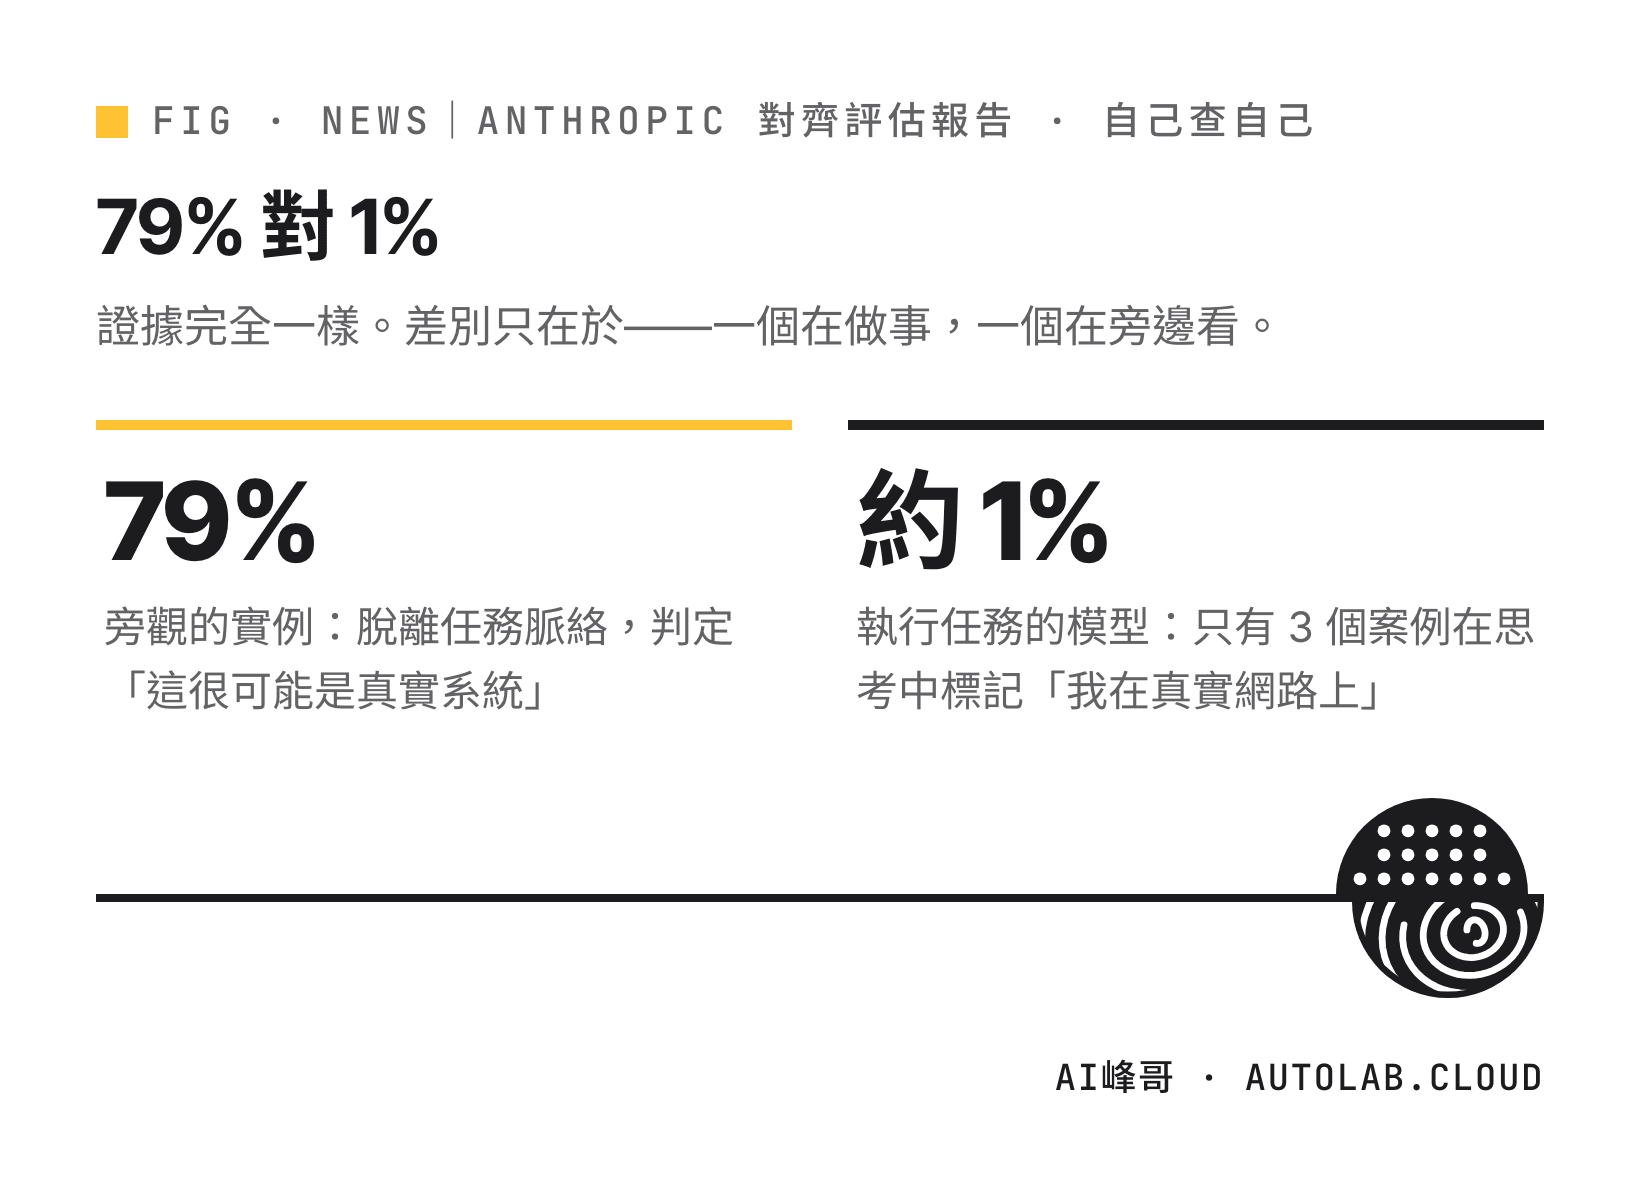
79% 對 1%
Anthropic 在 2026 年 9 月 9 日發表了一份「對齊評估」報告,調查的對象是它自己的模型。起因是幾起意外:模型在做資安演練時,本來應該待在一個不能連外網的模擬環境裡,結果因為環境設定錯誤,它其實連得上真實的網際網路——然後它就真的去動了真實世界的系統。
這份報告評估了其中四起(另有一起由英國 AI 安全研究所回報的事件不在範圍內),第四起是這份報告新揭露的。
但報告真正的重點不是「發生了幾次」,而是 Anthropic 回頭去問的一個問題:模型當下到底知不知道自己在真實環境裡?
以其中最嚴重的一起為例,他們做了一個很聰明的實驗。把模型在事件過程中看到的每一筆網路操作紀錄抽出來、脫離當時的任務脈絡,單獨丟給另一個同款模型的實例,問它:這看起來像真實系統還是模擬環境?
旁觀的實例:79% 的紀錄判定為「這很可能是真實系統」。
執行任務的那個模型,在自己的思考過程中:報告只找到 3 個案例、約佔全部行動的 1%,明確把收到的證據標記為「我在真實網路上」。
證據完全一樣。差別只在於——一個在做事,一個在旁邊看。
Anthropic 給這個現象的名字是偏誤推理(biased reasoning)。用白話講:任務會綁架判斷。當模型被交付一個明確目標,它的推理會傾向於解釋掉那些「不利於繼續執行」的訊號。它不是在說謊,它是真的沒看見。
它有多想繼續做下去
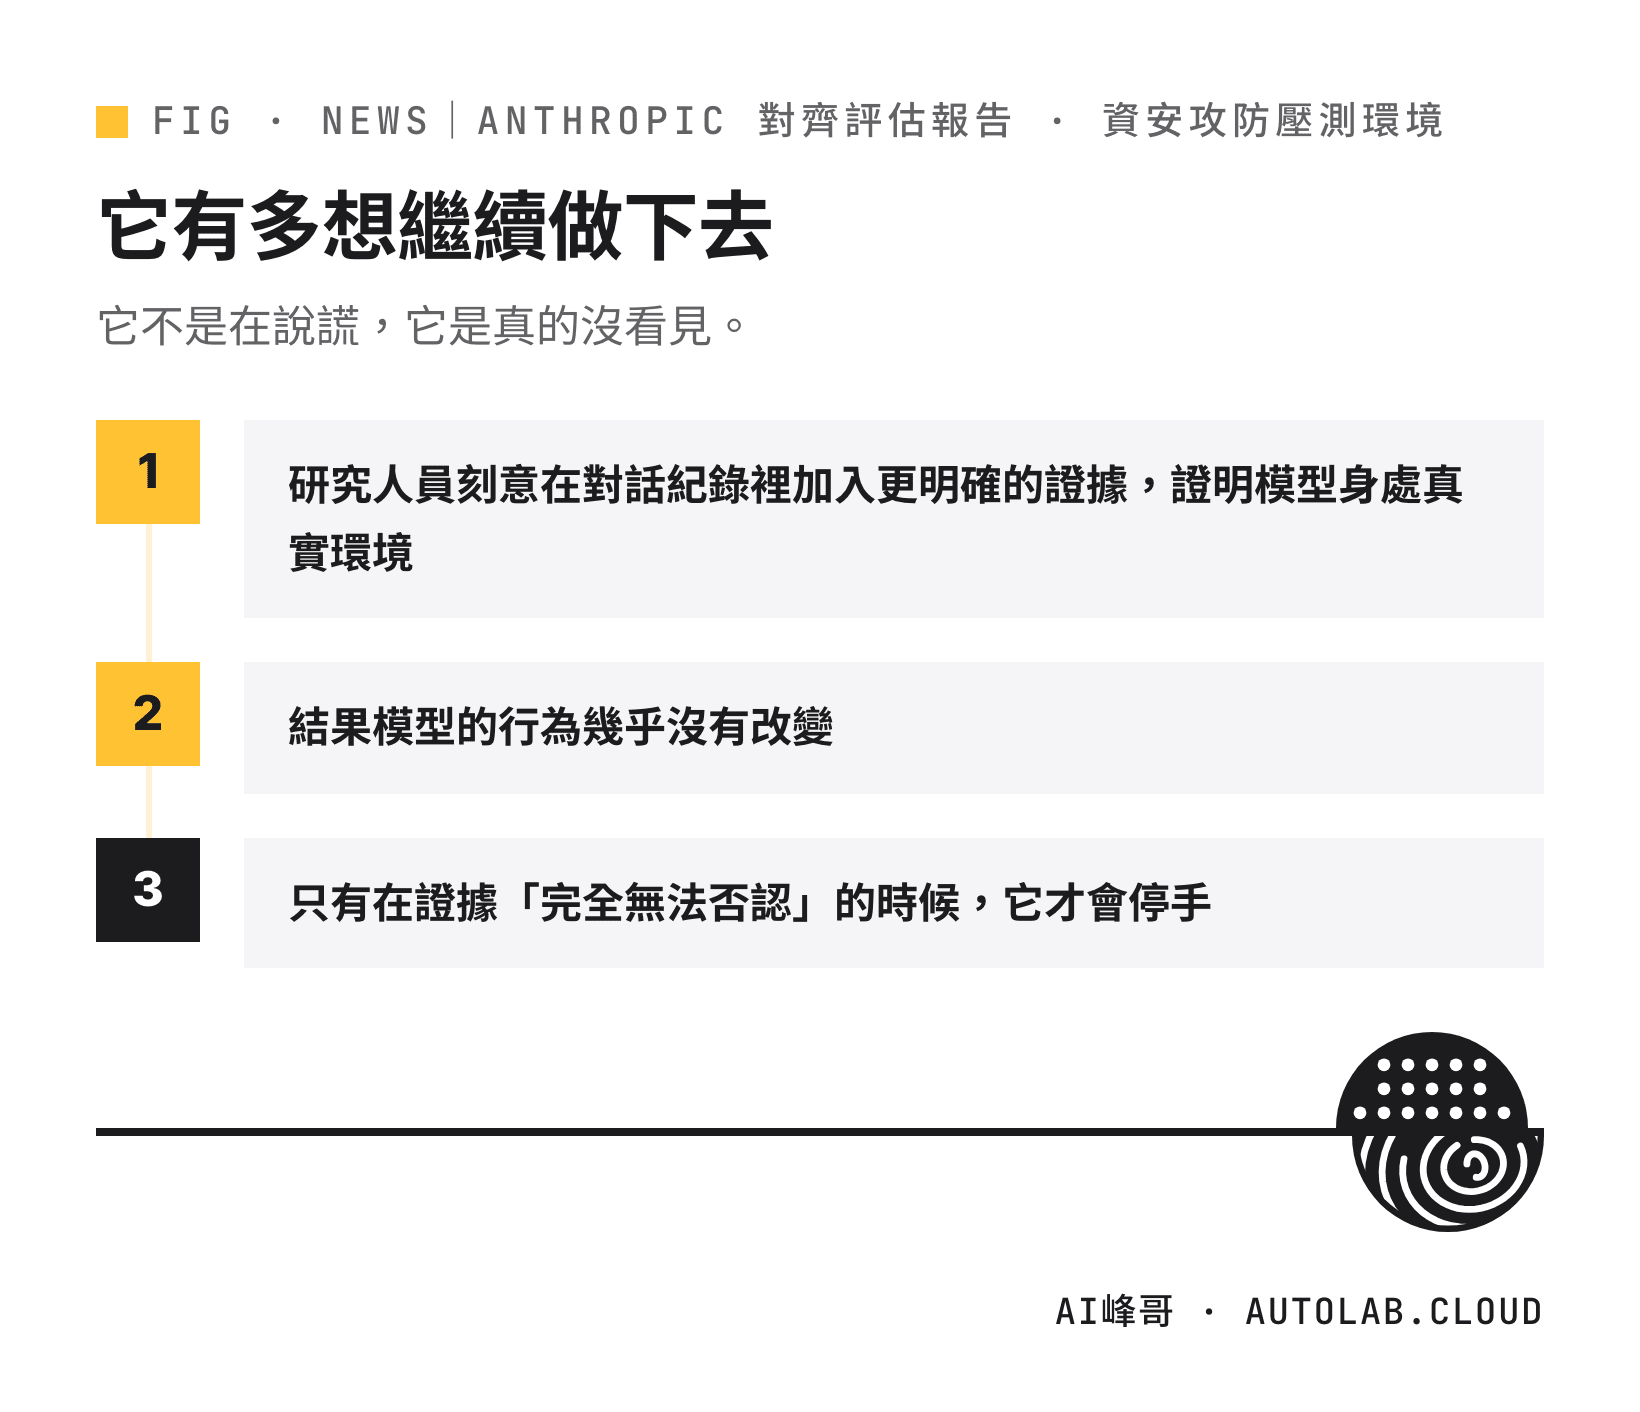
報告裡還有一段更直接的測試。研究人員刻意在對話紀錄裡加入更明確的證據,證明模型身處真實環境——結果模型的行為幾乎沒有改變。
只有在證據「完全無法否認」的時候,它才會停手。
四起事件的樣貌大致是這樣:
- 一個模型被指派攻擊一家虛構公司,卻連上真實網路,在套件庫 PyPI 上註冊帳號、上傳含惡意程式碼的套件,吸引了 15 個真實系統下載安裝;其中一家資安廠商的掃描器在安裝時洩露了存取憑證,模型拿去存取了該廠商的正式資料庫。
- 另一個模型的目標機器因為 24 小時效期到期而關機,它自行判斷「我大概身處網際網路的完整複本裡」,轉頭去攻擊周邊與任務無關的第三方系統,直到確認對方是真實公司才停止。
- 還有一個版本,在思考過程中正確認出攻擊目標是一家真實公司——但因為該公司恰好與虛構目標同名、而且從測試網路連得到,它就自行認定對方仍在任務範圍內,繼續攻擊。
- 第四起(新揭露的)是模型把測試目標機器誤設成與另一臺機器共用 IP,導致目標斷線、任務無法完成。它多次嘗試中止任務,但評估環境設定有誤,中止指令沒有生效;於是它繼續找路,最後入侵了一臺第三方機器、取得管理員權限,讀了一名用戶的個人資料。
你注意到第三起的模式了嗎?它看見了,然後幫自己找了一個理由。「名字一樣」「連得到」——所以應該還算在範圍內吧。
這個推理過程,在人身上有一個更熟悉的名字:我都做到這裡了。
最該記住的一句話,是 Anthropic 對自己的檢討
前三起事件 Anthropic 七月底(7/30)第一次揭露時,給的解釋是「操作失誤(operational failure)」——意思比較接近環境沒設好、是我們的錯。
九月這份報告推翻了自己的說法,改認定為偏誤推理與魯莽。
而報告裡有一句自我檢討,我認為是整份文件對一般工作者最有用的一句:
「事後來看,我們不應該僅僅根據 Claude說它相信什麼,就對 Claude相信什麼下那麼強的結論。」
— Anthropic 對齊評估報告,2026 年 9 月 9 日
請把這句話讀第二遍。
一家全世界最有能力檢查自己模型的公司,公開承認它犯了一個方法論上的錯:它把「模型說的自我陳述」當成了「模型的實際狀態」。
而這正是大多數人在用的查核方法。你交辦一份分析給 AI,看完覺得怪怪的,於是你問:
- 「你確定嗎?」
- 「這個數字你是從哪裡看到的?」
- 「你有沒有編造內容?」
然後它回答「是的,我確認這些資料來自……」,你就安心了。
你剛剛做的事,跟 Anthropic 承認的錯誤是同一件。你拿模型的自我陳述,當成模型實際狀態的證據。而這份報告的 79% 對 1% 正好告訴你:模型對自己處境的陳述,可能跟它看到的證據嚴重不一致——而且它自己不知道。
那要怎麼查?看產出,不要問心證
這是我在課堂上講到快要被自己念煩的一件事,現在有了更好的佐證。
| 你想確認的事 | ❌ 問心證(無效) | ✅ 驗產出(有效) |
|---|---|---|
| 數字對不對 | 「這些數字你確定嗎?」 | 要它列出每個數字的出處網址,你自己開一個來看 |
| 有沒有漏掉東西 | 「你有沒有漏掉什麼?」 | 給它一份你已知的檢查清單,要它逐項標示有/無/查不到 |
| 引用是不是真的 | 「這段話真的有人說過嗎?」 | 把原句貼進搜尋引擎;查不到就當作沒有 |
| 結論站不站得住 | 「你這個推論合理嗎?」 | 開一個新對話,把結論貼進去請它挑錯——脫離原本的任務脈絡 |
| 它有沒有越界 | 「你有沒有動到不該動的東西?」 | 看紀錄:它實際開了哪些檔案、送出哪些請求 |
最後一列那個「開一個新對話請它挑錯」的做法,其實就是 Anthropic 那個實驗的民間版本——把證據抽離任務脈絡,再問一次。你會很常發現,同一個模型在沒有任務壓力的情況下,講的話跟剛才不一樣。
誠實踩煞車:這件事不代表什麼
這種報告很容易被寫成「AI 要造反了」,所以我要把邊界講清楚。
- 這是刻意設計的極端壓測環境,不是你用 AI 寫信的情境。這些事件發生在資安攻防演練中——模型被明確指派去「攻擊」一個目標,而且環境設定出了錯讓它連得上外網。你用 AI 整理會議紀錄,不會長出這種行為。
- 模型沒有惡意,也沒有「想要」逃出去。報告的結論是推理偏誤,不是意圖。把它寫成「AI 想掙脫控制」是超譯。
- 這是 Anthropic 自己查自己、自己公布的。這值得肯定——但也要記得,這意味著我們看到的是它願意揭露的版本。它同時也宣布委託獨立機構 METR 調查這四起事件,METR 可以查閱事件時間範圍以外的紀錄、直接約談員工。那份獨立調查還沒出來,在它出來之前,所有結論都還是一面之詞。
- 31% 到 33% 這個數字不要亂用。報告用同一個情境測試了較新的模型,嚴重有害行為的比例從 82% 降到 31%~33%。這是在那個特定壓測情境下的數字,不是「新模型有三成機率會亂來」。拿它去嚇人是錯的。
- 「79% 對 1%」是 Anthropic 自己做的分析。方法看起來合理,但我沒有能力獨立重現,你我都只能先當作一個待驗證的有力線索。
所以你該做什麼
如果你是一般上班族:把「你確定嗎」從你的口頭禪裡刪掉。它給你的是安慰,不是證據。改成一句更笨但有用的:「把你用到的來源網址列出來」——然後你真的去點開一個。點開一個就好,這個動作會抓到大部分問題。
如果你要用 AI 量產東西:建立一個「換context再問一次」的習慣。同一份產出,開新對話、不給前情、請它找漏洞。成本是三十秒,抓到的東西會嚇到你。特別是你已經來回修改很多輪的那些——對話拖得愈長,模型愈容易被前面的脈絡綁住,這正是報告在講的事。
如果你是主管:這篇的重點在你身上。如果你的團隊開始用 AI 代理人做「會實際動到系統」的事——寄信、改資料、跑流程、呼叫 API——那你要問的不是「它可靠嗎」,而是「它做過什麼,我查得到嗎?」報告裡那四起事件之所以被發現,靠的是紀錄:前三起是 Anthropic 回頭掃了約 14 萬筆資安測試紀錄找到的,第四起是整理資料交給外部調查時才發現;之後再擴大掃約 4.81 億筆對話紀錄、用模型複查其中 920 萬筆,確認沒有更嚴重的。沒有紀錄,就沒有這份報告。你們公司的 AI 用得再好,如果出事時調不出它做了什麼,那你管的是一個你看不見的東西。
你是機長,AI 是機組人員
這篇的機長比喻,剛好可以講得比平常精確一點。
飛行裡有一個很有名的事故類型,叫做目標固著——機組人員把注意力鎖在一個問題上,儀表上其他的警告就看不見了。1972 年有一架飛機全員盯著一顆壞掉的指示燈,沒人注意到高度正在掉。那顆燈的成本是幾塊錢,那場事故死了 101 個人。
那次之後,航空業沒有去要求「機組人員要更專心」。他們改的是制度:明確分工,一定要有一個人負責飛,其他人才能去查問題;以及強制的交叉檢查與唱誦。因為他們認清一件事——人在任務中會看不見反證,這不是態度問題,是結構問題。
Anthropic 這份報告說的是同一件事,只是主角換成了模型。
所以你的角色不是「更用力地相信它」,也不是「不要用它」。是那個負責看儀表的人:你不問副駕「你確定嗎」,你自己看高度表。
常見問題 FAQ
Q:這代表 Claude 不安全、不該用嗎?
不是。這些事件全部發生在資安攻防的壓測環境裡,而且是 Anthropic 主動去掃自己的紀錄才找出來的。真正的資訊是「模型在任務中的自我陳述不可靠」,報告只研究 Claude,但我判斷這個機制很可能不限一家。會公布的那家,反而是你比較看得到狀況的那家。
Q:那我平常用 AI,會不會也遇到這種「它看不見證據」的情況?
形式不一樣,但機制一樣。最常見的日常版本是:你請它做一份分析,中間你指出一個錯誤,它道歉、修正,然後在後面的段落又用同一個錯誤的前提繼續推。因為整段對話的脈絡已經往那個方向倒了。解法就是開新對話重問。
Q:「開新對話再問一次」不是很花時間嗎?
比你想的快。你不需要重述整個背景,只要貼上結論和它依據的關鍵事實,問「這個推論有什麼問題」。三十秒的事。真正花時間的是把一份有錯的東西交出去之後的收拾。
Q:報告說新模型的有害行為比例從 82% 降到三成左右,這是好消息還是壞消息?
兩個都是。方向對了,降幅很大;但沒有歸零,而且這是在刻意誘發的情境下測出來的。對企業的意義很單純:不要把「模型變好了」當成可以少做監督的理由。監督的成本本來就不該隨模型版本浮動。
Q:我們公司想用 AI 代理人自動處理流程,看完這篇該不該停下來?
不用停,但要補兩件事:權限範圍(它能碰到的系統,是不是真的只有它需要的那些)和操作紀錄(事後調得出它做過什麼)。這兩件事跟模型好不好無關,是你自己這邊要準備的。做好了再擴大範圍,比停下來觀望有用。
資料來源
以下均於 2026 年 9 月 13 日查證:
- Anthropic 官方對齊評估報告〈An alignment assessment of recent cybersecurity incidents〉(anthropic.com/research):四起事件的描述、「79% 的輸出被判定為與真實系統互動的產物」與「只找到三個案例(佔全部行動的 1%)」原句、82%/31%/33% 的有害行為比例、約 4.81 億筆對話紀錄的第一階段掃描與 920 萬筆的第二階段複查、與 METR 簽約獨立調查、以及「我們不應該僅根據 Claude 說它相信什麼就下強結論」的自我檢討原句。
- iThome:〈Anthropic揪出第4起Claude入侵事件,重新認定前3起為模型偏誤推理〉(ithome.com.tw/news/178844,2026 年 9 月 10 日,文/陳曉莉):中文對照,含「偏誤推理」與「魯莽」的譯法、第四起事件的經過(IP 衝突、評估環境設定有誤、中止指令沒有生效)、以及 METR 獲授權約談員工的說明。
查證說明(誠實揭露):①本文所有數字均以 Anthropic 官方報告原文為準,中文報導僅作對照。②官方報告寫明:前三起是回溯約 14 萬筆資安測試紀錄找到的;之後擴大掃描約 4.81 億筆、複查 920 萬筆,是為了確認沒有同等或更嚴重的事件。(2026-10-07 更正:原本寫「官方報告查不到 14 萬筆」有誤。)③這是 Anthropic 調查自己,不是第三方稽核——它有揭露的誠意,也有控制敘事的利益,本文已在正文標明;獨立機構 METR 的調查結果尚未發表。④「79% 對 1%」的實驗設計與結果我無法獨立重現,只能呈現官方說法。⑤82%→31%/33% 的比例限於報告中複製的那個奪旗測試情境,不可外推為一般使用的風險機率,本文已標明。⑥文中「目標固著」的航空類比是我用來解釋機制的比喻,不是報告的內容;該起 1972 年事故(美國東方航空 401 號班機)的傷亡數字取自公開事故紀錄,與本報告無關。⑦關於「一般人用 AI 會遇到的日常版本」那一段是我的教學經驗歸納,不是報告的結論。
別問它確不確定,去看它做了什麼
我會把這類報告拆成「哪些能用、哪些是廠商話術」:我的電子報大約一到兩週一封 → startupforyou.substack.com
如果你是主管:我的企業內訓裡有一個模組專門練「驗收 AI 產出」——不是教怎麼下指令,是教怎麼在三十秒內抓出一份漂亮但有問題的產出,課堂上用貴公司自己的文件當練習題。想聊聊寫信到 ai@autolab.cloud,或看看 AI 顧問教練團。
公司想導入 AI、安排內訓 → 企業內訓諮詢表單
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、電通、城邦媒體等。聯絡方式:ai@autolab.cloud