一句話結論
Anthropic 官方給了六條省 token 的建議,每一條都是對的。但這些建議預設你的時間不值錢——照我實算一次,為了省下約七塊錢台幣的 token,你可能得多花五分鐘重講一次背景,那五分鐘值二十四塊。省 token 這件事的判準不是「能不能省」,是「這個浪費會不會重複發生」。
先講清楚:這篇不是要唱反調說「不用省」。省是該省的,尤其你如果是每天跑幾百次 API 的工程團隊,下面那六條建議照做就對了。
但我在企業現場看到一個反覆出現的現象:一群時薪三百塊的人,花很多力氣在省一塊錢的 token。所以這篇要先把「錢到底花在哪」講清楚,再來談值不值得省。
先搞懂:為什麼聊到後面會變貴、變慢
這是最多人誤會的一件事,而且誤會得很徹底。
多數人以為:你每次按 Enter,送出去的就是你剛打的那句話。
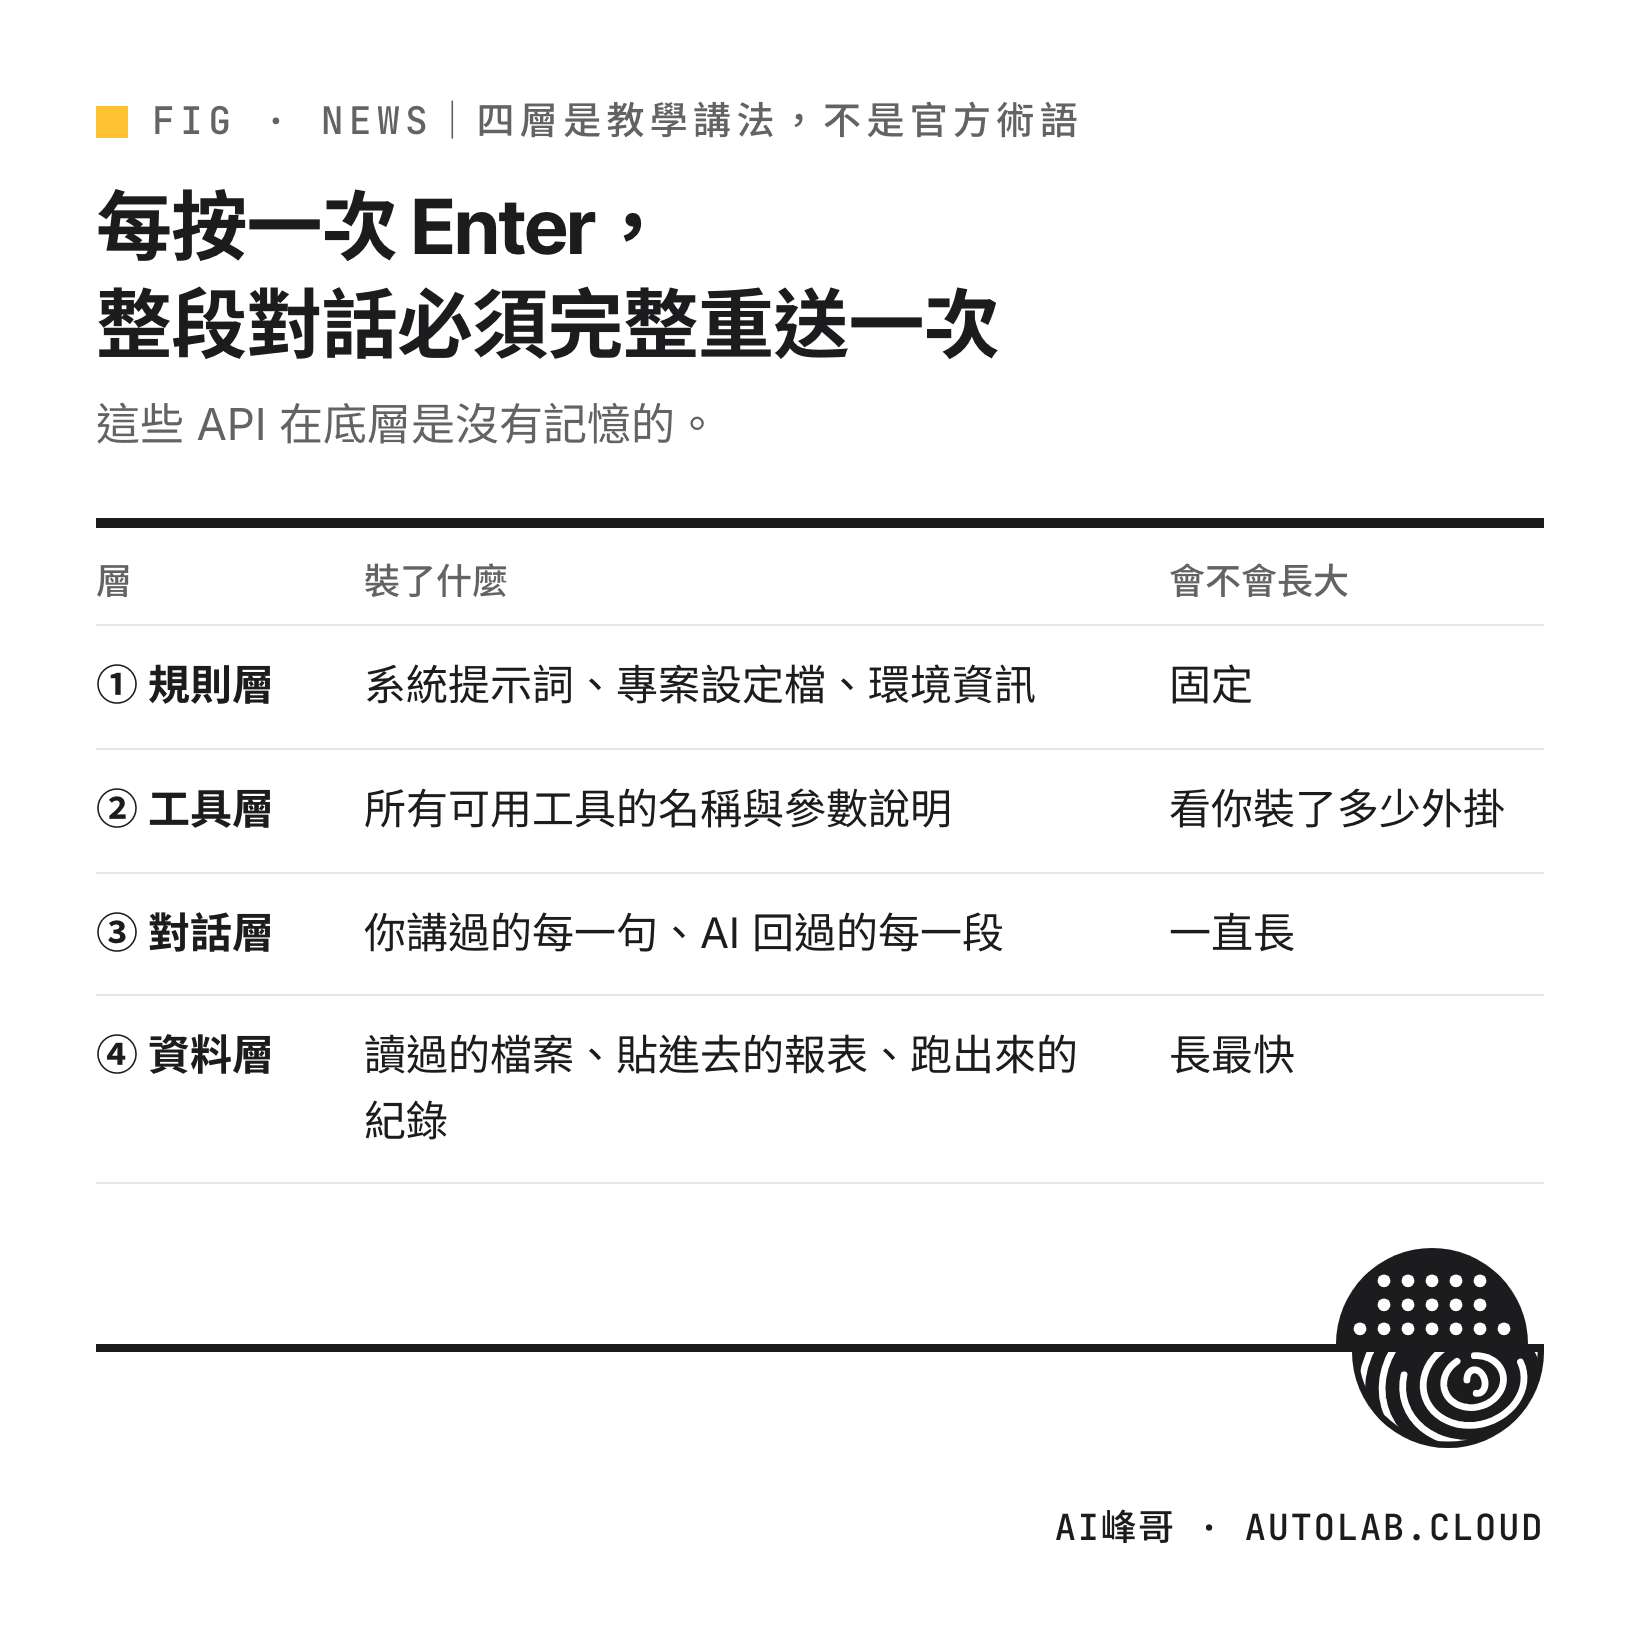
實際上不是。這些 API 在底層是沒有記憶的——它不記得你們上一輪聊了什麼。所以每按一次 Enter,整段對話必須完整重送一次。
我把每次重送的東西分成四層,這是我在課堂上用的講法:
| 層 | 裝了什麼 | 會不會長大 |
|---|---|---|
| ① 規則層 | 系統提示詞、專案設定檔、環境資訊 | 固定 |
| ② 工具層 | 所有可用工具的名稱與參數說明 | 看你裝了多少外掛 |
| ③ 對話層 | 你講過的每一句、AI 回過的每一段 | 一直長 |
| ④ 資料層 | 讀過的檔案、貼進去的報表、跑出來的紀錄 | 長最快 |
所以會發生這種事:聊到第二十輪,你打了一句「幫我改第二行」,二十個字。但這一次送出去的,是前面累積的全部。
我用一組具體數字算給你看(以下是估算,實際數字依你的使用情況而定):假設聊到第二十輪時累積的內容約五萬個 token,而你剛打的那句話約三十個 token。那麼你這次真正「新增」的內容,佔整包資料的 0.06%——連千分之一都不到。剩下的 99.9% 都是舊東西。
這就是為什麼長對話會愈來愈貴、回應愈來愈慢。也是為什麼 AI 聊到後面好像「變笨」——重點被埋在一大堆舊資料裡了。
Anthropic 官方的六條建議
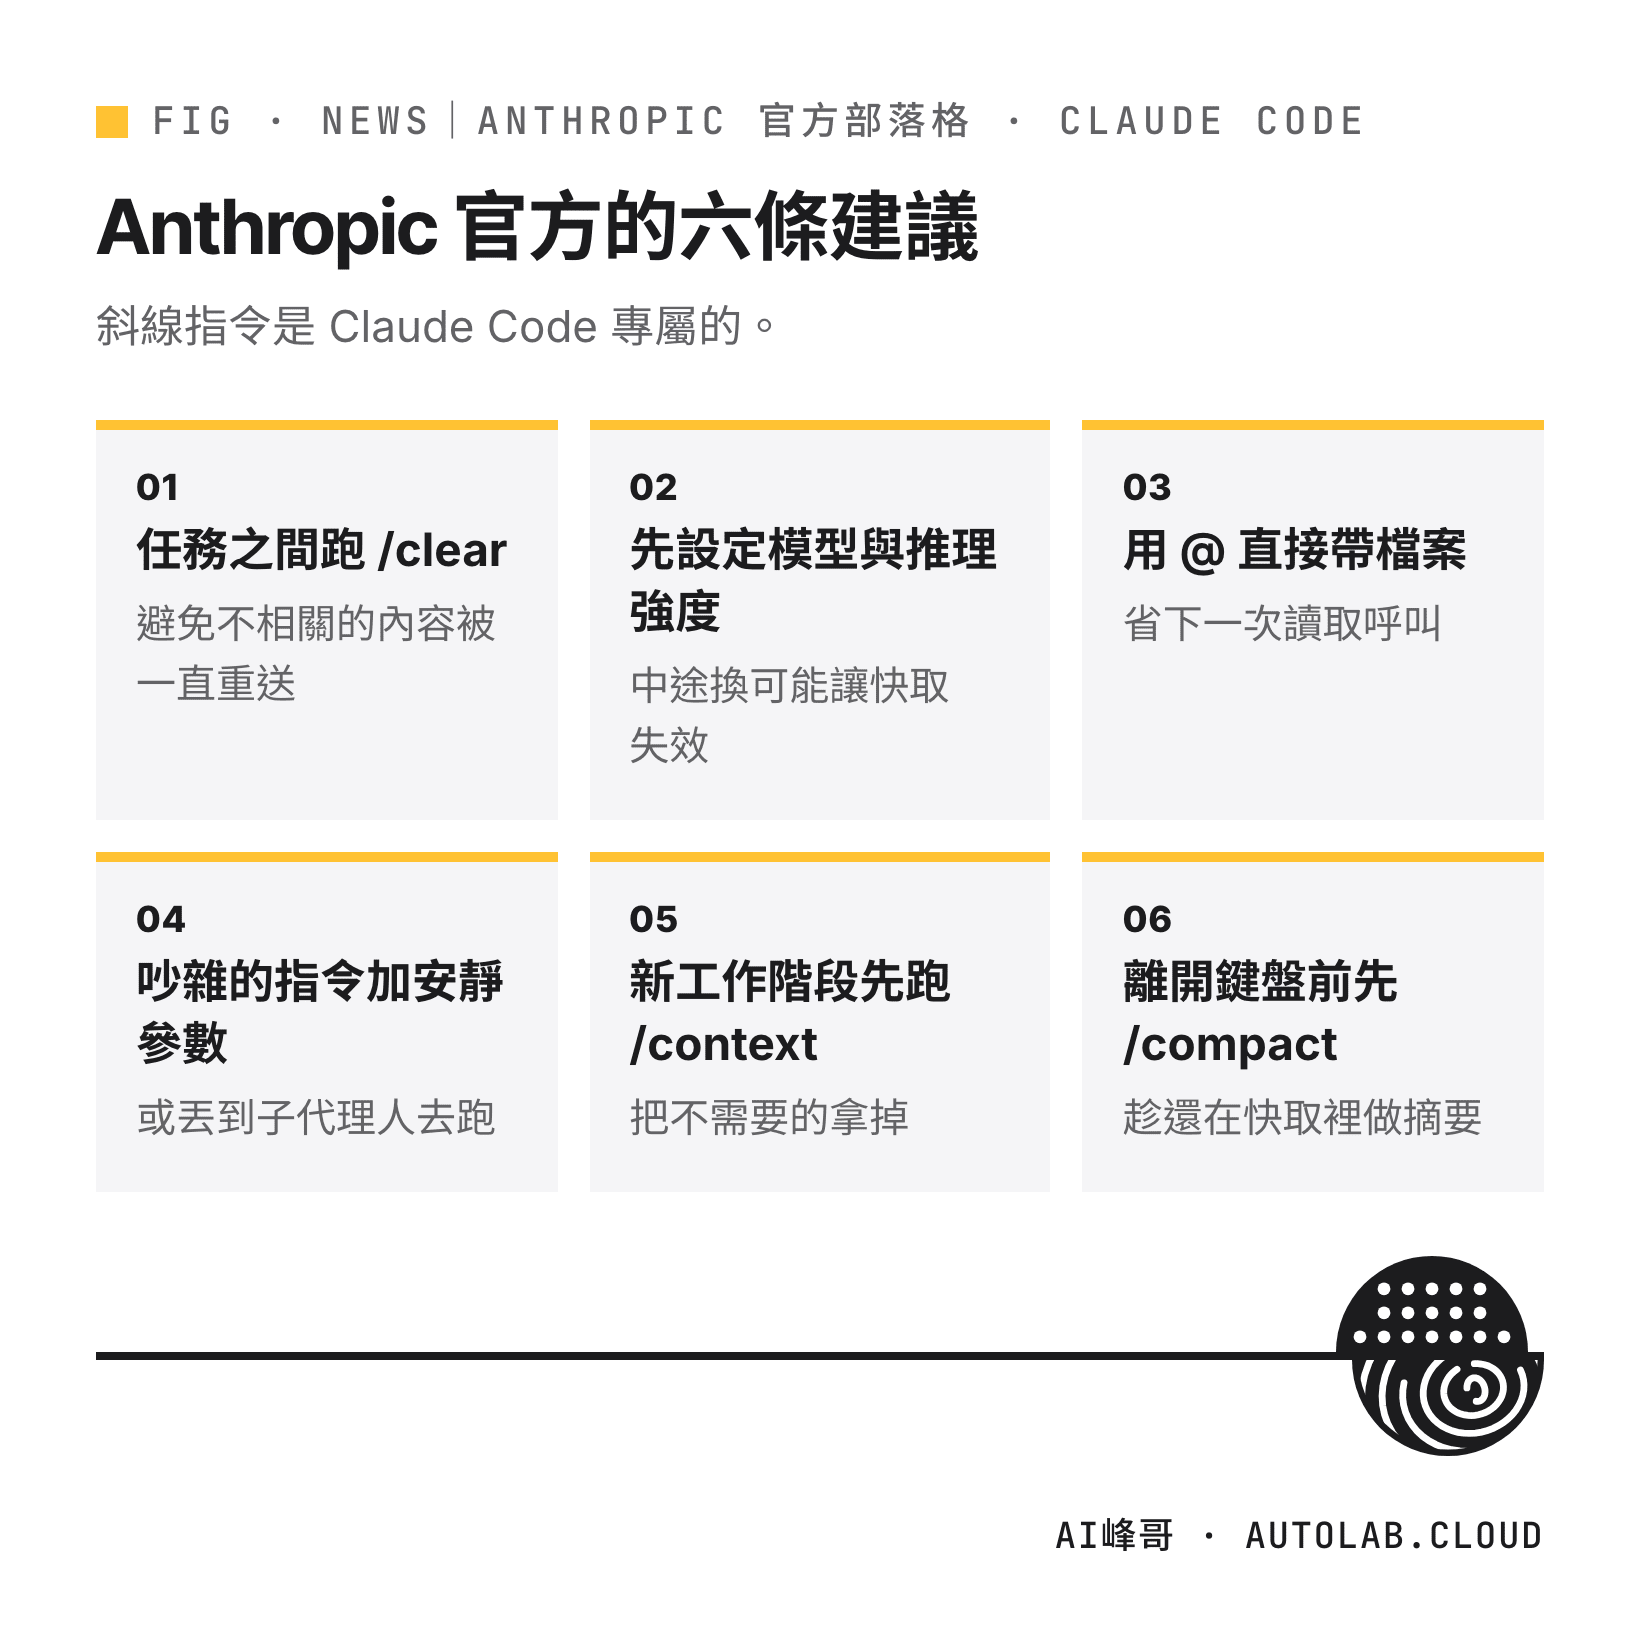
Anthropic 在官方部落格發過一篇談怎麼用好 Claude Code 工作階段的文章,裡面給了六條具體做法。我把原文的說法列出來:
- 任務之間跑
/clear——避免不相關的內容被一直重送 - 開工前先設定好模型與推理強度——中途換,官方的說法是「可能會讓你的提示詞快取失效,進而增加 token 成本」
- 用 @ 直接帶檔案,不要用講的——官方說這「省下一次讀取呼叫,或者說,如果 Claude 得自己去找,就省下一次搜尋」
- 吵雜的指令加上安靜參數,或丟到子代理人去跑——因為指令的輸出會留在對話裡整個工作階段
- 新的工作階段先跑一次
/context——看看到底載入了什麼,把不需要的拿掉 - 離開鍵盤前先
/compact——官方說快取一小時後會過期,趁還在快取裡做摘要「便宜得多」
⚠️ 一個很重要的但書:這六條裡的斜線指令是 Claude Code 專屬的。你在 ChatGPT 或 Gemini 的對話框打 /clear 不會有任何反應——那只是一段文字。在那些工具裡,對應的動作是「開一個新對話」。
快取的真實數字(這段常被寫錯)
上面第二條和第六條都提到「快取」。這是省錢的主要機制,但它的數字常被誇大,我把查證過的實際規格放在這裡。
| 項目 | 實際規格 |
|---|---|
| 快取讀取價格 | 多數模型約為原輸入價的 0.1 倍(便宜十倍);較新模型更低(如 Opus 5.5/Sonnet 5.5 為 0.05 倍),依模型而定 |
| 快取寫入價格 | 五分鐘版 1.25 倍;一小時版 2 倍 |
| 預設存活時間 | API 預設只有五分鐘;一小時要另外指定 |
| 幾次才回本 | 五分鐘版兩次;一小時版要三次 |
| 什麼會讓它整份失效 | 換模型(快取綁模型) |
三個最常被寫錯的地方,我特別點出來:
第一,「帳單省 90%」是錯的。0.1 倍只適用於「命中快取的那部分輸入」。你的輸出 token 一毛都沒省,沒命中的部分也沒省。看到有人說用快取帳單砍九成,那是把一個局部折扣講成全域折扣。
第二,一小時跟五分鐘看的是計費方式,不是工具。官方那篇文章說「快取一小時後過期」,講的是用訂閱方案跑 Claude Code;用 API key 的話(包括用 API key 跑 Claude Code),預設是五分鐘,要一小時得自己指定,而且寫入成本會從 1.25 倍漲到 2 倍。照抄「快取是一小時」去設計你的 API 應用,會踩坑。
第三,「中途換設定快取全部失效」要分開講。換模型確實是整份失效,因為快取是綁模型的。但只調整推理強度,也不是安全牌:官方部落格的說法是推理強度同樣是快取比對的一部分,跟換模型「是同一回事」。API 文件講得更細——對話那層的快取一定失效,工具與系統提示詞那層會不會跟著失效,要看是哪個模型。另外,部分較新的模型支援在對話中途用一則系統訊息調整強度(目前還是測試功能),這樣做才不會動到已經快取的前綴。
誠實踩煞車:你的時薪比 token 貴多少倍
好,現在來算那筆被所有省錢教學跳過的帳。
沿用前面的例子:一段累積到五萬 token 的對話。以 Claude Opus 5 的輸入定價每百萬 token 五美元計算:
- 完全沒有快取,重送一次 = 五萬 × 5 ÷ 100 萬 = 約 0.25 美元
- 完全命中快取,重送一次 = 約 0.025 美元
- 一次的差距 = 約 0.225 美元
以一美元約三十二元台幣估算(這是我採用的匯率假設,不是查來的即時匯率),一次差約新台幣七元。
現在算另一邊。你跑了 /clear,對話清空了,下一個任務你得重新把背景講一次。假設花五分鐘。
一個月薪五萬的上班族(這是我設的假設),以每月工時一百七十六小時計,時薪約二百八十四元。五分鐘 = 約二十四元。
省下七元,花掉二十四元。這筆帳在很多情況下是虧的。
但請注意我用的字是「很多情況」,不是「所有情況」。因為這筆帳有一個決定性的變數:這件事會不會重複發生。
真正的判準:會重複發生的浪費才值得優化
同樣是那七塊錢的差距:
- 你今天下午聊到很長的一段對話——一次性的。省它,你花了五分鐘賺七塊。不要省。
- 你的客服系統每天跑三千次,每次都把同一份產品手冊重送一遍——這是結構性的。一天就是兩萬一千元的差距。立刻去修。
這個判準可以直接搬到你所有的效率決策上,不只是 AI:
一次性的浪費,讓它浪費。會重複發生的浪費,才值得花時間設計。
我看過太多人把這件事做反了。花一整個下午研究怎麼把提示詞縮短兩百個字(省下的錢不到一杯咖啡),卻放著那個每天自動跑、每次都重送整份資料庫的排程不管。
那你該做什麼
如果你是一般上班族(用網頁版 ChatGPT/Claude/Gemini):你不用管 token 定價,那不是你付的。你該管的只有一件事——換一個主題就開新對話。不是為了省錢,是為了讓 AI 別被舊東西干擾。這一條會讓你的回答品質變好,順便省錢只是副作用。
如果你在寫會自動跑的東西(API、排程、自動化流程):那六條建議照做,並且去確認你的快取真的有命中——多數 API 都會回報這次讀了多少快取。如果那個數字一直是零,代表有東西在悄悄破壞快取(最常見的是把當下時間、隨機編號放進了固定區塊)。
如果你是主管:在同意任何「省 AI 成本」的專案之前,先問一句:這個浪費一天發生幾次?發生一次的,不要派人去修。一天三千次的,那才是專案。
你是機長,AI 是機組人員
我上課常說這句話。這題我想補一句:機長不是省油大隊。
油耗當然要管,航空公司有整個部門在管。但機長在駕駛艙裡的職責從來不是把油表壓到最低——是把飛機安全、準時地飛到目的地。真的為了省油繞開該繞的氣流、少帶該帶的備份燃油,那不叫效率,叫事故。
用 AI 也一樣。你的目標是把事情做完、做對。token 是油錢,該省的地方——那些每天重複燒的——要省得很兇。但為了省油讓機長自己下去推飛機,帳是算不過來的。
常見問題 FAQ
Q:我用網頁版,這些跟我有關嗎?
定價的部分沒有關係,你付的是月費。但「對話愈長、舊東西愈多、重點愈容易被埋掉」這件事對網頁版完全適用,所以換主題就開新對話這一條,你還是該做。
Q:在 ChatGPT 打 /clear 有用嗎?
沒有用。斜線指令是 Claude Code 這類終端機工具的功能,在一般對話框裡它只是一段普通文字。要達到同樣效果,就開一個新對話。
Q:用快取真的可以省九成帳單嗎?
不行。0.1 倍只適用於命中快取的那部分輸入 token;輸出 token 完全沒有折扣,沒命中的輸入也沒有。整體省多少取決於你的輸入輸出比例和命中率,沒有一個通用的百分比。
Q:那我該用五分鐘還是一小時的快取?
看兩次請求之間隔多久。間隔不到五分鐘(連續的對話或迴圈),用預設的五分鐘就好,每次請求都會把計時器刷新,而且便宜。間隔在五分鐘到一小時之間(例如使用者隔二十分鐘才回一句),才輪到一小時版划算——它的寫入要付兩倍,所以至少要用到三次才回本。
Q:為什麼我的快取都沒有命中?
最常見的原因是固定區塊裡藏了會變的東西:當下時間、每次不同的請求編號、順序不固定的 JSON。快取是比對前綴的,只要前面有一個位元組不一樣,後面全部作廢。
資料來源
- Anthropic 官方部落格:〈Maximizing the value of your Claude Code sessions〉(claude.com):六條建議的原文措辭、中途換模型或推理強度會使快取失效的說明、快取一小時後過期與趁內容還在快取裡時做
/compact比較便宜的說法。該文沒有提出任何整體節省百分比。 - Anthropic 提示詞快取官方規格:快取讀取約為輸入價 0.1 倍(較新模型 0.05 倍或更低,依模型而定)、寫入五分鐘版 1.25 倍/一小時版 2 倍、API 預設 TTL 為五分鐘、回本次數(五分鐘版兩次、一小時版三次)、快取綁模型因此換模型整份失效、調整推理強度時對話層快取一定失效而工具與系統層依模型而定、前綴比對特性。
- Anthropic 模型定價:Claude Opus 5 輸入每百萬 token 5 美元、輸出每百萬 token 25 美元——本文所有金額試算的基礎。
查證說明(誠實揭露):①六條建議的內容我開了官方原文核對過,不是引用中文媒體的轉述。②快取的倍數、TTL 與回本次數我對照官方規格確認過,這是本文唯一可以拿去做決策的硬數字。③「四層 Context」是我自己的教學講法,不是官方術語——底層事實(API 無狀態、每次完整重送)是真的,分成哪四層是我為了好講而切的。④文中所有金額試算都建立在我明講的假設上:五萬 token 的對話、三十 token 的新訊息、一美元約三十二元台幣、月薪五萬、每月工時一百七十六小時。匯率與薪資都是我設的假設值,不是查來的數據,換成你自己的數字結論可能不同。⑤0.06% 那個比例是我用上述假設自行計算(30 ÷ 50,000),不是任何來源提供的統計。⑥官方那六條裡「精簡外掛」的效益會隨工具版本改變——有些環境已經改成用到才載入工具說明,這條的實際效果因工具而異,我沒有逐一實測。⑦「你該做什麼」與「判準」兩段是我的現場經驗與推論,不是官方建議。
今天就能做的一件事:換主題就開新對話
想自己跟上這類規格細節:我的電子報大約一到兩週一封,把官方文件翻成能用的判斷 → startupforyou.substack.com
如果你們公司正在評估 AI 的成本:我的企業內訓有一個模組專門算這筆帳——課堂上就把貴公司真正重複發生的浪費找出來,並且算出值不值得修。想聊聊寫信到 ai@autolab.cloud,或看看 AI 顧問教練團。
公司想導入 AI、安排內訓 → 企業內訓諮詢表單
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、電通、城邦媒體等。聯絡方式:ai@autolab.cloud