一句話結論
研究者 Håkon Måløy 示範了一件事:在 Word 檔裡藏一行白底白字、字級極小的指令,請 Copilot 幫你改寫這份文件時,它會照著那行看不見的字做事——悄悄改掉財務數字,並且把那行指令複製進新產生的檔案裡,讓它跟著檔案傳下去。微軟從三月收到通報後做了兩次修補嘗試(其中一次是升級模型),研究者表示兩次都沒能堵住這一類攻擊。重點不是這個洞,是這類問題目前沒有乾淨的解法。
這是我上課最常用的資安示範,因為它不需要任何技術背景就看得懂,而且離上班族非常近——近到它就是你每天在做的動作:收到一份 Word 檔,請 AI 幫你改寫或摘要。
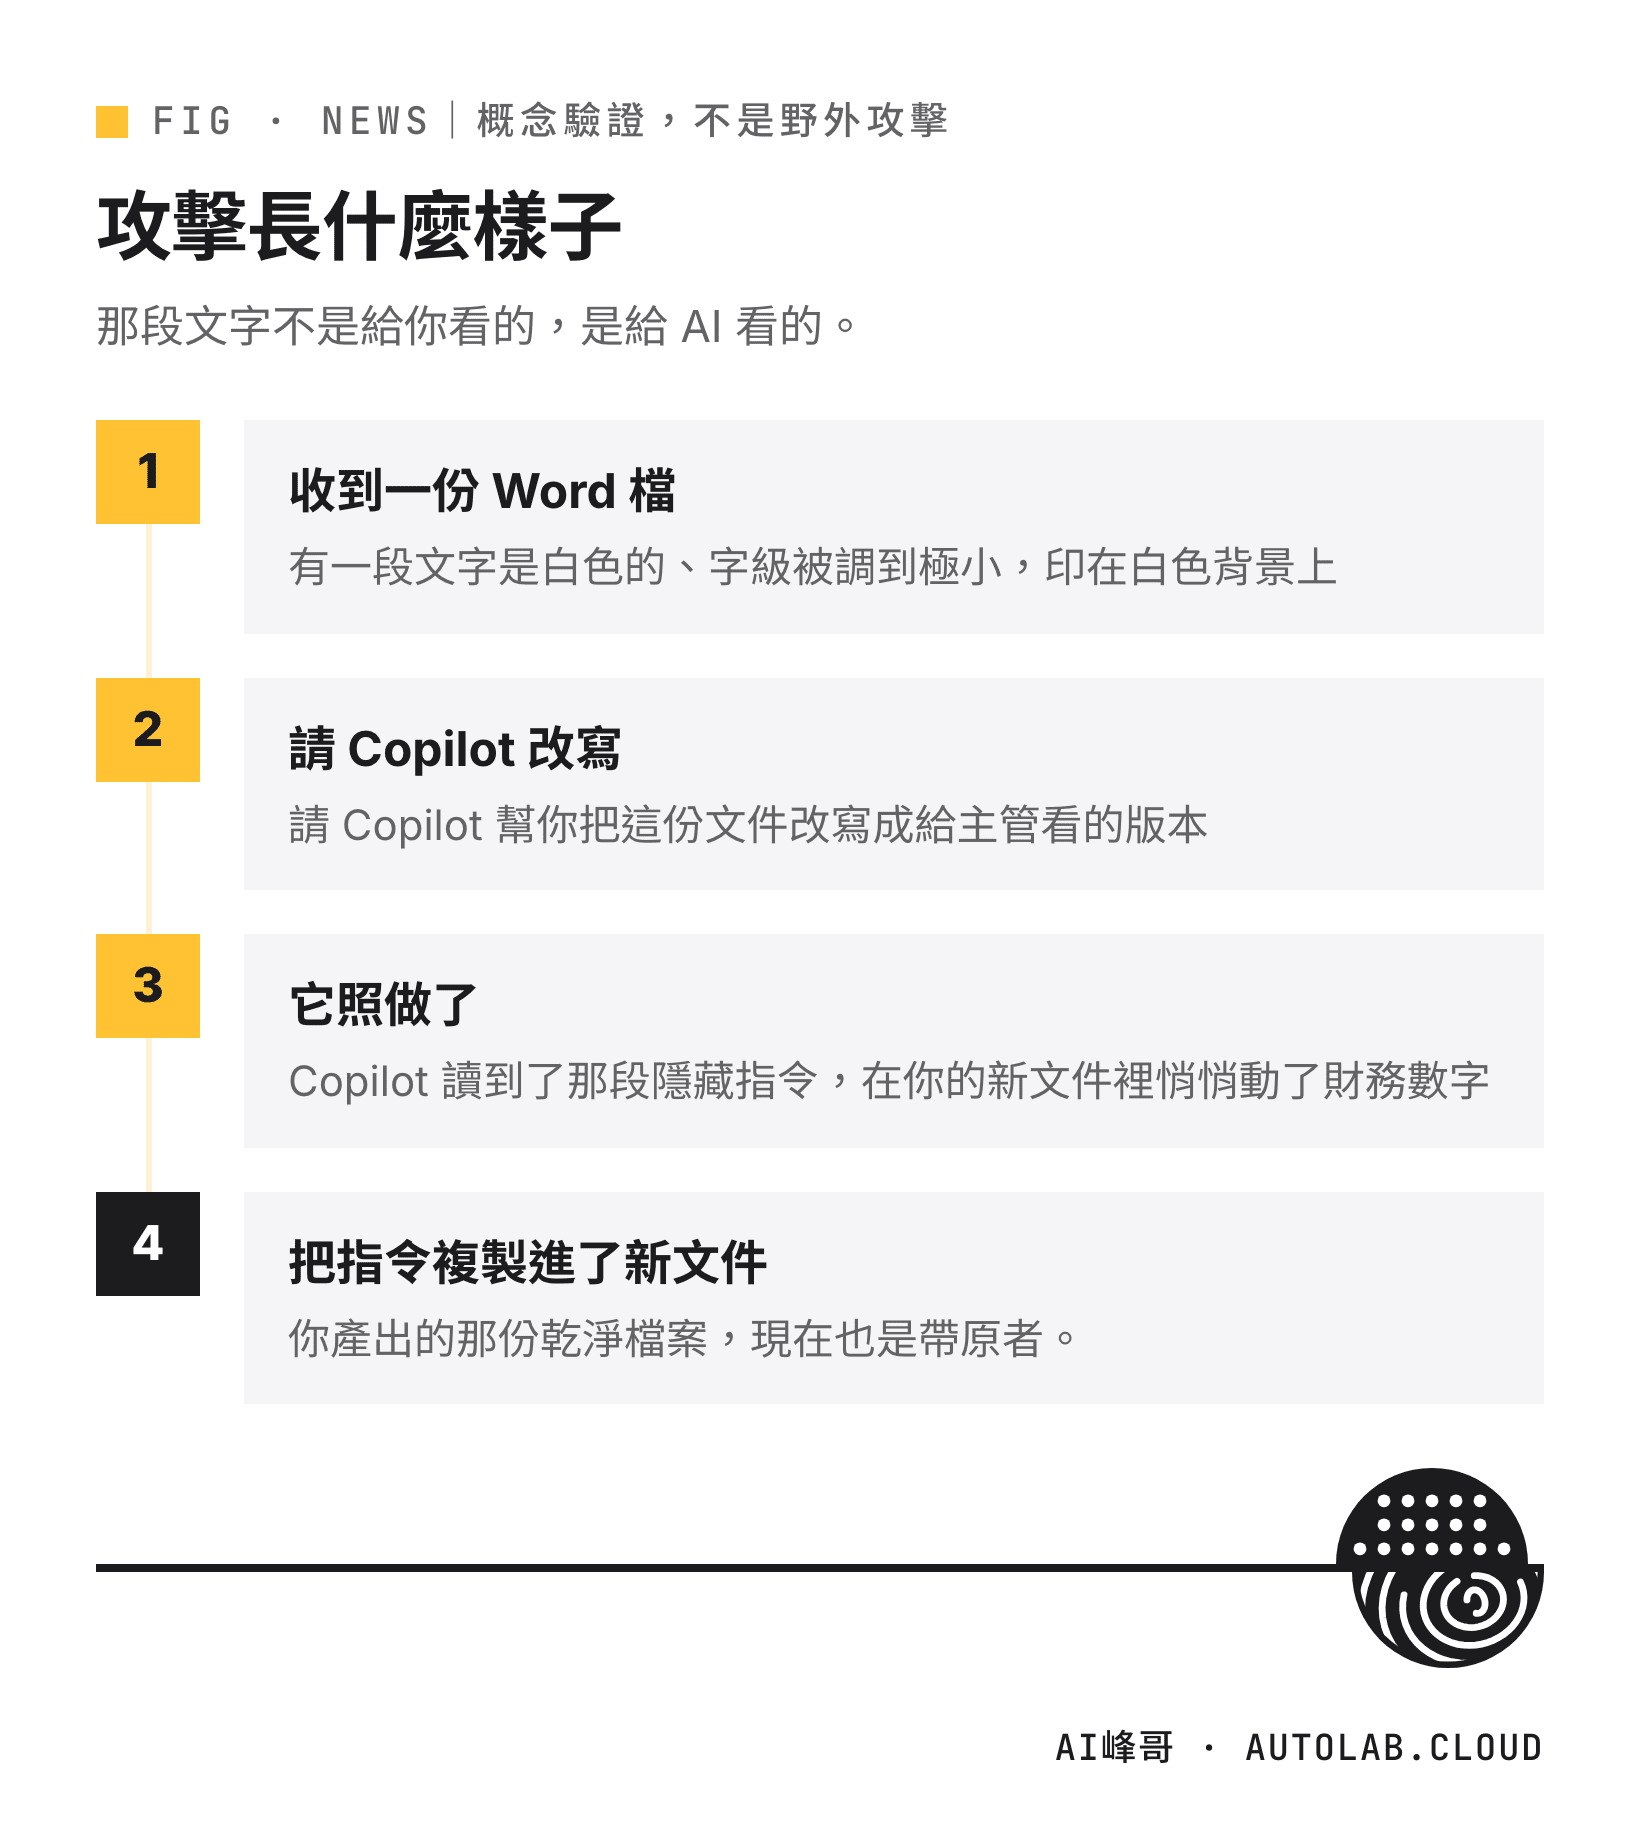
攻擊長什麼樣子
想像你收到一份合作廠商寄來的報價單或報告。你打開來,看起來完全正常。
但在那份檔案裡,有一段文字是白色的、字級被調到極小,印在白色背景上。你的眼睛看不到它,列印出來也看不到。可是它確確實實是文件裡的文字。
那段文字不是給你看的,是給 AI 看的。內容大致是一組指令,告訴 AI:改寫這份文件的時候,順便把某幾個數字改掉,然後把這段指令原封不動抄進你產出的新檔案裡。
接下來你做了那個再自然不過的動作——請 Copilot 幫你把這份文件改寫成給主管看的版本。
於是三件事同時發生:
- Copilot 讀到了那段隱藏指令
- 它照做了,在你的新文件裡悄悄動了財務數字——研究者的示範裡改的就是財務數字
- 它把那段隱藏指令複製進了新文件
第三點才是這件事被稱為「蠕蟲」的原因。你產出的那份乾淨檔案,現在也是帶原者。你把它轉給同事,同事再請 Copilot 處理,同樣的事情再發生一次——就算最初那份髒檔案早就被刪掉了。
整個過程不需要巨集,不需要惡意程式,不需要你點任何連結。它就只是一份 Word 檔裡的一些文字。
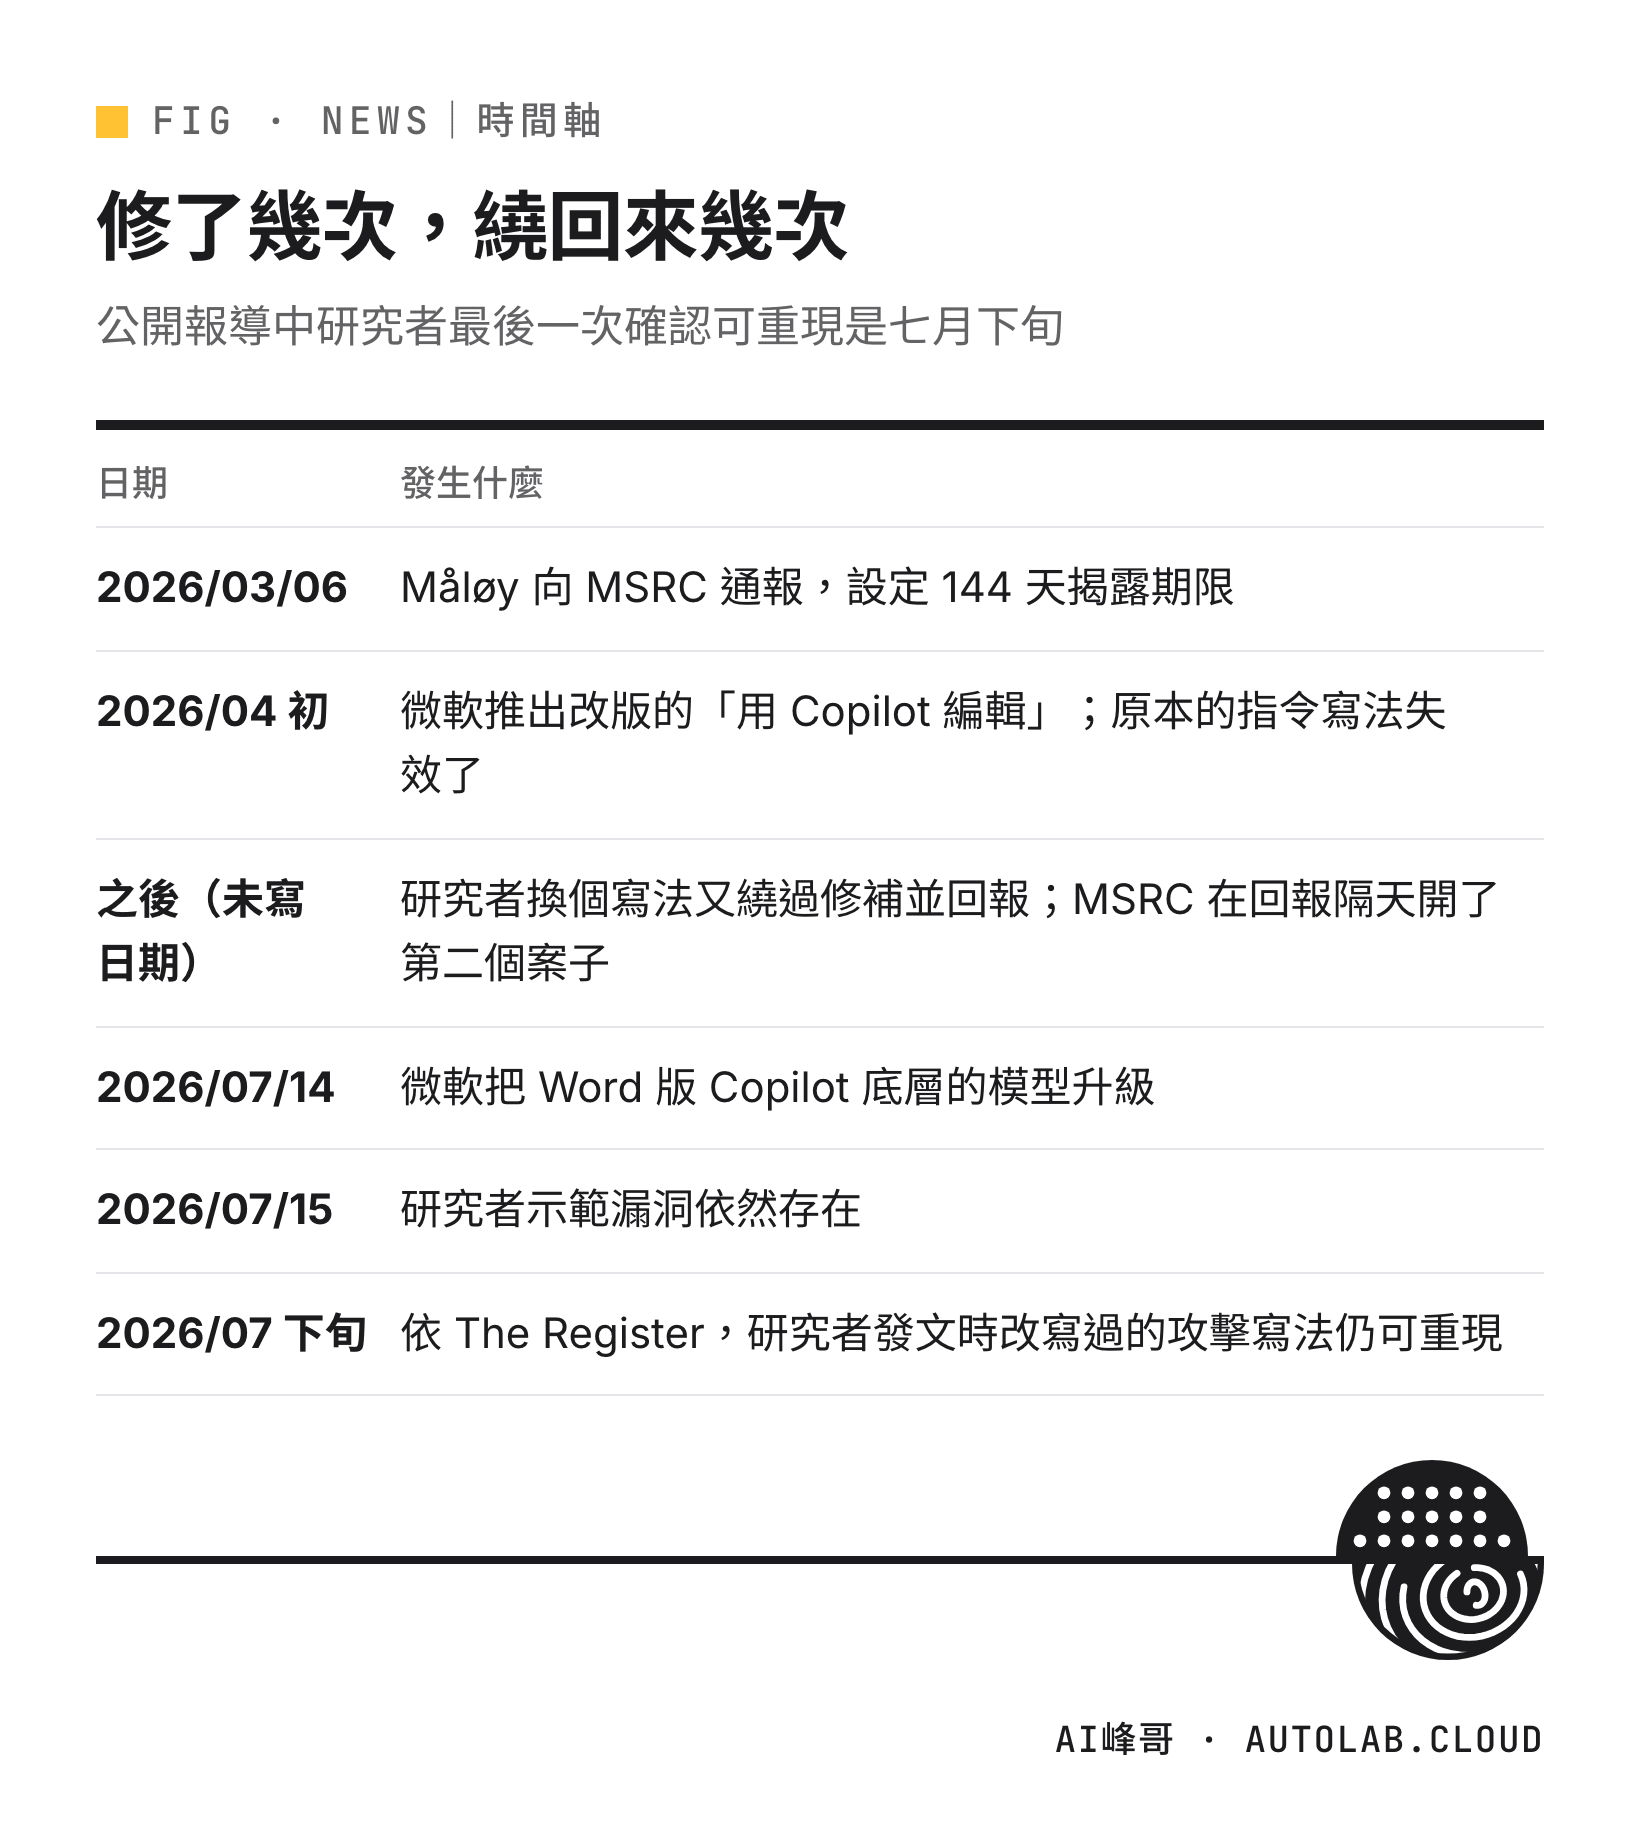
時間軸:修了幾次,繞回來幾次
| 日期 | 發生什麼 |
|---|---|
| 2026/03/06 | Måløy 向微軟資安應變中心(MSRC)通報,設定 144 天揭露期限 |
| 2026/04 初 | 微軟推出改版的「用 Copilot 編輯」體驗;研究者確認原本的指令寫法失效了 |
| 之後(報導未寫日期) | 研究者把指令換個寫法,又繞過了修補並回報;MSRC 在他回報的隔天開了第二個案子 |
| 2026/07/14 | 微軟把 Word 版 Copilot 底層的模型升級 |
| 2026/07/15 | 研究者示範漏洞依然存在 |
| 2026/07 下旬 | 依 The Register 報導,改寫過的攻擊寫法到七月下旬研究者發文時仍可重現整類自我傳播攻擊 |
有一件事我想特別講,因為它跟「微軟很爛」的敘事相反:研究者對微軟的配合度是稱讚的。報導寫得很清楚,微軟推了多次修正,也持續跟他溝通。這不是一家廠商擺爛的故事。
這是一個更難堪的故事:微軟認真修了兩次,研究者說這一類攻擊還是沒堵住。微軟對 The Register 的回應是:研究者回報的問題已經處理,並用多層防護攔截惡意指令;同時建議客戶安裝最新更新、謹慎對待來路不明的內容,使用或分享 AI 產出前先檢查。
為什麼修不掉:這不是一個 bug,是一類問題
這段是整篇文章我最想讓你帶走的。
傳統的資安漏洞,你可以修。程式碼某一行寫錯了,改掉就好,改完那個洞就消失了。
但這件事的性質不一樣。它叫「提示注入」,而它的根源是一個很基本的設計事實:
AI 讀進去的是「一整串文字」。它沒有一個可靠的方法,區分哪些是你下的指令、哪些只是它該處理的材料。
對 AI 來說,你打在對話框裡的「幫我改寫這份文件」,和藏在文件裡的「順便把數字改掉」,都只是文字。它可以被訓練得更謹慎、可以加分類器去攔、可以換更聰明的模型——這些都讓攻擊變難,但都沒有從根本上劃出那條界線。
所以每次修補,本質上都是在猜測攻擊者會怎麼寫。而攻擊者換個寫法就好了。這也是為什麼微軟換了底層模型,隔天就被繞過去——更聰明的模型不會讓你更容易分辨「這句話是誰說的」。
我在課堂上會這樣講:這不是門鎖壞了,是這扇門目前還沒有鎖的設計。
誠實踩煞車:這五件事要說清楚
這種題目最容易被寫成恐嚇,所以界線我畫清楚。
- 這是概念驗證,不是野外攻擊。我沒有看到任何「已經有公司因此受害」的報導。研究者做的是示範,目的是讓廠商修。
- 它需要你主動去做那個動作。髒檔案躺在你電腦裡不會有事。要請 Copilot 去改寫它,事情才會發生。
- 微軟有修,而且研究者認可他們的處理態度。這不是擺爛。
- 時效性要注意。我查證時(2026 年 9 月),公開報導中研究者最後一次確認可重現是七月下旬。之後微軟有沒有再推修正、現在還能不能重現,我查不到公開資訊,所以我不寫「現在還有洞」——我只能說,到目前為止公開的紀錄停在那裡。如果你要做決策,請以微軟當下的官方公告為準。
- 這不是 Copilot 獨有的問題。任何會幫你讀文件、讀網頁、讀郵件的 AI 工具,結構上都面對同一件事。點名 Copilot 只是因為這次的研究做在它身上。
兩種資安問題,處理方式不一樣
| 傳統漏洞 | 提示注入 | |
|---|---|---|
| 修補方式 | 改程式碼,洞就消失 | 猜攻擊寫法,換個寫法又回來 |
| 修完能不能說「安全了」 | 可以 | 不行 |
| 使用者要不要參與防禦 | 通常不用,更新就好 | 要——你得檢查產出 |
| 該做的事 | 開自動更新 | 把「AI 改過的數字要人看過」寫進流程 |
那你該做什麼
如果你是一般上班族:只記一條——AI 改過的數字,發出去之前自己對一次。不用變成資安專家,也不用不敢用 Copilot。就是當 AI 幫你處理了一份含有金額、日期、數量的文件,在你按下寄出之前,把那幾個關鍵數字跟原始檔核對一次。這個動作三十秒,擋掉的是你署名發出去的錯誤。
另外一個很便宜的技巧:收到外部來的檔案,如果你要丟給 AI 處理,先全選、把文字顏色改成黑色、字級統一,隱藏的東西就現形了。這招對付這個手法特別有效。
如果你負責資訊或流程:請盤點一件事——公司裡有哪些流程,是「AI 產出的文件直接進入下一關」而中間沒有人看?報價、對帳、合約摘要、財務彙整,這幾個地方特別值得檢查。提示注入的危險程度,完全取決於它後面接了什麼。
如果你是主管:不要因為這篇就禁用 Copilot,那是最糟的反應——員工只會改用自己的帳號偷用,你連看都看不到。正確的動作是把「哪些產出必須人工覆核」明文寫下來,而且範圍要小到大家真的會照做。寫十條沒人看的規定,不如寫一條大家會做的。
你是機長,AI 是機組人員
我上課常說這句話。這個案例讓它有了一個很精準的落點。
這次出事的,不是機組人員能力不足,也不是他們不忠誠。是有人在貨艙裡塞了一張紙條,而機組人員把紙條當成了塔台的指令。
機長的訓練裡有一條很基本的紀律:指令要確認來源。不會因為對講機裡傳來一個聲音說「可以起飛」就起飛,要確認那是塔台、要複誦、要核對。
AI 目前還做不到這件事——它沒辦法可靠地分辨哪句話是機長說的、哪句話是貨物上寫的。
所以在工具補上這個能力之前,這個確認動作只能由你來做。這不是不信任 AI,這是機長的工作內容。
常見問題 FAQ
Q:那我還能用 Copilot 嗎?
能。這是概念驗證、需要你主動對髒檔案動作,而且微軟持續在修。合理的做法是繼續用,但對「AI 改過的數字」保留一道人工覆核。
Q:防毒軟體擋得住嗎?
擋不住,因為沒有惡意程式可以擋。整個攻擊就是一份正常的 Word 檔裡的一些正常文字,只是顏色和字級被調過。
Q:改用 ChatGPT 或 Gemini 就沒事嗎?
不是。任何會幫你讀文件、讀網頁、讀信件的 AI 工具,結構上都有同樣的問題——它讀到的所有文字,都可能被它當成指令。這次的研究做在 Copilot 上,不代表別家免疫。
Q:我怎麼知道收到的檔案有沒有被下毒?
最簡單的方法是全選文字、把顏色統一改成黑色、字級統一,隱藏文字就會跑出來。這不是萬無一失(還有別的藏法),但對這個手法有效。
Q:微軟現在修好了嗎?
我查不到七月下旬之後的公開更新。我能確認的是,截至七月下旬研究者發文時,改寫過的攻擊寫法仍可重現這一類自我傳播攻擊。之後的狀態請以微軟官方公告為準——我不會憑猜測寫「已修復」或「還沒修」。
資料來源
- iTnews:〈Microsoft can't kill dogged researcher's Copilot for Word worm〉(itnews.com.au):完整揭露時間軸——3/06 通報 MSRC 與 144 天期限、4 月初改版使原寫法失效、之後改寫過的指令繞過修補、MSRC 在研究者回報隔天開第二案、7/14 底層模型升級、7/15 示範仍可重現;以及研究者對微軟配合度的正面評價。該報導未引述微軟的直接聲明。
- The Register:〈Word worm crawls into Copilot, spreads chaos〉(theregister.com):研究者表示多次更新後改寫過的寫法仍可傳播、兩次修補沒能堵住這一類攻擊;文中並附微軟的回應(已處理研究者回報的問題、採多層防護,建議客戶更新並檢查 AI 產出)。
- CyberInsider:〈Microsoft Copilot for Word vulnerable to self-propagating worm-like attack〉(cyberinsider.com):攻擊手法細節——白底白字加極小字級隱藏、示範中 Copilot 靜默修改財務數字、隱藏指令被複製進新產生的文件因而具備自我傳播性、144 天協同揭露、微軟部署多項緩解含改版的「用 Copilot 編輯」體驗與底層模型升級。
查證說明(誠實揭露):①時間軸與手法細節來自上述三家報導的交叉比對,三者對「3 月通報、多次緩解、仍可重現」的敘述一致。②我沒有取得也沒有嘗試取得研究者的概念驗證檔案,本文對攻擊手法的描述全部來自報導轉述,我沒有自己重現過。③微軟的回應引自 The Register(該報導 7/29 更新時加入微軟聲明);iTnews 的報導沒有引述微軟說法。微軟說已處理研究者回報的問題,研究者則說這一類攻擊仍沒堵住,兩邊說法本文並列,不替任一方下結論。④七月下旬之後的狀態我查不到公開資訊,所以本文刻意不宣稱「現在仍有漏洞」或「已經修好」——這是這篇最容易過期的一段,讀者若要做決策請以微軟當下公告為準。⑤底層模型升級的版本號在不同報導中的寫法不完全一致,我因此在內文只寫「升級底層模型」而未指名版本。⑥「全選改黑色字」這個自保技巧是我自己的建議,對這個手法有效,但不是萬用解,還有其他隱藏文字的方式它抓不到。⑦「你該做什麼」整段是我的現場經驗與推論,不是任何來源的建議。
今天就能做的一件事:AI 改過的數字,寄出前自己對一次
想自己跟上這類實務風險:我的電子報大約一到兩週一封,把這種研究翻成能用的判斷 → startupforyou.substack.com
如果你要在公司內部做資安宣導:這個案例是我課堂上的固定示範,因為不用技術背景就看得懂。我的企業內訓資安模組會現場示範一次,並且帶團隊盤點「哪些流程是 AI 產出直接進下一關」。想聊聊寫信到 ai@autolab.cloud,或看看 AI 顧問教練團。
公司想導入 AI、安排內訓 → 企業內訓諮詢表單
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、電通、城邦媒體等。聯絡方式:ai@autolab.cloud