一句話結論
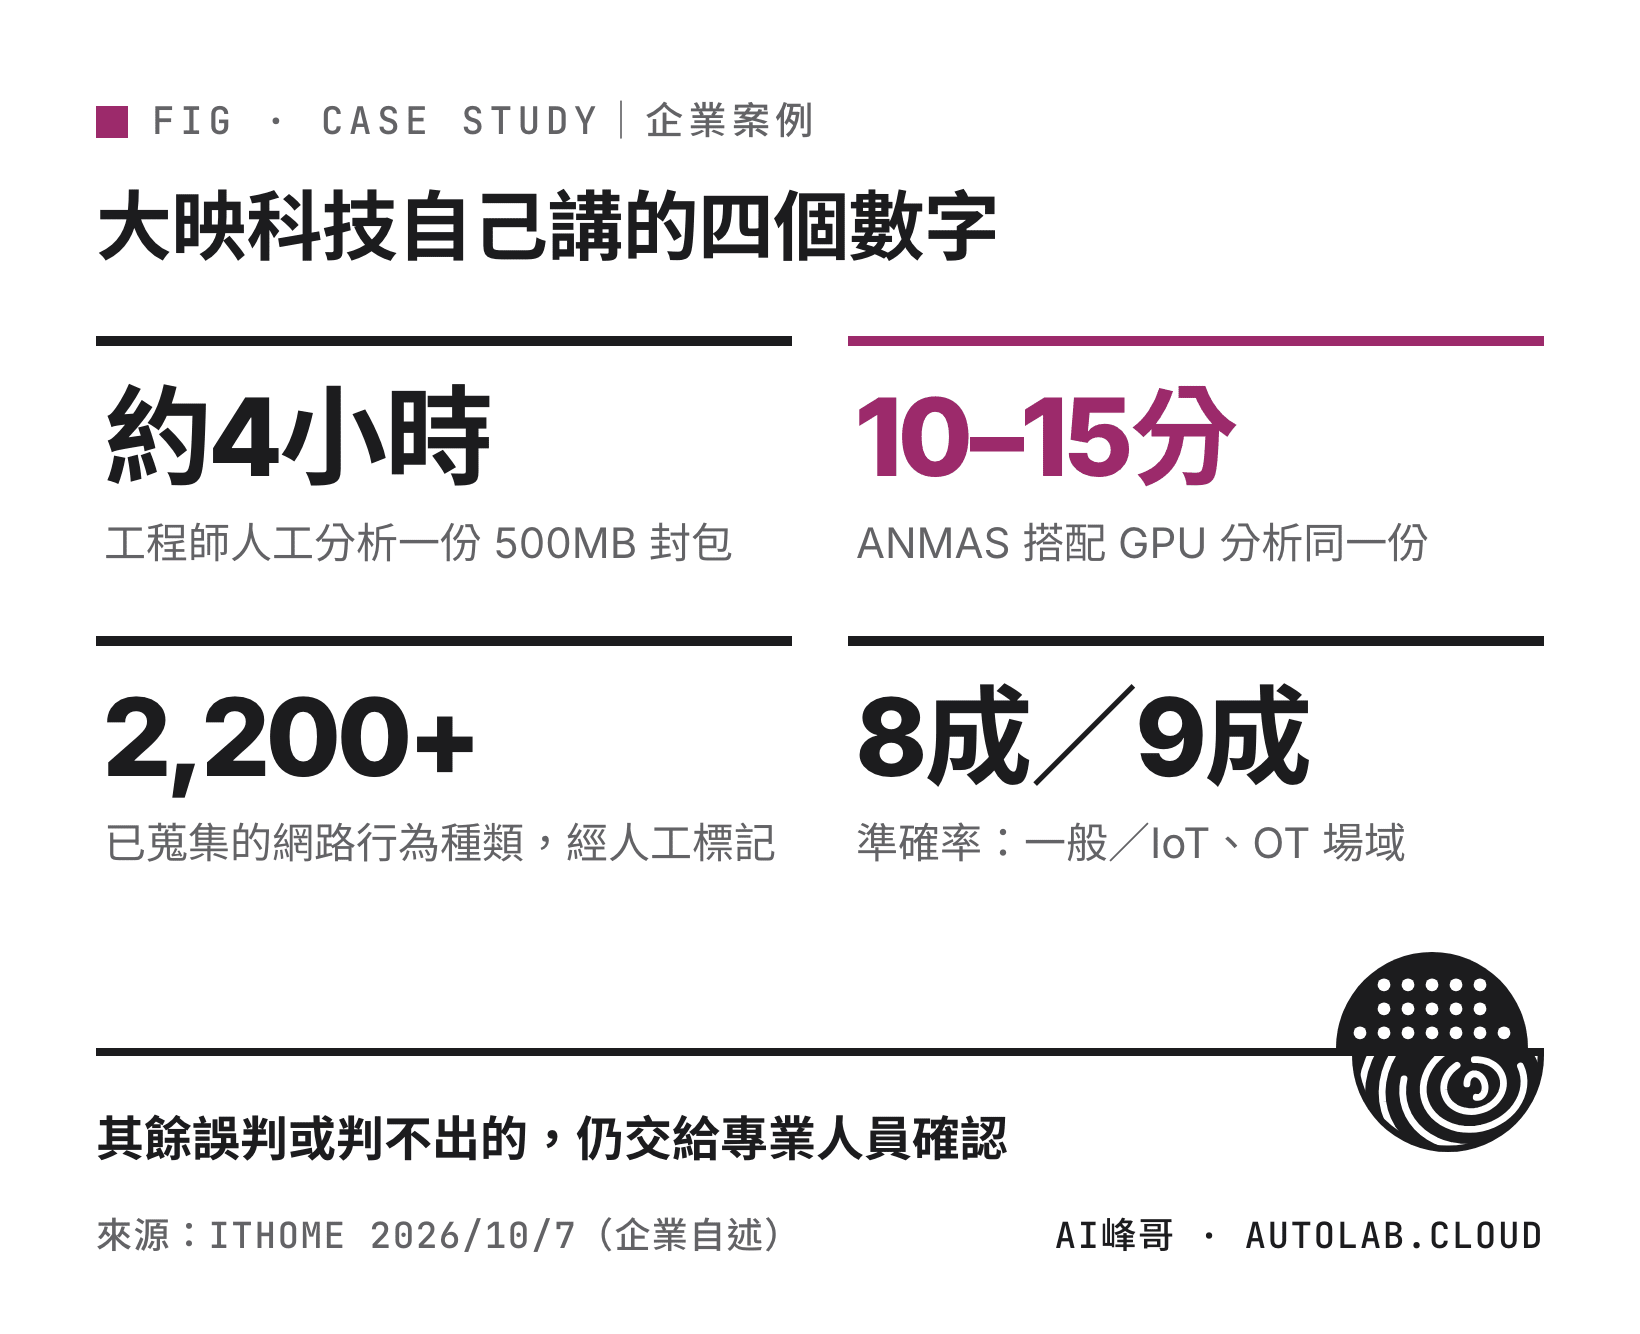
大映科技說,一份 500MB 的網路封包,工程師人工分析大約 4 小時,交給他們的 AI 系統 ANMAS 搭配 GPU 跑,約 10 到 15 分鐘。但這個案例真正值得抄的不是「AI 好快」,而是他們先把工作拆成五段,只把「照特徵比對、初步分類」那一段交給 AI,判不準的、最後拍板的、把經驗寫回去的,都還是人。任何部門只要有「看一大堆紀錄找異常」的工作,都能照這個拆法試一次。提醒一句:省時數字是公司自己在發表會前後講的,目前沒有第三方驗證。
你公司裡的監視器、門禁、會議室螢幕這些連網設備,每天都在對外「講話」,講給誰聽會被記成一種紀錄,叫做網路封包。資安工程師的工作之一,就是一筆一筆看有沒有哪台設備偷偷連去不該連的地方。
這件事很花時間。2026 年 10 月 7 日 iThome 記者羅正漢的報導裡,大映科技總經理劉得民舉了一個例子:一份 500MB 的封包擷取檔(PCAP),人工分析大約要 4 小時;資料量到數十 GB,人工一天也未必做得完。而他說,以百人規模的企業來看,每小時就可能產生數十 GB 的封包。
換句話說,不是工程師不夠努力,是這個量本來就不是人看得完的。這個處境,我在企業內訓現場很常聽到,只是換了名字:客服紀錄看不完、報帳單據對不完、系統日誌沒人看。
先說清楚:這是一個產品,不是一份導入成果報告
iThome 的標題寫「大映科技運用 AI 加速 IoT 網路封包分析」,很容易讓人以為是某家公司內部導入 AI、然後交出成績單。仔細讀原文,比較準確的說法是:大映科技是做這套系統的公司,ANMAS 是他們的產品,這些數字是總經理劉得民在介紹自家產品、以及 10 月 5 日一場與 SGS 台灣檢驗科技合辦的發表會後接受 iThome 追問時講的。
這不代表數字是假的,但這是廠商對自己產品的說法,不是客戶端量出來的結果。我還是選它來拆,因為報導把「AI 做哪段、人做哪段」講得比大部分案例都清楚。
背景補幾句:依 iThome 同日另一篇報導,大映從 2020 年開始投入這項技術研究,2025 年完成產品開發、先推雲端版,今年再推出地端版(裝在企業自己機房裡的版本)。
他們把一份工作拆成五段
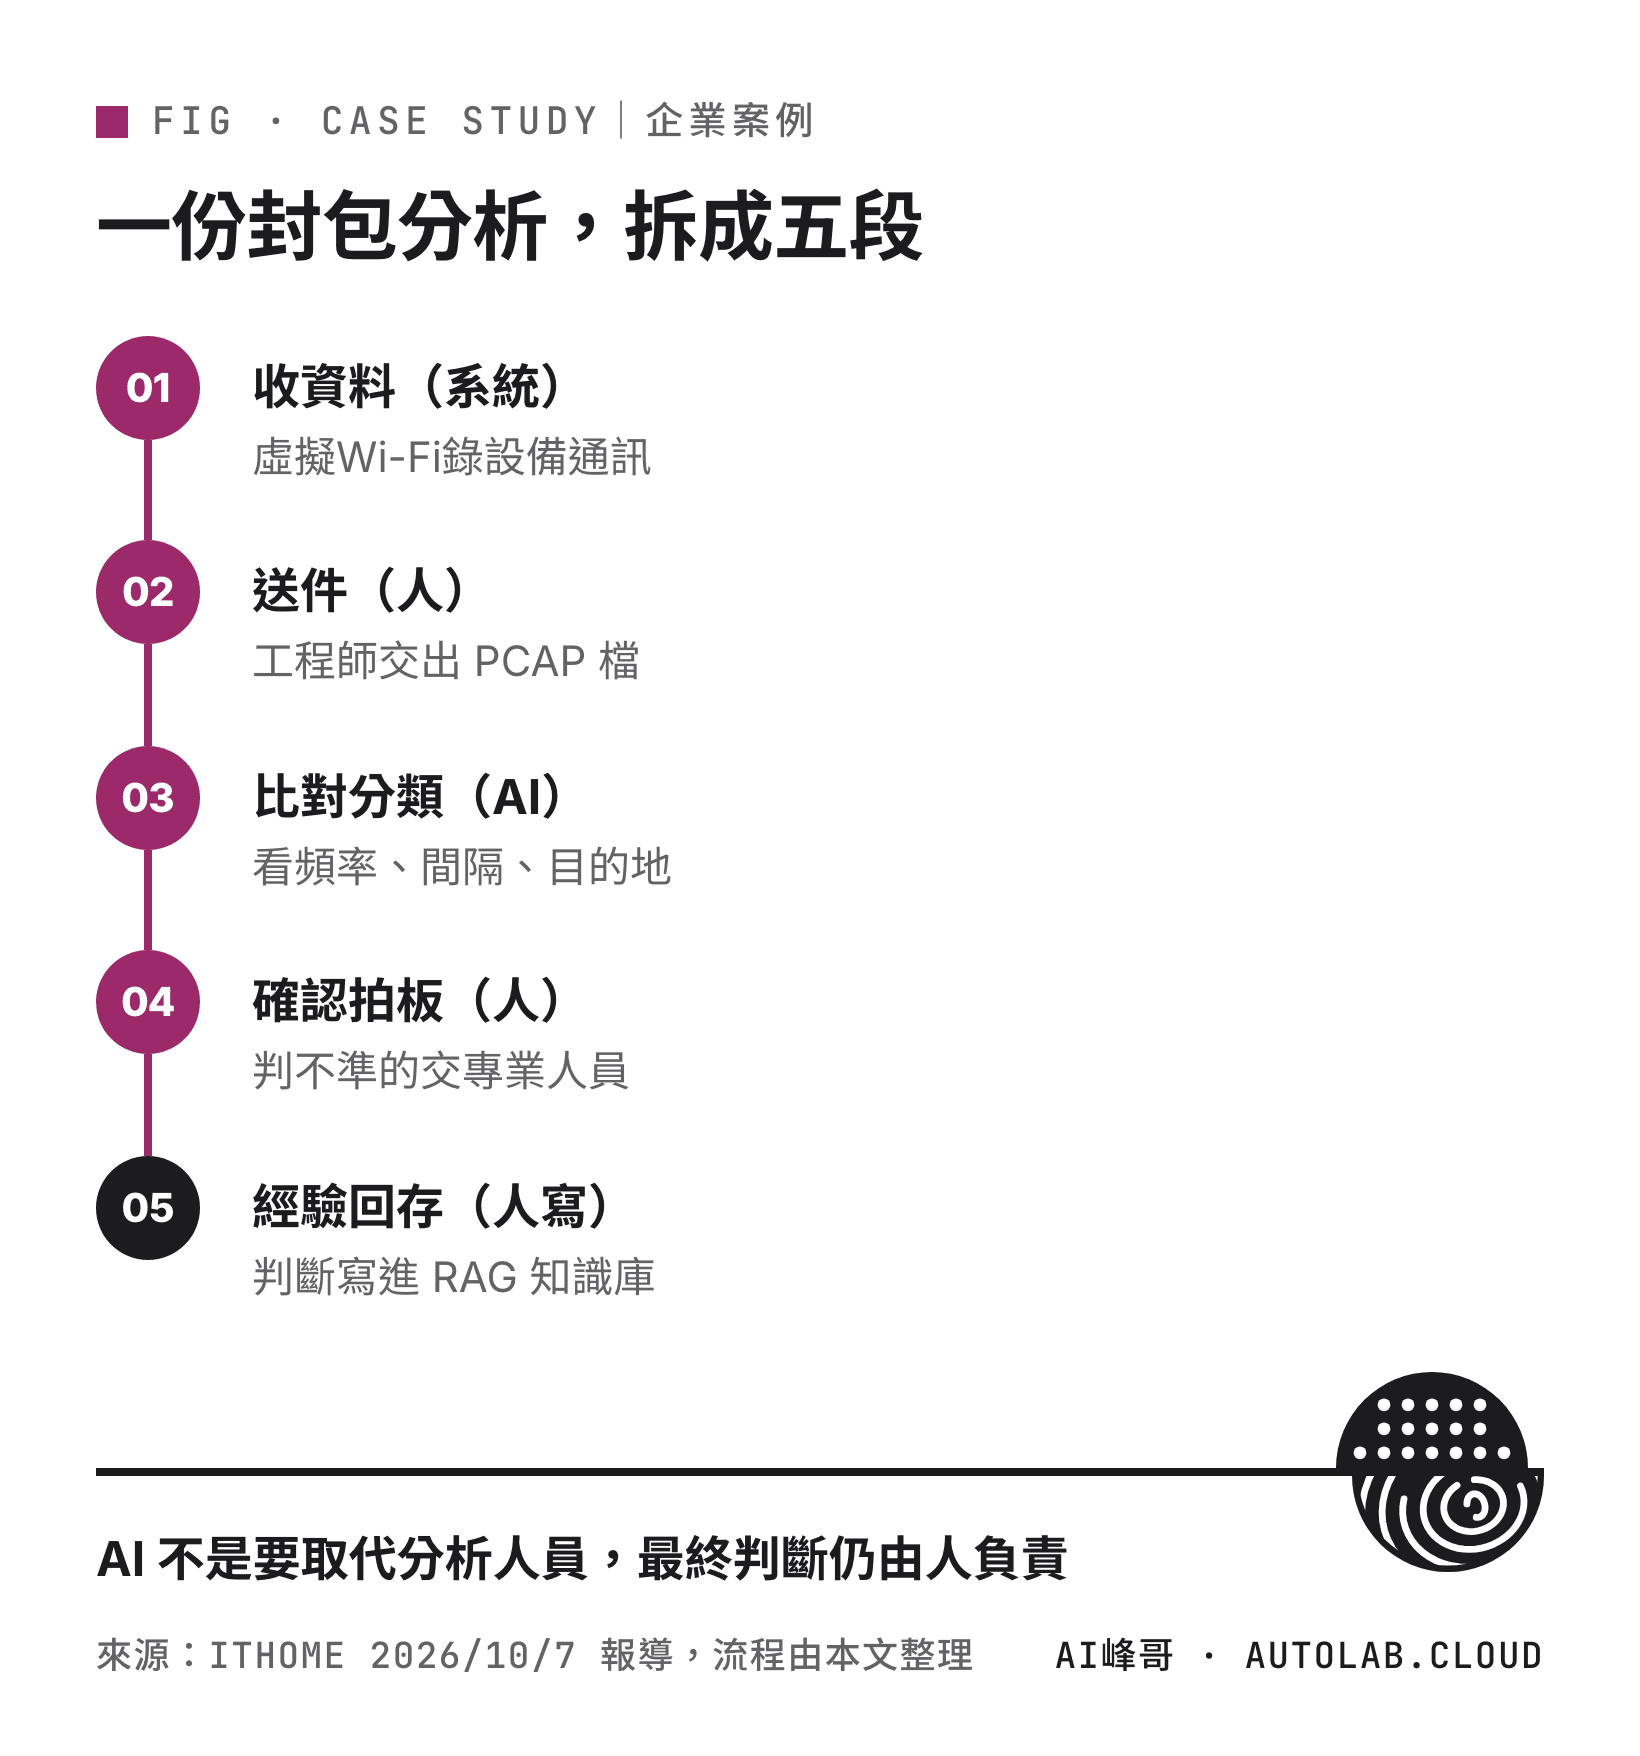
我把報導裡的流程整理成五段。重點不在技術名詞,在每一段是誰做:
第一段,收資料(系統):用一個虛擬的 Wi-Fi 環境,把受測設備對外的通訊錄下來。
第二段,送件(人):由工程師把錄好的封包檔案交給系統。也就是說,「要分析哪一批」還是人決定。
第三段,比對與分類(AI):AI 不去解開加密的內容,而是看行為特徵——連線多頻繁、間隔多久、連去哪裡。劉得民舉的例子是:惡意程式為了跟幕後的控制伺服器保持聯繫,通常會定期發出一種「我還活著」的訊號;就算攻擊者故意把間隔打亂,還是常會落在一個範圍內,有一定的規律,這就成了 AI 抓異常的線索。依廠商新聞稿,系統也會整理出分析報告。
第四段,確認(人):依劉得民的說法,ANMAS 在一般場域的辨識準確率約 8 成,在 IoT、OT(工廠設備)場域可達 9 成;其餘可能誤判或判不出來的,仍要交給專業人員確認。他說得很直接:AI 不是要取代分析人員,最終判斷仍由人負責。
第五段,經驗回存(人+系統):工程師可以把自己的分析經驗、判斷結果,寫進系統的知識庫(技術上叫 RAG,你可以想成「AI 每次判讀前會先翻的那本公司筆記」)。分析越多,筆記越厚,越貼近這家公司自己的網路環境。
4 小時變 10 幾分鐘,前面其實墊了好幾年
劉得民說,團隊目前已蒐集超過 2,200 種網路行為,包含一般網路服務,也包含病毒、後門程式的活動。每一種行為都蒐集多份 10MB 以上的封包資料,經過人工清理、去識別化與標記之後,才拿去訓練模型。
翻成白話:AI 之所以能在 15 分鐘內說出「這個看起來像後門」,是因為之前有人花了很長時間,把 2,200 多種「什麼長得像什麼」一筆一筆整理好、貼好標籤。快的是最後那一段,前面那一段一點都不快。
這也是我在企業內訓裡最常提醒的事:大家看案例只看終點的速度,沒看到起點的整理。你部門想複製「AI 幫我篩異常」,第一個要問的不是用哪個工具,而是——我們有沒有一份整理好的「正常長怎樣、異常長怎樣」?
換成你的部門:「看大量紀錄找異常」的拆法
封包分析是很專業的工作,但它的工作形狀,跟很多非技術部門其實一模一樣:資料量大、大部分正常、要找出少數幾筆不對勁的。
客服想從幾千筆客訴裡找出可能鬧大的;財務想先抓出金額、廠商或時間點怪怪的單據;業務想在 CRM 裡找出互動突然變少的客戶。形狀都一樣。
照大映的五段拆法,換成「客服紀錄」大概長這樣:
先寫判準:拿過去真的鬧大的 20 到 30 筆客訴,整理成「這種寫法、這種頻率、這種字眼,後來都變成大事」。這就是你們版本的 2,200 種行為,只是小很多。
人決定送哪一批:不是整個資料庫丟給 AI,是你挑這個月、這個產品線的紀錄。
AI 做第一輪分類:用公司核准的 ChatGPT、Claude、Gemini 或 Copilot,把判準貼進去,請它把每筆紀錄分成「正常/要注意/判不準」三類,而且每一筆都要寫出它依據哪一句話。
人看「要注意」和「判不準」:這才是你的時間該花的地方。大映自己說 8 到 9 成準,你的版本一開始一定沒那麼準,所以這段絕對不能省。
把判斷寫回判準:每次人看完,有新的「原來這種也算」,就補進那份判準。下個月 AI 讀到的就是更新過的版本。
你會發現,五段裡只有一段是 AI 的。但就是這一段,把你從「一千筆全部看」變成「看那幾十筆可疑的」。
誠實踩煞車
第一,省時數字是廠商自述,沒有第三方驗證。4 小時、10 到 15 分鐘、8 成和 9 成準確率,全部出自劉得民介紹產品與會後受訪時的說法,經 iThome 記者轉述。我查不到獨立的測試報告,也查不到大映科技的官網或產品頁可以對照。
第二,同一組數字,轉述一次就變了。今周刊刊出的版本(標示由 SGS 提供、整合傳播企劃製作,屬於廠商供稿)寫成「縮短至 15 分鐘內」,還寫「企業一天產生的封包高達數十 GB」;iThome 寫的是「約 10 至 15 分鐘」、「百人規模企業每小時就可能產生數十 GB」。一個是每天、一個是每小時,差了 24 倍。本文一律以 iThome 記者採訪的版本為準。
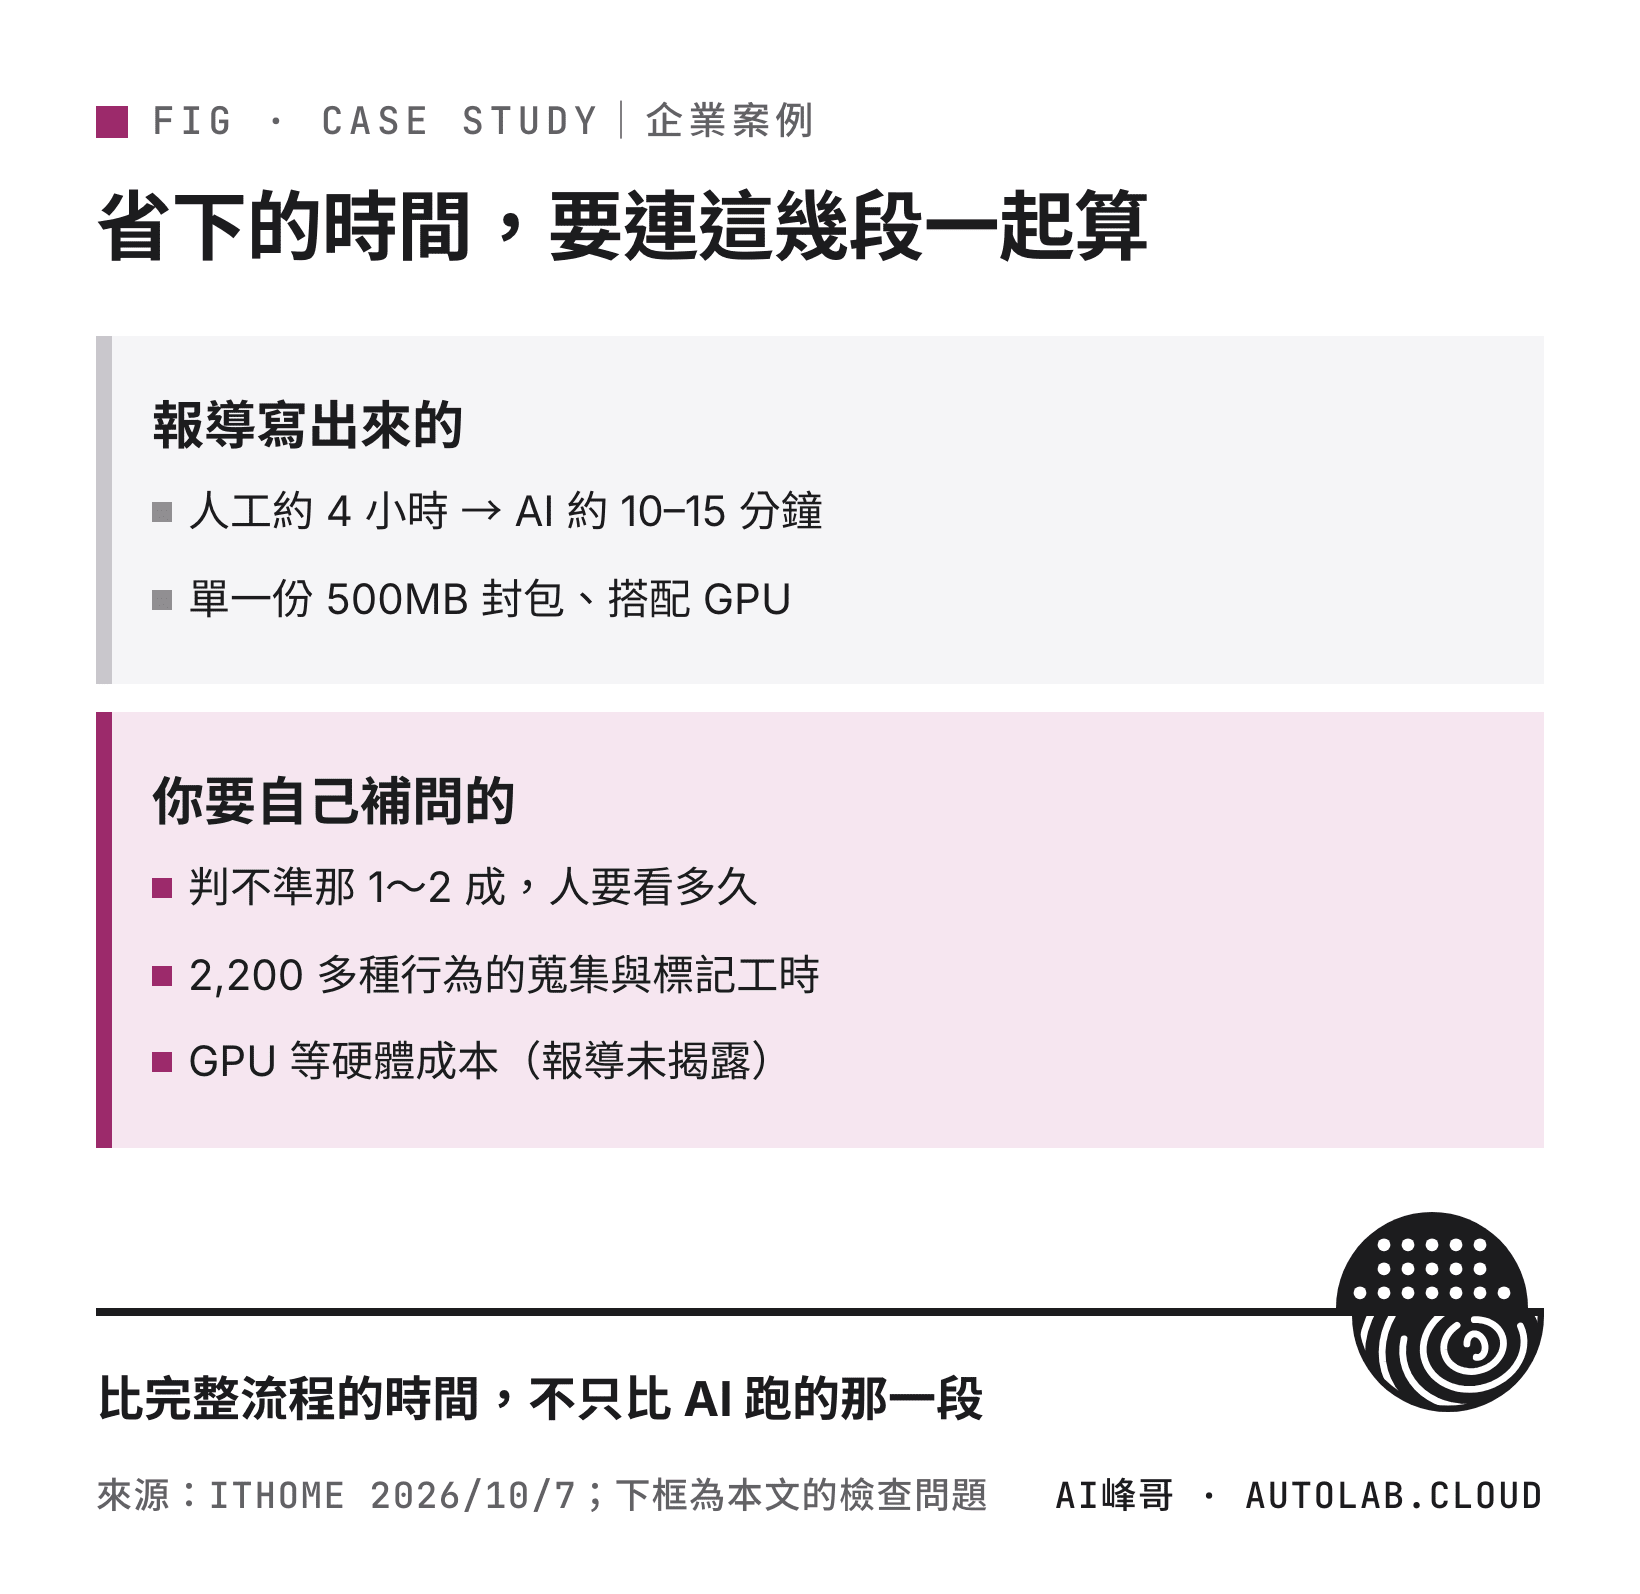
第三,「省下的時間」怎麼算才算數?4 小時比 15 分鐘,比的是「一份檔案從頭看到尾」對「AI 跑完一輪」。但 AI 跑完之後,那 1 到 2 成判不準的還要人看;前面 2,200 種行為的蒐集和標記也是人力;GPU 硬體也是成本。報導沒有給這些數字,我也不替它算。省時數字背後藏了哪些假設,我在另一篇拆 OpenAI 報酬率 245% 的文章裡會細講。
第四,「準確率 8 成」沒有定義怎麼量。是 10 筆異常抓到 8 筆?還是 AI 說有問題的 10 筆裡 8 筆真的有問題?這兩種差很多,報導沒有說明。
第五,有人確認,不等於一定擋得住。Anthropic 做過一個 1,053 人的實測,人工複核擋下的問題比例遠低於大家想像(我寫過那篇,放在延伸閱讀)。所以「交給專業人員確認」那一段,要給確認的人足夠的時間和原始資料,不能只是按同意。
第六,不適用的情況:如果你的異常一年才出現一兩次、沒有過去的案例可以整理,這套拆法很難起步,因為 AI 沒有東西可以比對。另外,客戶個資、內部財務資料,不要貼進個人帳號的 AI——大映會特別推地端版,原因之一就是報導裡提到的機敏資料外傳疑慮。
| 工作段落 | 大映 ANMAS 怎麼分 | 換成客服紀錄 | 誰負責 |
|---|---|---|---|
| 事前準備 | 2,200 多種行為,人工清理、去識別化、標記 | 整理 20~30 筆過去鬧大的案例成判準 | 人 |
| 送件 | 工程師把封包檔交給系統 | 挑這個月、這條產品線的紀錄 | 人 |
| 第一輪比對 | 看頻率、間隔、目的地,不解密內容 | 分成正常/要注意/判不準,附依據 | AI |
| 確認與拍板 | 誤判或判不出的交專業人員 | 主管或資深同事看可疑那幾十筆 | 人 |
| 經驗回存 | 判斷結果寫進 RAG 知識庫 | 新發現補進判準文件 | 人寫、AI 讀 |
所以你該做什麼
如果你是一般上班族:這週挑一個你最常「整份看完才找到一兩筆有問題」的工作。先別急著丟給 AI,花 30 分鐘寫下:過去那些有問題的,長什麼樣子?寫得出來,這件事就能試;寫不出來,代表連你自己都還說不清判準,AI 更不可能替你說清楚。
如果你是要量產、經常處理大量紀錄的人:把「AI 第一輪分類」做成固定格式:每筆一定要有分類、依據的原文、信心程度三個欄位。然後記錄兩件事:AI 說正常、結果其實有問題的有幾筆;AI 判不準、要人看的有幾筆。這兩個數字才是你自己的「準確率」,比任何廠商的 8 成、9 成都可靠。
如果你是主管:大映案例裡最值得帶回去的,其實是「經驗傳承」那段。問自己一句:我們部門最資深的那個人明天離職,他判斷異常的直覺,有寫在任何地方嗎?如果沒有,導入 AI 的第一步不是買工具,是請他把判準寫下來。那份文件就是你們版本的知識庫,有沒有 AI 都用得上。
你是機長,AI 是機組人員
大型客機上有一堆自動警示系統,會在幾秒內告訴機長「這裡不對勁」。但哪個警示要立刻處理、哪個可以先放著、哪個其實是感測器誤報,是機長判斷的。而機長能判斷,是因為他看過、練過、記住過很多「上次這種警示,後來是怎樣」。
大映這個案例的分工剛好就是這樣:AI 是那個在 15 分鐘內把可疑的標出來的警示系統;工程師是機長,決定送哪一批、確認判不準的、把這次學到的寫回去。警示系統再快,沒有人把判斷寫回去,它下次也不會更準。
所以下次你看到「AI 把 4 小時縮成 15 分鐘」,先別問那個工具叫什麼。問:那 15 分鐘之後,人做了什麼?
常見問題 FAQ
Q:大映科技的 ANMAS 用的是 ChatGPT 這類大模型嗎?
依 iThome 報導,ANMAS 用的是小型語言模型,搭配微調和 RAG 知識庫,而且有地端版,可以裝在企業自己的環境裡。報導沒有說是哪一家的模型,我也查不到,所以不寫。
Q:4 小時縮到 10 幾分鐘,是不是代表工程師可以少請幾個?
報導裡劉得民自己說,AI 不是要取代分析人員,最終判斷仍由人負責;而且一般場域約 8 成準,其餘要人確認。更準確的說法是:同樣的人,能看的量變大了。至於能不能少請人,報導沒有任何數字支持,我不推論。
Q:我們不是資安部門,這個案例跟我有什麼關係?
關係在工作形狀。只要你的工作是「資料量大、大部分正常、要找出少數不對勁的」,像客服紀錄、報帳單據、CRM 名單、系統日誌,都可以照「先寫判準、AI 做第一輪、人確認、經驗寫回去」這個拆法試。
Q:沒有 2,200 種樣本,我們也能做嗎?
可以從小開始。大映是要做成產品,所以要涵蓋很多情況;你只是要處理自己部門的一種紀錄,20 到 30 筆真實的異常案例就能先試。重點是那份判準要隨著每次確認持續補,而不是一次寫完就不動。
Q:這些數字可以拿去跟老闆提案嗎?
建議不要直接引用當成你們會達到的效果。這些是廠商在發表會前後對自家產品的說法,沒有第三方驗證,而且今周刊和 iThome 的版本還有出入。提案時用你們自己小規模試做的數字,說服力比引用別人的高很多。
資料來源
以下均於 2026 年 10 月 11 日查證:
- iThome:〈大映科技運用AI加速IoT網路封包分析,處理500MB資料量所需時間可從4小時縮至10幾分鐘〉(ithome.com.tw/news/179468,2026 年 10 月 7 日,文/羅正漢):本文主要來源。虛擬 Wi-Fi 擷取流量、工程師送交 PCAP;小型語言模型搭配 Fine-tuning、LoRA、RAG;500MB 人工約 4 小時、搭配 GPU 約 10 至 15 分鐘;百人規模企業每小時可能產生數十 GB;逾 2,200 種網路行為、每種多份 10MB 以上樣本、人工清理去識別化標記後監督式學習;一般場域約 8 成、IoT/OT 約 9 成準確率,其餘交人員確認;不解密、看連線頻率間隔目的地;經驗傳承。以上均為大映科技總經理劉得民的說法。
- iThome:〈從網路封包分析切入,大映科技攜手多家機構拓展IoT網路安全檢測應用〉(ithome.com.tw/news/179466,2026 年 10 月 7 日,文/羅正漢):公司背景。2020 年起投入技術研究、2025 年完成產品開發(雲端版)、今年推出地端版;10 月 5 日發表會;合作對象含 SGS 台灣檢驗科技、精技電腦、資策會資安科技研究所等;預計 2027 年進軍日本市場。
- iThome 廠商新聞稿:〈SGS 台灣檢驗科技攜手大映科技發表 ANMAS〉(ithome.com.tw/pr/179418,2026 年 10 月 6 日):廠商立場。發表會於 10 月 5 日在台北舉行;系統協助整理封包、辨識異常線索並產生分析報告;採本地端 AI 架構以降低機敏資料外傳疑慮。
- 今周刊:〈SGS攜手大映科技發表ANMAS 用AI抓出IoT設備背後的「隱性危機」〉(businesstoday.com.tw,2026 年 10 月 6 日,頁面標示 SGS 提供、整合傳播企劃製作):用來交叉核對。其中寫「15 分鐘內」與「企業一天產生的封包高達數十 GB」,與 iThome 記者版本不同。
查證說明(誠實揭露):①本文的省時、準確率、樣本數等數字,全部出自大映科技總經理在發表會與會後受訪的說法,經 iThome 記者轉述,屬企業自述,我查不到第三方驗證或獨立測試。②大映科技的官方網站與產品頁我沒有查到,公司背景只能依 iThome 報導與廠商新聞稿。今周刊與 iThome 刊登的廠商新聞稿圖說寫「大映科技有限公司」,iThome 記者報導只寫「大映科技」,公司登記全名我未另行核對。③今周刊(廠商供稿)與 iThome 的數字有出入(「15 分鐘內」對「約 10 至 15 分鐘」;「每天數十 GB」對「每小時數十 GB」),本文一律採 iThome 記者採訪版本。④「4 小時」是誰、用什麼工具、分析到什麼深度量出來的,報導沒有說明;「準確率」的計算方式也沒有定義。⑤ANMAS 使用哪一家的語言模型、硬體成本與售價,報導未揭露,我也查不到。⑥文中「換成客服紀錄」的五段拆法、20 到 30 筆案例的建議,是我依案例流程推出來的做法,不是大映的說法,也不代表一定能達到同樣效果。⑦Anthropic 1,053 人實測與本案例無關,只用來對照「人工確認」這個設計的限制。
先拆工作,再找工具
我會持續把台灣企業的 AI 案例拆成「AI 做哪段、人留哪段」:我的電子報大約一到兩週一封 → startupforyou.substack.com
公司想導入 AI、安排內訓 → 企業內訓諮詢表單(課堂上可以直接拿你們部門的紀錄當練習題,練習寫判準、拆分工)
通勤用聽的 → Podcast《下班學AI》
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、中嘉寬頻、電通、城邦媒體等。聯絡方式:ai@autolab.cloud