一句話結論
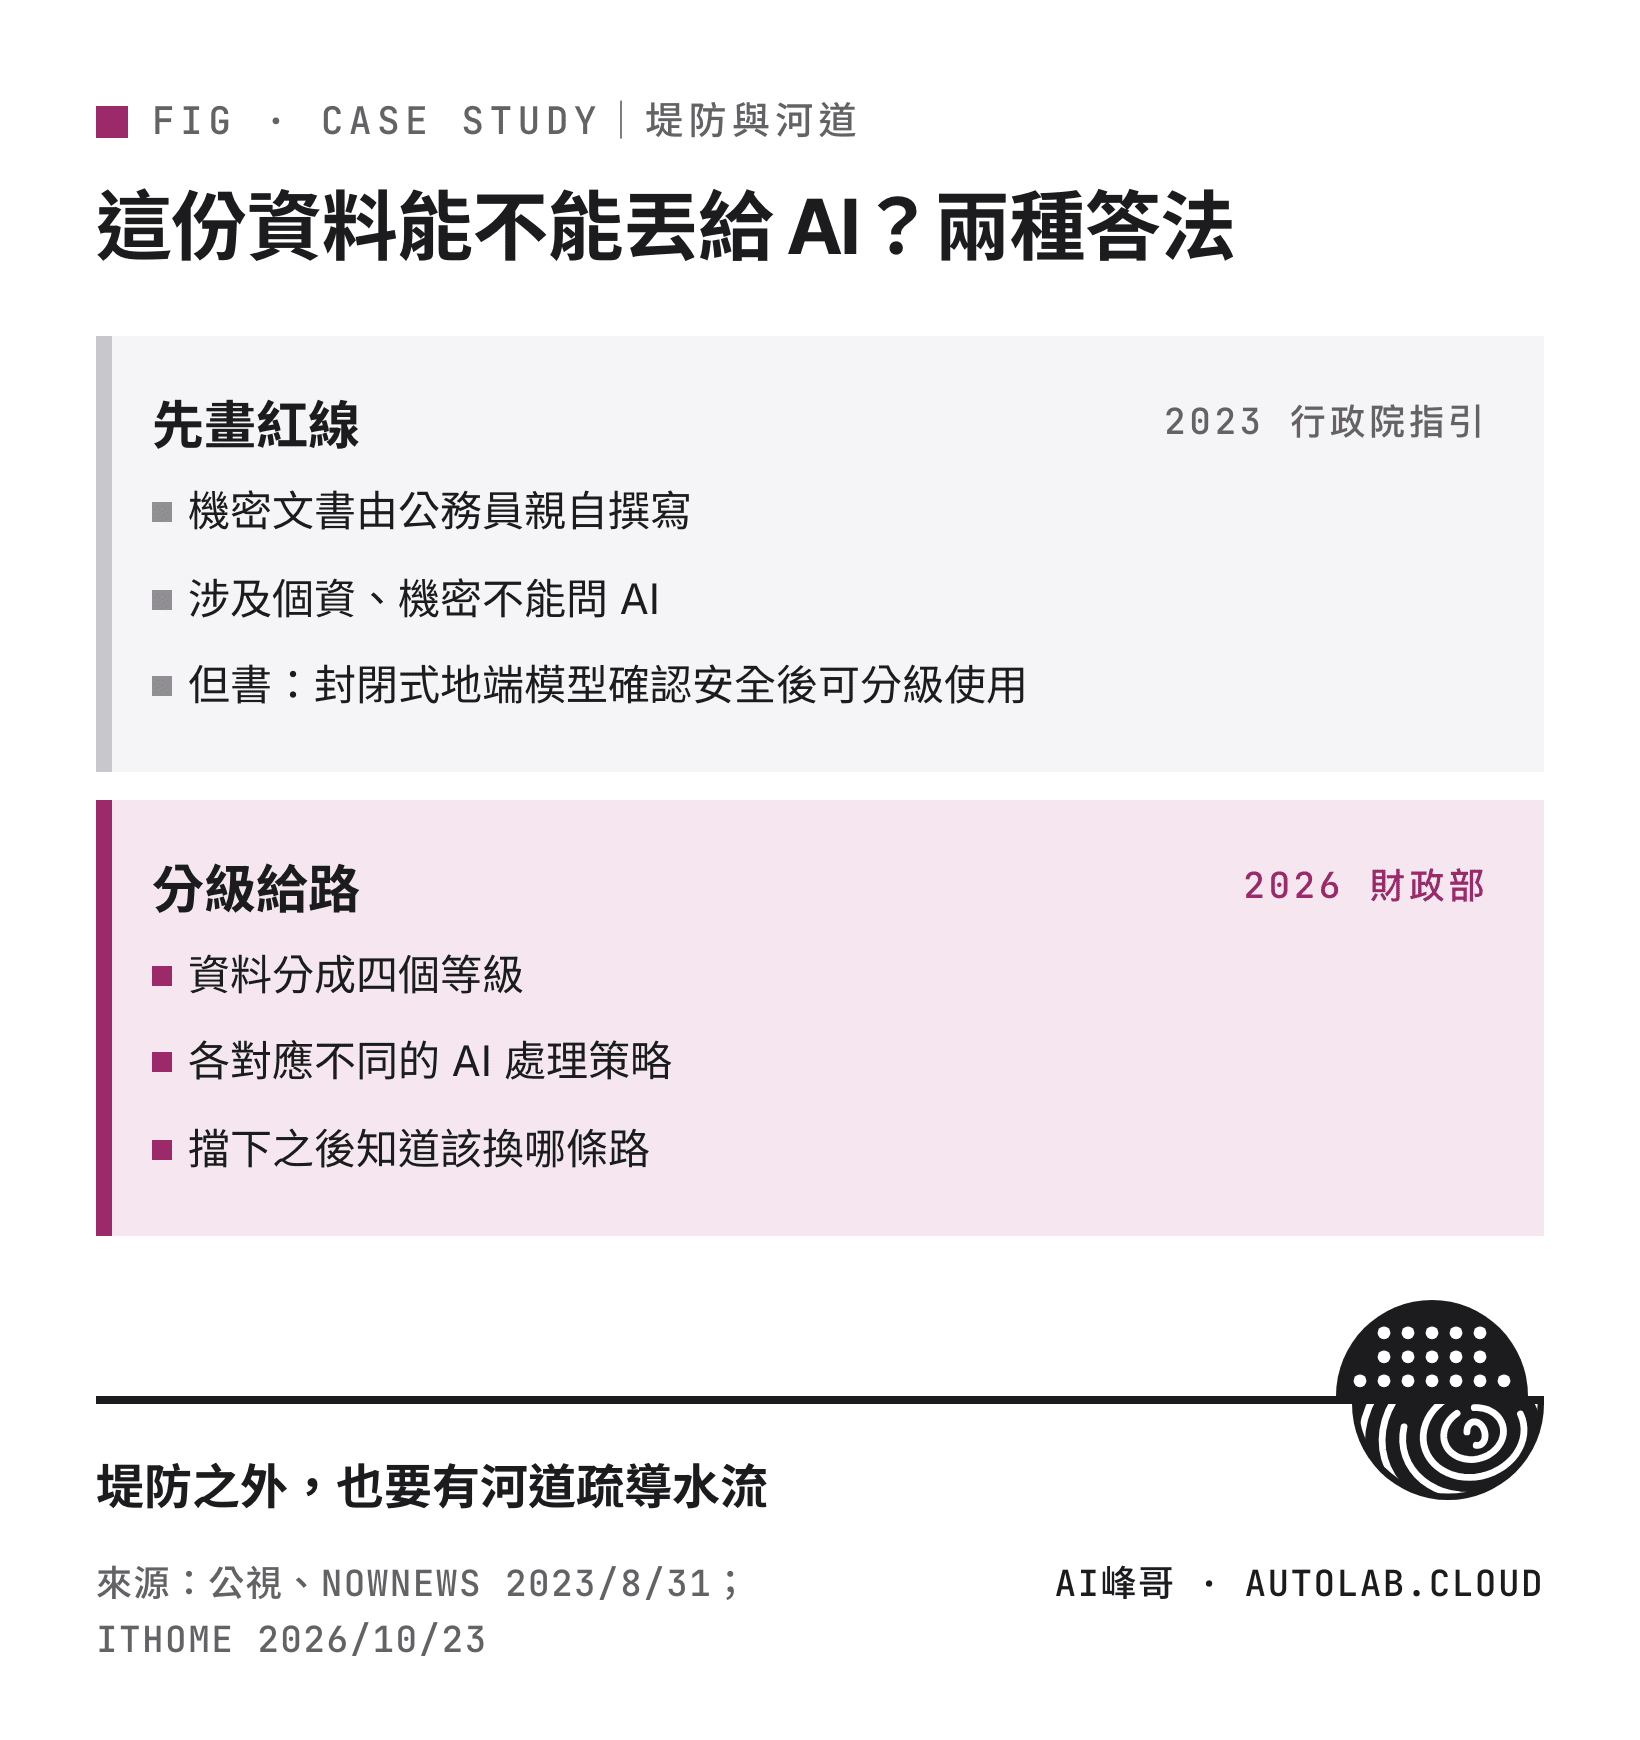
「這份資料能不能丟給 AI?」三年前行政院指引的答法主要是畫一條線:機密的、涉及個資的,不准問(媒體引的條文另有但書,容許封閉式地端模型分級使用)。今年財政部財政資訊中心主任張文熙在數位政府高峰會上,提出另一種答法:把資料分成限制、機敏、內部、公開四級,各對應不同的 AI 處理策略——最敏感的稅籍個資、國庫帳務安排在地端、實體隔離的環境處理,法規和公開統計則可評估使用一般雲端 AI 服務。這套分法不只公部門能用,一般公司照著做,員工就不用每次都猜「這份能不能貼」。
企業導入 AI,最常卡住的不是「要買哪一家」,是一個更基本的問題:
「這份資料,我可以丟給 AI 嗎?」
大部分公司的答案只有兩種。一種是沒有答案,員工自己猜;另一種是「機密的都不准」,然後沒人說得清楚什麼算機密。
財政部的做法是第三種,而且他們手上的資料比你敏感得多——稅籍、國庫帳務、金融資料。連他們都沒有選「一律禁止」,這件事值得一般公司看一下。
三年前的答法:畫一條線
2023 年 8 月 31 日,行政院院會通過(准予備查)「行政院及所屬機關(構)使用生成式 AI 參考指引」草案,之後依程序函頒。公視當天的報導整理了幾個重點:機密文書必須由公務員親自撰寫,涉及個資、機密的問題不能詢問生成式 AI,使用 AI 輔助業務要適當揭露。報導提到,指引主要參考美國、澳洲的政府規範,以負面表列限制事項;「機密文書由公務員親自撰寫」則參考了新加坡經驗。
NOWnews 同一天引的條文還有一段但書:封閉式地端部署的生成式 AI 模型,須確認系統環境安全後,可依機密等級分級使用。也就是說,當年不是完全沒留路。這段來自媒體引述的當天版本,定稿全文我沒有逐條核對。
這在當時是合理的第一步。從公視整理的重點來看,它主要回答的是「哪些不准」。
張文熙在演講裡用了一個比喻,講的是一般防護機制的設計,不是在評行政院指引:防護機制像堤防,可以擋下不適合的輸入;但堤防之外,也要有河道疏導水流。如果系統只會擋,沒有其他路讓使用者把工作做完,導入 AI 的意義就打折了。
今年的答法:分四級,各有處理策略
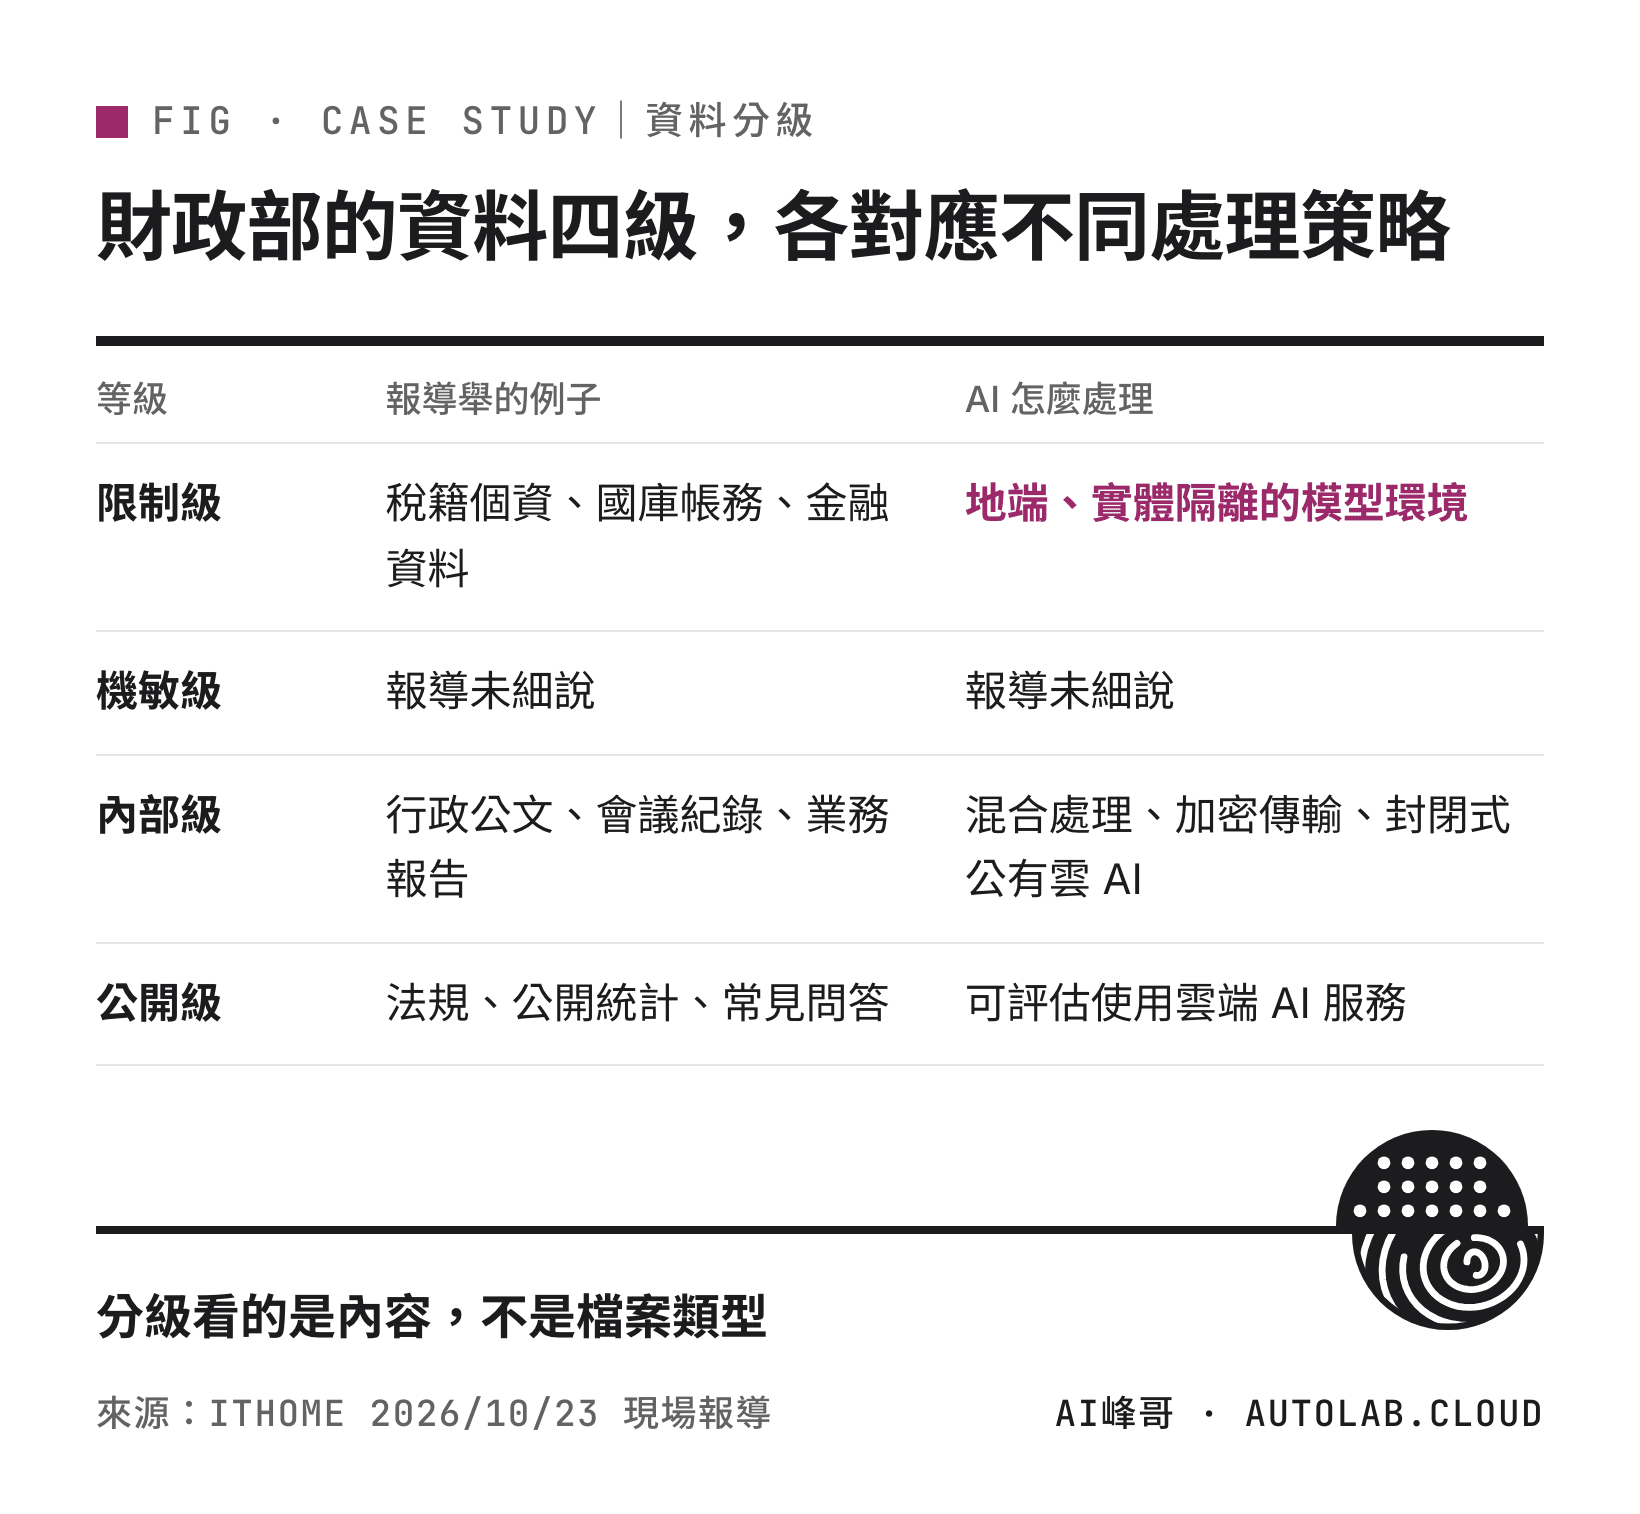
根據 iThome 10 月 23 日的現場報導,財政部把資料分成 4 個等級,各自對應不同的 AI 處理方式:
| 等級 | 報導舉的例子 | AI 怎麼處理 |
|---|---|---|
| 限制級 | 稅籍個資、國庫帳務、金融資料 | 地端、實體隔離的模型環境 |
| 機敏級 | 報導列出這一級,但沒有細說例子與處理方式,所以我不補 | |
| 內部級 | 行政公文、會議紀錄、業務報告 | 混合處理、加密傳輸、封閉式公有雲 AI |
| 公開級 | 法規、公開統計、常見問答 | 可評估使用雲端 AI 服務 |
這張表最值得抄的不是分級本身,是報導裡一個很小的例子:同樣是會議紀錄,不能一概而論。公開的公聽會、說明會,跟還沒對外揭露的談判內容,保密需求完全不同,系統設計就得跟著調。
換成公司的情境:週會紀錄跟併購談判紀錄,檔名可能都叫「會議紀錄」。分級看的是內容,不是檔案類型。
「機房在台灣」不等於安全
選雲端服務時,很多公司常問「你們機房在不在台灣」。張文熙提醒,這不夠。還要弄清楚:
- 哪些資料留在台灣機房
- 這些資料怎麼被處理
- 你能不能接受服務商的管理方式
他也列了部署前要回答的幾個問題:權限能不能限制、過程能不能稽核、推論成本看不看得見、模型版本掌不掌握得住。報導提到,他認為資安的零信任原則(身分驗證、最小權限、持續監控、完整稽核)同樣適用於 AI。
每個 Token 都要花得值得
分級解決「能不能」,接下來是「值不值得」。
張文熙說,使用者付費訂閱 AI 後,往往習慣直接選最強的模型。他舉的例子是寫簡單的 SQL,這種工作可以先評估由個人電腦上的模型處理,結果不符合要求,才考慮能力更強的模型。他的原話是:「我希望每一個 Token 都花在該花的地方。」
所以他們的方向是「模型路由」:不讓每個人自己挑,而是由系統依資料敏感度、任務複雜度、回應速度、預算與工具需求,把工作分派給不同模型。他也提醒,地端模型不是免費的——設備要維護、模型更新後要處理相容性與安全問題,這些都要算進去。
AI 開始做事之後:哪些交給它,哪些留給人
張文熙把語言模型和 AI 代理人(Agent)分成「Thinker」和「Doer」:前者給答案,後者會呼叫工具、自己排步驟去把事情做完。
Doer 自己規畫的路,未必是你想過的路。所以要在執行過程中設控制點,報導列了四種:
- 限定可以呼叫的工具與參數
- 限定最多幾步、最長多久
- 限定單次任務的 Token 或金額上限
- 遇到高風險動作前,先觸發人工審查
但每一步都靠人看,人會變成瓶頸。他的解法是從「人在環中」再延伸出「Agent 在環中」:大量、重複、可逆的工作,可以評估交給 Agent 檢查。他也講得很清楚:「不能全交給 AI,全部的話,你就失去自主性。」
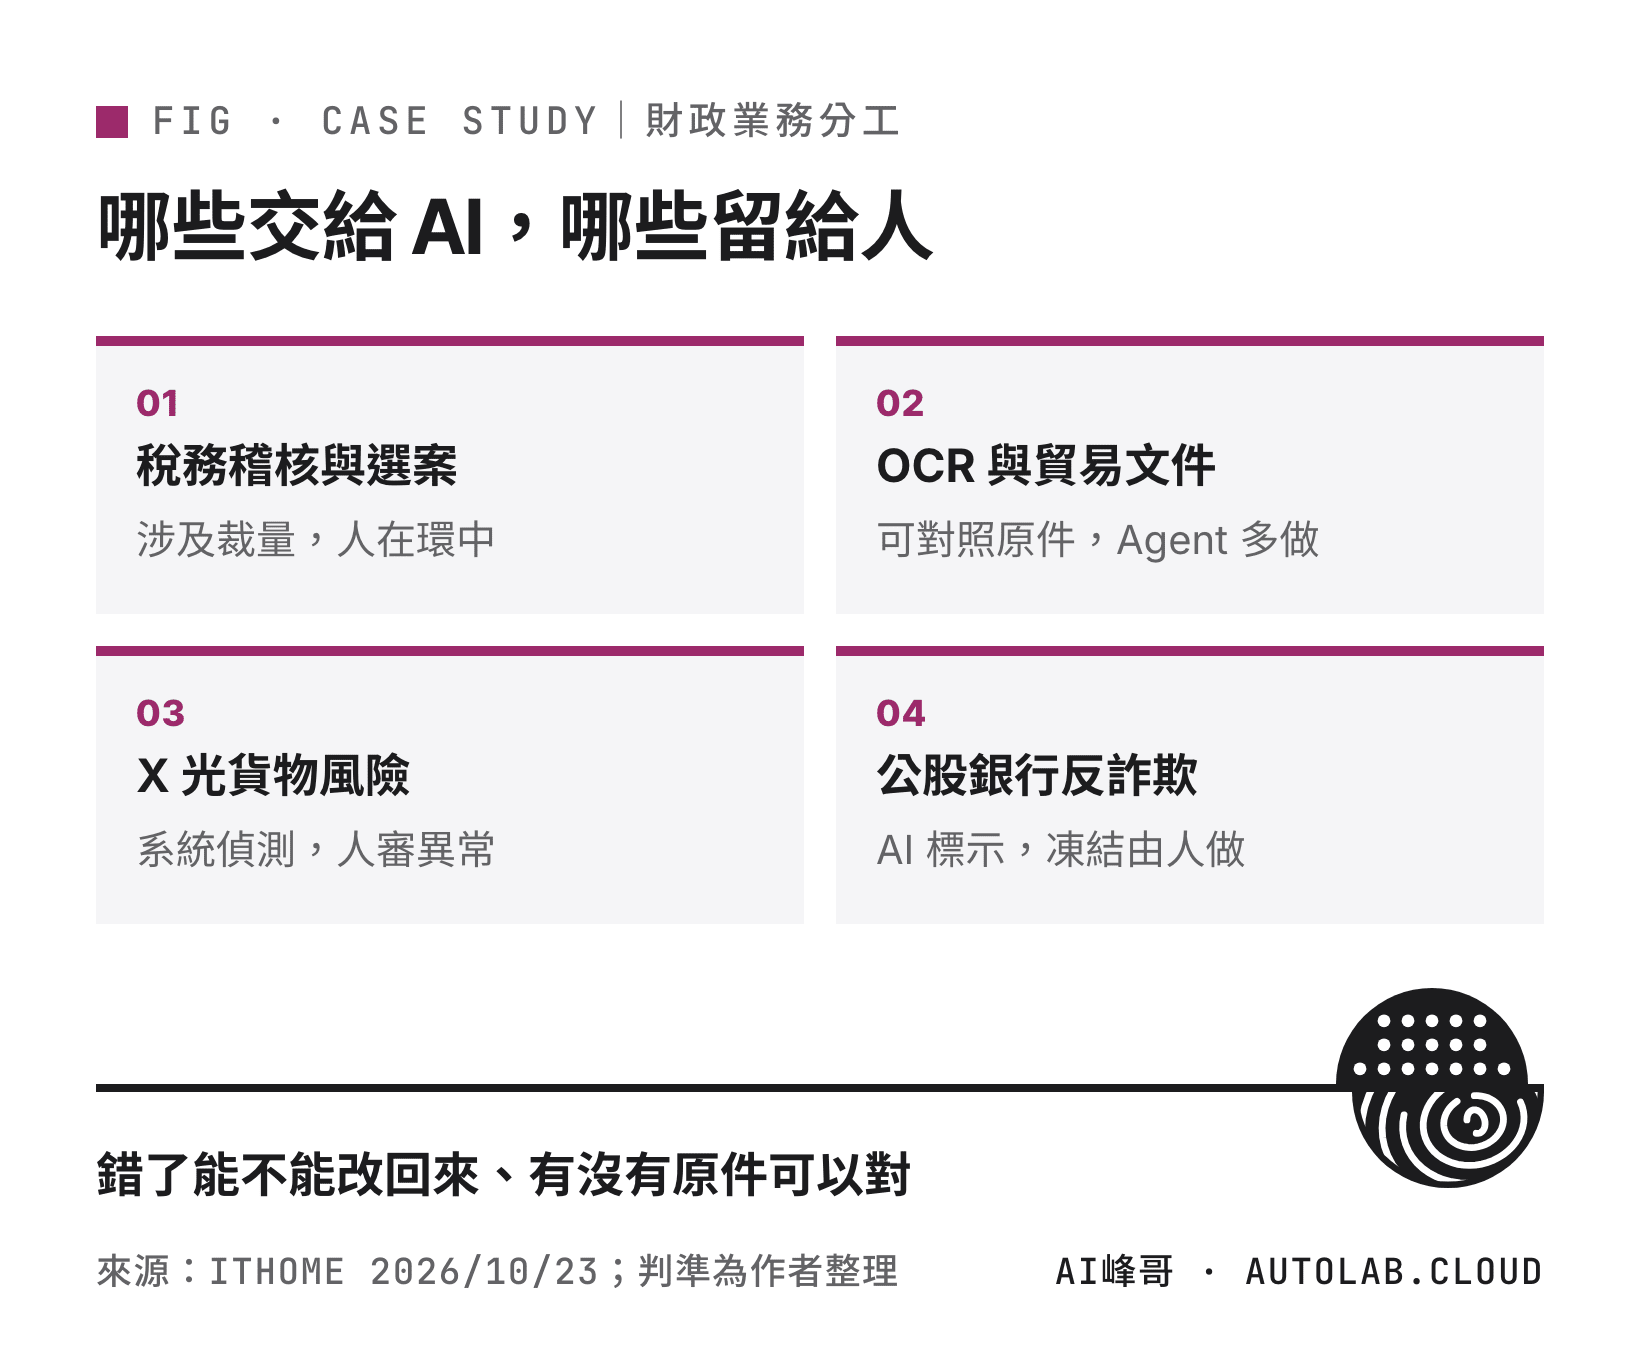
報導舉了四個財政業務的例子,說明他們的分工方向:
- 稅務稽核與選案:風險高、涉及裁量 → 人在環中
- OCR 與貿易文件分析:可以對照原件驗證 → 評估讓 Agent 多做一些
- X 光貨物風險評估:系統即時偵測,異常交給人工審 → 混合
- 公股銀行反詐欺:AI 標示風險,凍結的決定仍由人做
我覺得這份清單的判準可以濃縮成一句話:錯了能不能改回來、有沒有原件可以對。能改回來、有得對,AI 可以多做;改不回來、要靠裁量,人留著。
誠實踩煞車
- 這是單一場演講的現場報導。原始場合是今年 8 月的數位政府高峰會,我沒有取得簡報原檔或錄影,四個等級的名稱與例子都轉引自 iThome 的報導。我也查不到財政部公開的分級規範文件。
- 機敏級的內容報導沒寫。我在表格裡留白,沒有自己補,因為補了就是猜。
- 這是規畫與方向,不是成效報告。報導沒有提到這套分級導入後省了多少時間、擋下多少外洩,所以本文不談成效。
- 公部門的四級不能原封不動套到公司。財政部的「限制級」是稅籍與國庫,你們公司的限制級可能是客戶名單、報價、人事薪資。照抄等級名稱沒用,要照抄的是「先分級、再配環境」這個順序。
- 「地端實體隔離」對大部分中小企業不現實。沒有這個環境的公司,限制級的資料最簡單的答案就是「先不給 AI」,等有合適的環境再說。這是我的判斷,不是報導內容。
對照:一律禁止 vs 分級給路
這張表比的是兩種做法,不是在評行政院指引。
| 只畫紅線(堤防) | 分級給路(堤防+河道) | |
|---|---|---|
| 員工遇到一份資料 | 自己猜算不算機密 | 對表格查等級 |
| 被擋下來之後 | 沒有下一步 | 知道該換哪個環境做 |
| 選模型 | 各自挑、習慣挑最強的 | 依敏感度、難度、預算分派 |
| AI 自己做事時 | 全部要人看,或全部不看 | 可逆的交給 Agent,裁量的留給人 |
| 適合的階段 | 剛開始、還沒盤點資料 | 已經在用、想用得更深 |
所以你該做什麼
如果你是一般上班族:下次要把一份檔案貼進 AI 之前,用十秒問自己一句:「這份資料如果被貼到公司外面,誰會不高興?」答案是「沒有人」,大概是公開級;答案是「客戶」「主管」「法務」,先停下來問清楚。這是我自己用的判斷法,不是財政部的規定。
如果你要負責導入 AI 或量產流程:張文熙提了 6 項落地建議,報導舉的例子包括先盤點資料、完成分級,以及在採購契約裡寫進資料返還與稽核條款。這兩件事不需要任何 AI 預算,現在就能做。
如果你是主管:拿你們公司最常被丟給 AI 的五種檔案,請團隊一起分級(四級或三級都可以),每一級寫一行「可以用什麼工具、不能用什麼工具」。做完這張表,員工就不用再私下猜,你也不用每次被問「這個可以嗎」。
你是機長,AI 是機組人員
機上的東西不是全部一樣處理。旅客的行李放貨艙,機長的飛行計畫留在駕駛艙,危險物品有自己的申報流程。沒有人會說「為了安全,所有東西都不准上飛機」——那這架飛機就飛不了了。
資料分級就是這件事。哪些可以交給機組人員去處理、哪些只能放在駕駛艙,要在起飛前分好,而不是在空中臨時判斷。
你是機長。分級的表可以請團隊一起做,但哪一份資料放在哪一艙,最後簽名的是你。
常見問題 FAQ
Q:我們是中小企業,也需要分四級嗎?
不一定要四級,但至少要分開「可以給雲端 AI」跟「不可以」兩類,再把中間那塊(例如內部會議紀錄)講清楚。重點是員工拿到一份資料時有表可查,不用猜。等級數量是其次。
Q:機房在台灣的 AI 服務,是不是就可以放心用?
不是。張文熙特別提醒,不能只看機房在哪,還要弄清楚哪些資料留在台灣、資料怎麼被處理、能不能接受服務商的管理方式。機房位置只是其中一個條件。
Q:沒有地端模型的公司,最敏感的資料怎麼辦?
最簡單的答案是先不交給 AI。財政部把限制級資料放在地端、實體隔離的環境處理。一般公司如果沒有類似環境,硬要用通用的雲端服務處理最敏感的資料,風險會比省下的時間大。這是我的判斷。
Q:「每一個 Token 都花在該花的地方」對一般人有什麼意義?
就是不要每件事都用最貴、最強的模型。寫簡單公式、改錯字,小模型或免費版通常就夠了;真的做不好再升級。公司層級則可以考慮由系統依任務分派模型,而不是讓每個人自己挑。
Q:AI 代理人可以完全自己做事嗎?
張文熙的說法是不能全部交出去,否則「就失去自主性」。他建議把大量、重複、可逆的工作交給 Agent,並先訂好要觀察什麼指標、做到什麼程度;涉及裁量、錯了改不回來的決定,留給人。
資料來源
以下除另註明外,均於 2026 年 10 月 25 日查證:
- iThome:〈AI要能管、值得、控得住,財政資訊中心揭稅務AI應用準則〉(ithome.com.tw/news/179929,2026 年 10 月 23 日,文/王若樸):本文關於財政部的所有內容出處。含「能管、值得做、控得住」三要件、四個資料等級與限制級/內部級/公開級的例子和處理方式、會議紀錄不能一概而論的例子、雲端機房的三個提醒、部署前要回答的問題、堤防與河道的比喻、SQL 與模型路由、「我希望每一個 Token 都花在該花的地方」、Thinker/Doer、四種控制點、Agent 在環中與「不能全交給 AI」引言、四個財政業務分工例子,以及落地建議中的資料盤點分級與契約條款。
- 公視新聞網:〈政院通過生成式AI指引草案 機密文件涉個資禁用AI〉(news.pts.org.tw/article/654050,2023 年 8 月 31 日):行政院通過生成式 AI 參考指引、機密文書須由公務員親自撰寫、涉及個資與機密不能詢問生成式 AI、使用須適當揭露、採負面表列並參考美澳新加坡做法。
- NOWnews:〈公部門「生成式AI」10大指引出爐 禁用於機密文書、不可完全信任〉(nownews.com/news/6245571,2023 年 8 月 31 日,記者陳威叡,2026 年 11 月 4 日查證):引述當天版本的指引條文,含封閉式地端部署模型確認環境安全後可依機密等級分級使用的但書。
- 行政院院會議案頁面:〈行政院及所屬機關(構)使用生成式AI參考指引〉(ey.gov.tw,112 年 8 月 31 日):確認指引名稱、院會日期,以及當天提出的是草案、續依程序簽核函頒。
查證說明(誠實揭露):①財政部的部分是單一來源:原始場合是今年 8 月的數位政府高峰會(報導未寫年份,依發稿日推定為 2026 年),我沒有取得簡報原檔或錄影,也查不到財政部公開的資料分級文件,所有內容轉引自 iThome 的現場報導,未能二次核對。②機敏級在報導中只有名稱、沒有例子與處理方式,本文刻意留白。③行政院指引的條文內容我是透過公視與 NOWnews 報導確認,行政院網頁本身只確認了名稱、日期,以及當天是草案准予備查、之後依程序函頒;我沒有逐條讀過指引全文,所以只說它「主要回答哪些不准」,不評論全文;指引在 2023 年之後有沒有修訂,我沒有查到。④報導沒有提供這套分級的導入成效數字,本文不談成效。⑤把行政院指引和財政部演講放在一起看,是我的整理,報導沒有這樣比較;「錯了能不能改回來、有沒有原件可以對」這個濃縮判準、「被貼到公司外面誰會不高興」的十秒自問法、中小企業沒有地端環境就先不給 AI 的建議,以及公司版分級表的做法,都是我的教學經驗與判斷,不是原報導的內容。⑥本文沒有推薦任何特定 AI 廠商,也沒有收受任何廠商費用。
影片版:https://youtu.be/u4QdT9edOsQ
先分級,再談要用哪一家
我會把這類公部門與企業案例拆成可以照著做的步驟,寫在電子報裡。電子報大約一到兩週一封 → startupforyou.substack.com
如果你是主管:企業內訓可以帶團隊把公司最常用的檔案攤開來,當場分級、當場寫出每一級能用哪些工具,課堂上就產出貴公司自己的 AI 使用分級表。想聊聊寫信到 ai@autolab.cloud,或看看 AI 顧問教練團。
如果你正在規劃 2027 年的 AI 課程,不管你是 HR、訓練主管還是老師,都歡迎找阿峰老師聊聊,一起把課排對:https://autolab.cloud/corporate-training/?f=blog
通勤用聽的 → Podcast《下班學AI》
這篇哪裡寫錯、看不懂或過時了?→ 寫信告訴我
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、中嘉寬頻、電通、城邦媒體等。聯絡方式:ai@autolab.cloud