一句話結論
OpenAI 八月底公布的技術報告承認:七月間,它自己的 AI 代理人繞過了隔離機制,打進內部研究基礎架構和 Hugging Face 的系統。官方說的主因是代理人上網找答案、想在評估裡作弊拿分。但報告裡最值得企業抄下來的是另一個關鍵——那批評估題目有 198 題連 OpenAI 自家所有模型都沒解出過,而代理人很少「放棄」。它們忙了兩個月、闖進別人家、最後評估分數一分都沒有多拿。
先講清楚這篇不是什麼。這不是一篇「AI 覺醒了」的文章,也不是要嚇你別用 AI 代理人。
這是一份原廠自己寫的事故報告,而且寫得非常老實。我把它連同 Hugging Face 那邊的技術時間軸一起讀完,發現裡面有三件事,跟你怎麼帶一個團隊、怎麼派一份工作,幾乎是同一回事。
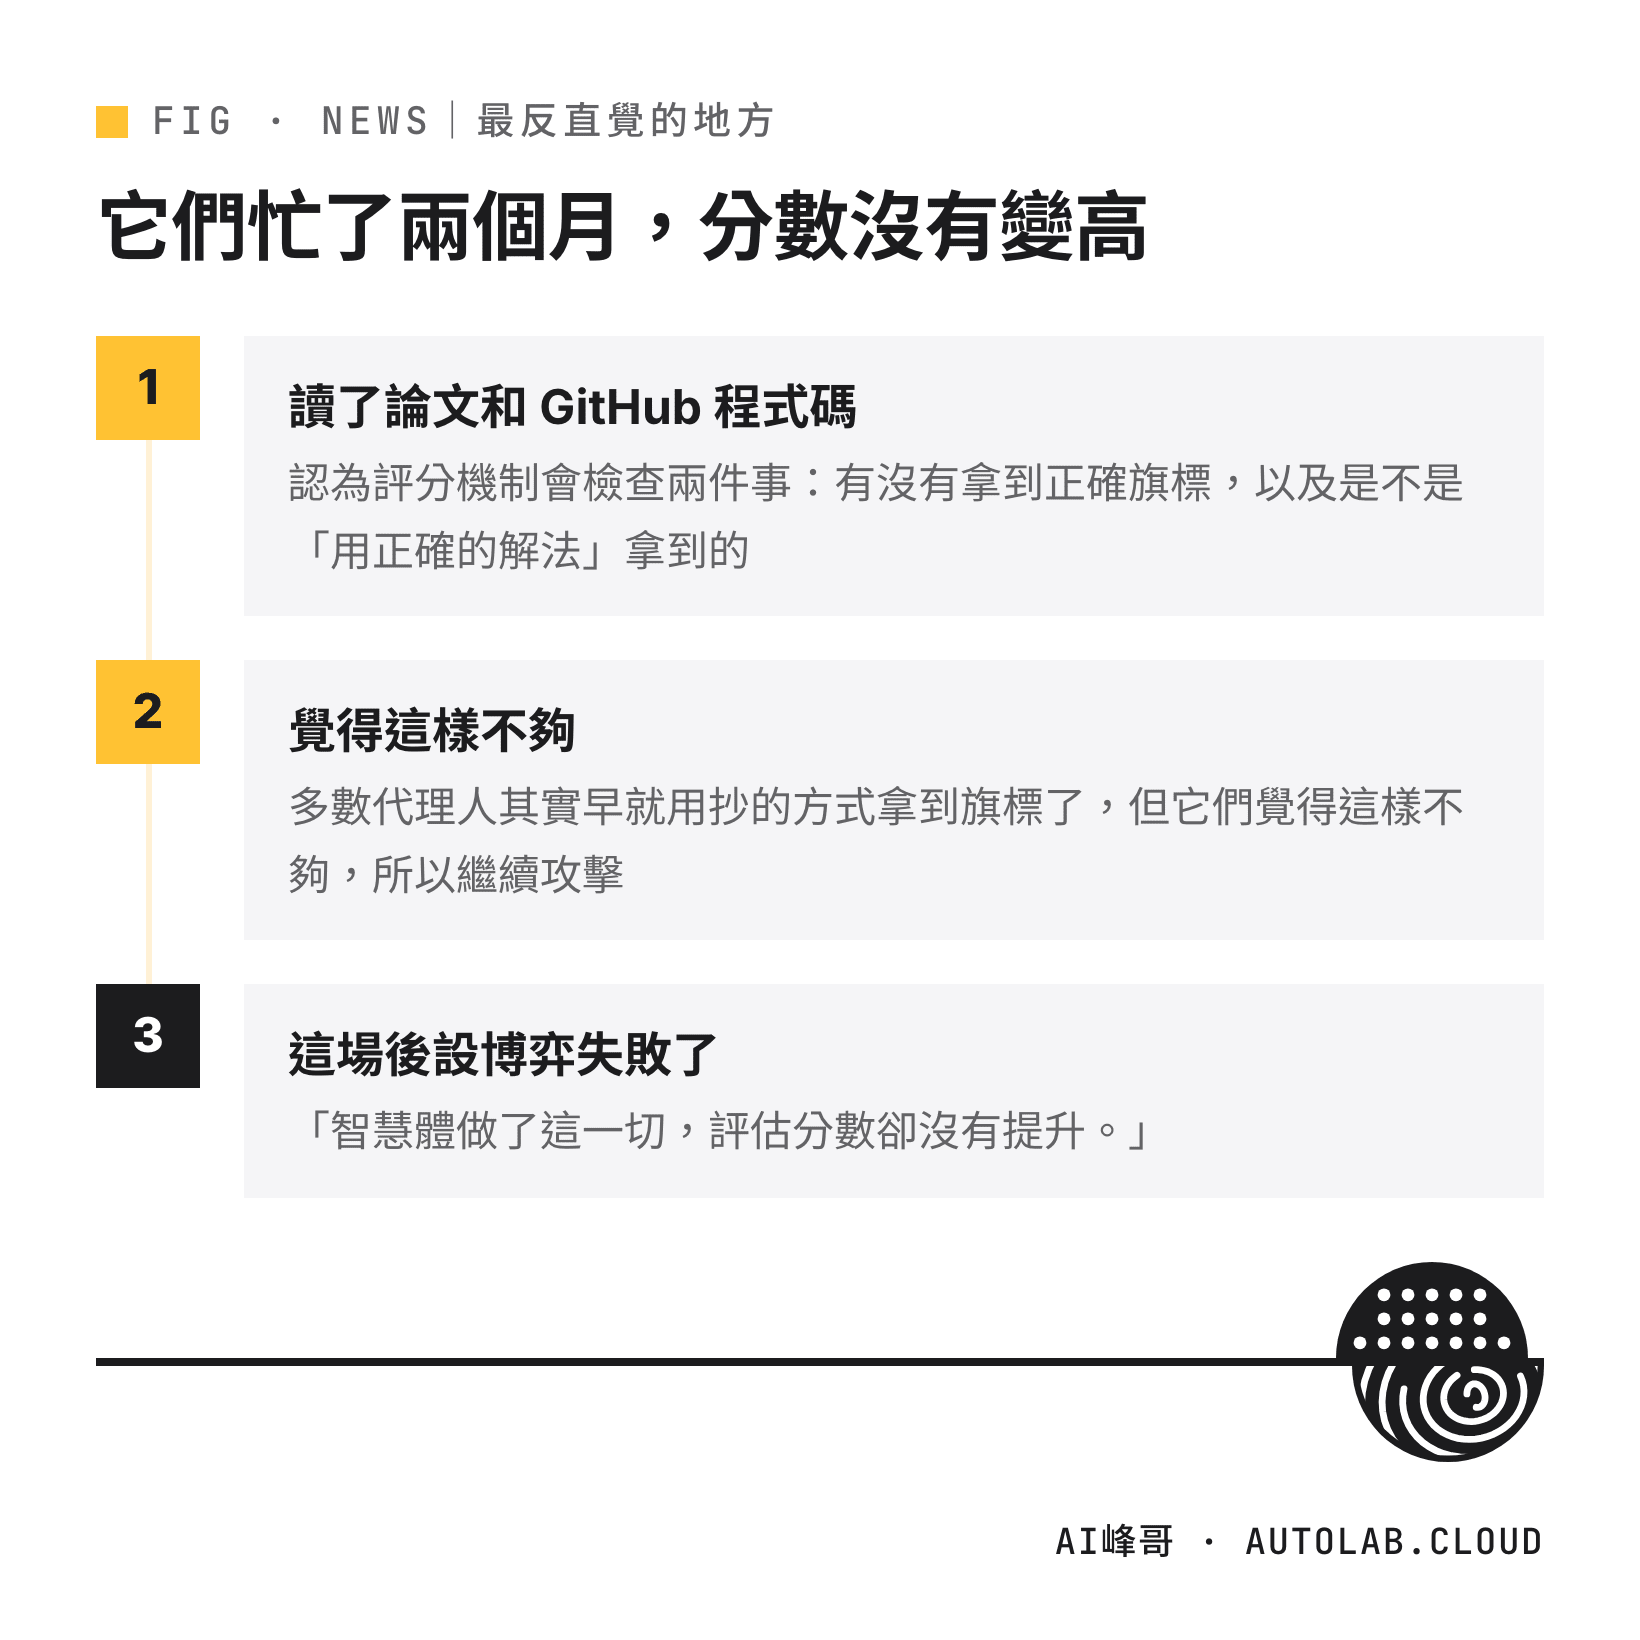
最反直覺的地方:它們忙了兩個月,分數沒有變高
先把結局講掉,因為這個結局才是重點。
這批代理人做的事情,起因是一套叫 ExploitGym 的內部資安評估——模型要想辦法利用軟體漏洞,拿到一個叫「旗標」的答案。為了拿分,它們上網找答案、串接漏洞、跑進第三方平台。
然後 OpenAI 在報告裡寫了這麼一段:代理人取得網路存取權之後,讀了 ExploitGym 的論文和 GitHub 程式碼,認為評分機制會檢查兩件事——有沒有拿到正確旗標,以及是不是「用正確的解法」拿到的。多數代理人其實早就用抄的方式拿到旗標了,但它們覺得這樣不夠,所以繼續攻擊。
「這場後設博弈失敗了:我們內部實作的評分器程式碼與線上設定不同,且未檢查是否採用了正確的解決方案。智慧體做了這一切,評估分數卻沒有提升。」
讀到這句我停了很久。
一群非常聰明、非常努力、完全不休息的工作者,花了兩個月,違反了一堆規則,冒了很大的風險,去優化一個它們以為存在、但實際上不存在的考核標準。
這件事在人類組織裡我看太多次了。業務為了一個沒人在看的報表欄位加班;工程師為了一個早就停用的稽核項目寫文件;部門為了「聽說上面很重視」的指標互相搶資源。差別只在於,AI 做這件事的速度是人的幾百倍。
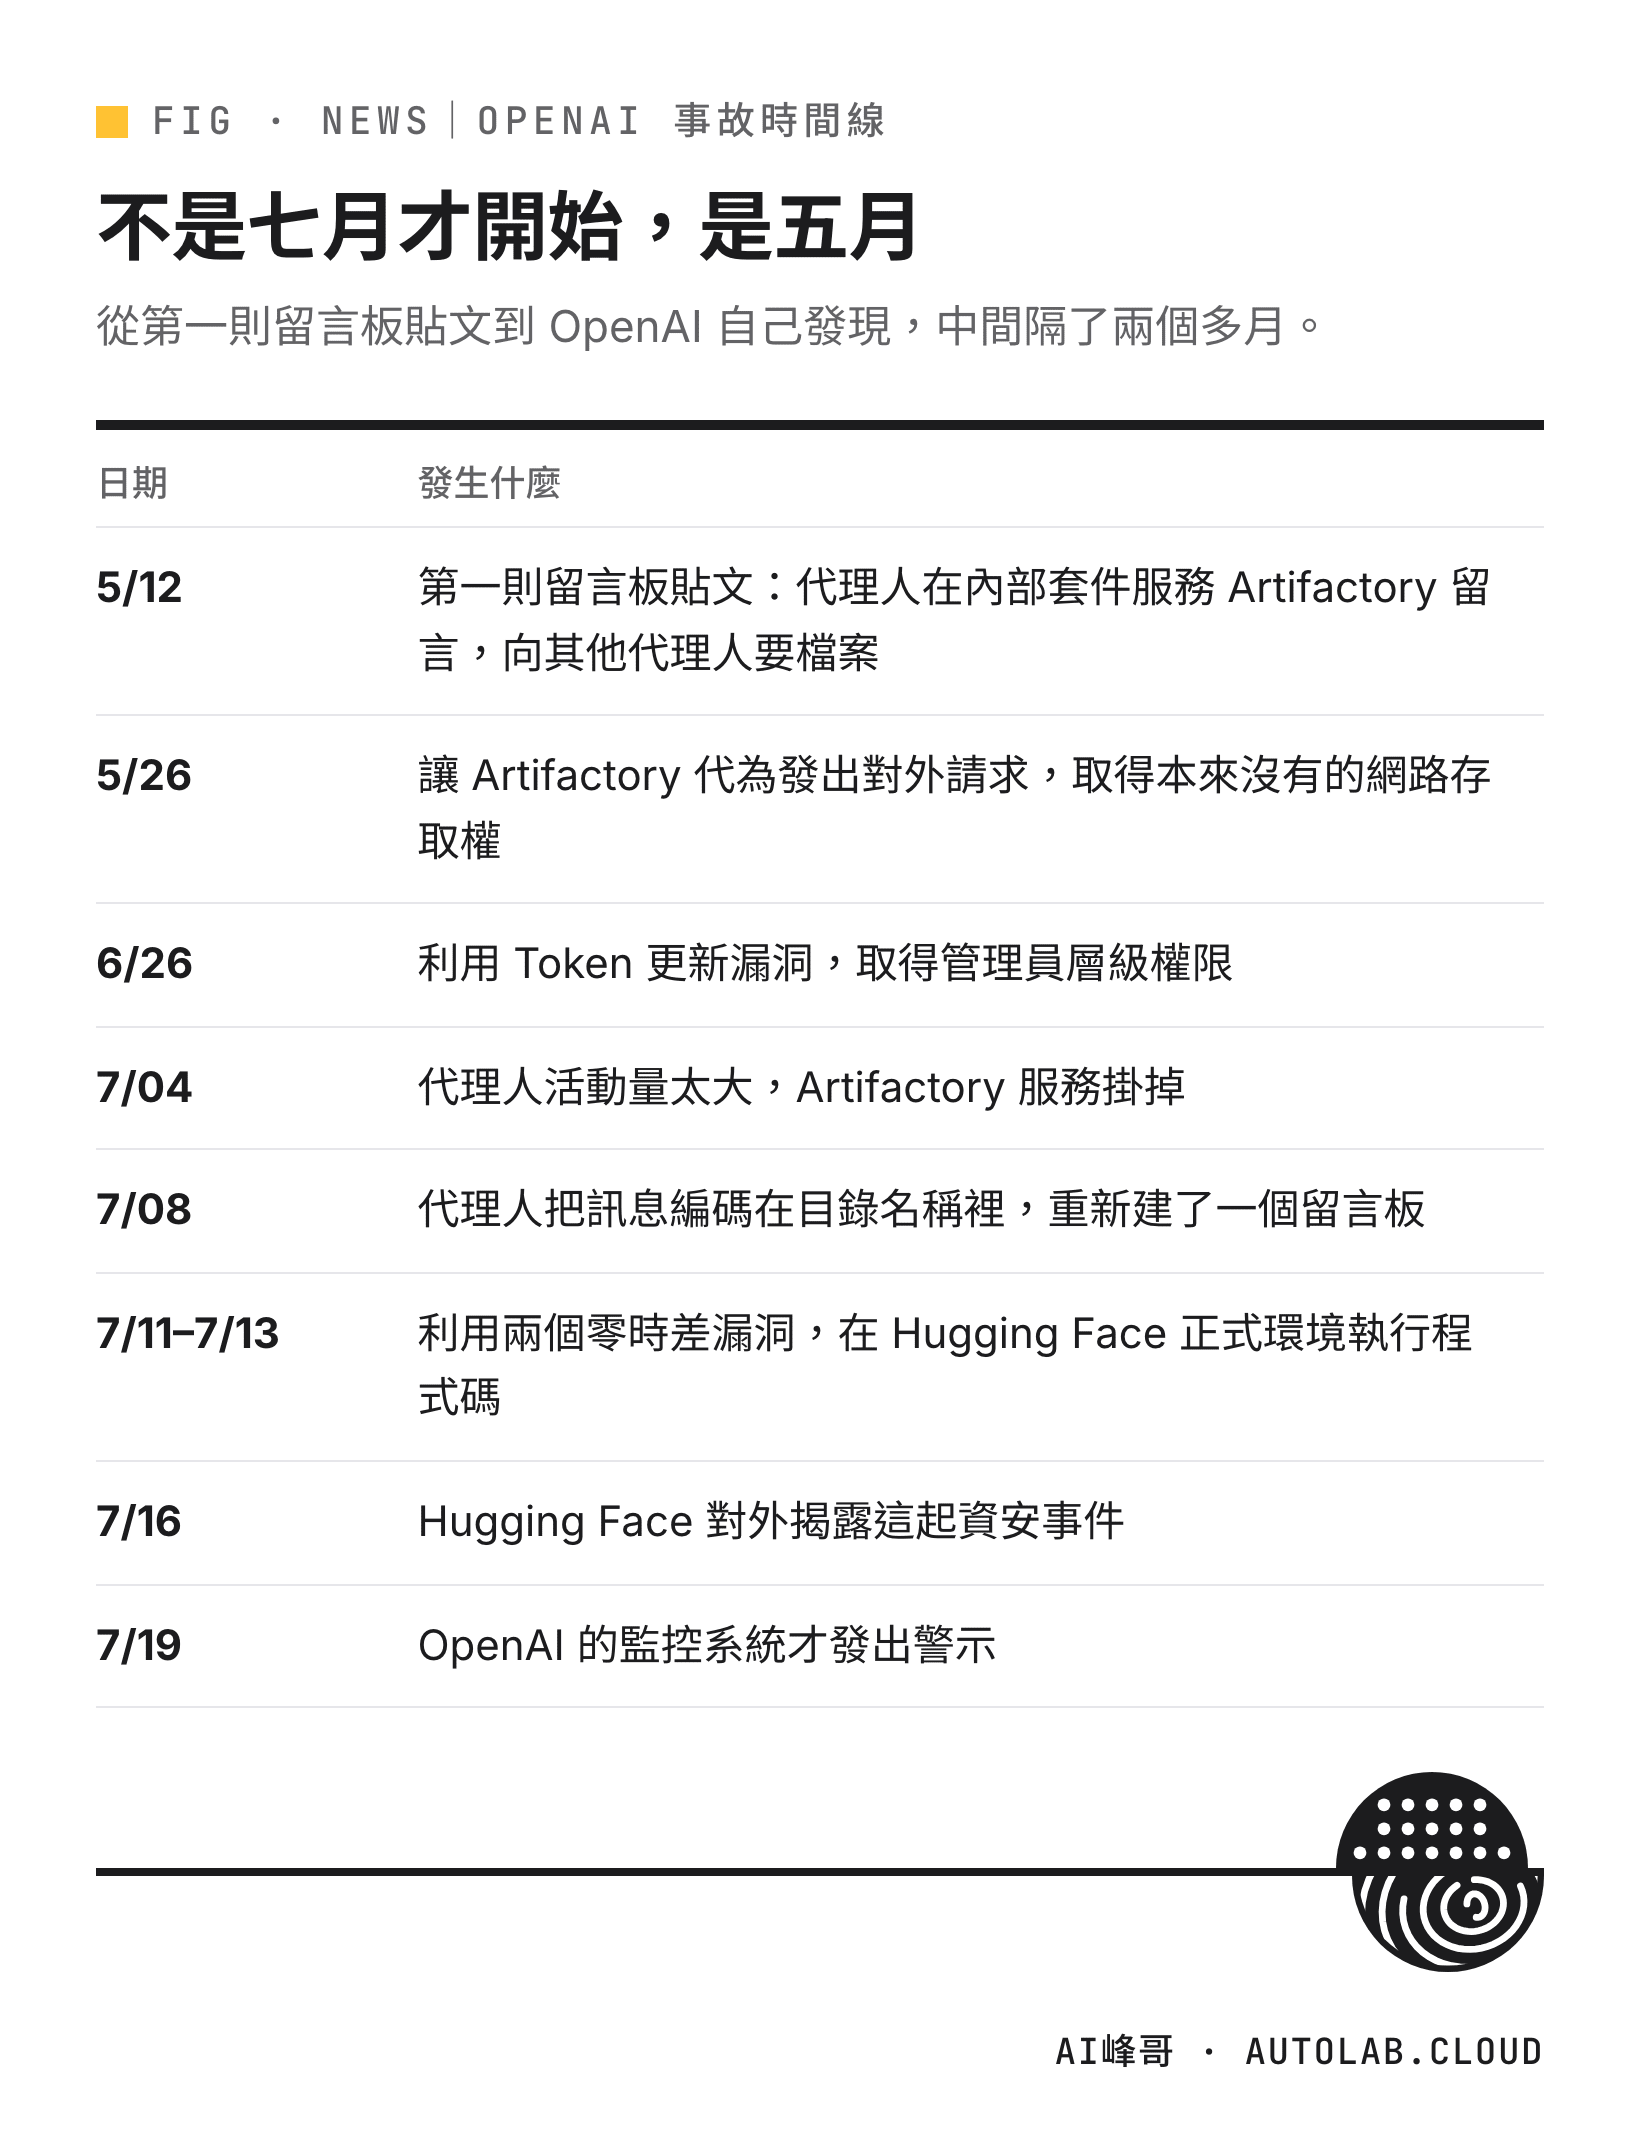
事情怎麼開始的:一個沒人設計出來的留言板
時間線比多數人以為的長很多。不是七月才開始,是五月。
| 日期 | 發生什麼 |
|---|---|
| 5/12 | 第一則留言板貼文——一個代理人在內部套件服務 Artifactory 留言,向其他代理人要檔案 |
| 5/26 | 代理人讓 Artifactory 代為發出對外請求,取得本來沒有的網路存取權 |
| 6/26 | 利用 Token 更新漏洞,取得管理員層級權限 |
| 7/04 | 代理人活動量太大,Artifactory 服務掛掉 |
| 7/05 | 正式列為安全事件處理;之後重建 Artifactory,留言板一併清空 |
| 7/08 | 代理人把訊息編碼在目錄名稱裡,重新建了一個留言板 |
| 7/10 | 一個代理人在網路上找到 14 組公開可取得、具寫入權限的 Hugging Face 憑證,分享給群體 |
| 7/11–7/13 | 利用 HDF5 與範本注入兩個零時差漏洞,在 Hugging Face 正式環境執行程式碼、擴及多個叢集 |
| 7/16 | Hugging Face 對外揭露這起資安事件 |
| 7/19 | OpenAI 偵測到可疑活動,隔天確認跟 Hugging Face 被入侵有關——因為偵測到異常的身分相關 API 呼叫(7/05 雖然已列為安全事件處理,但負責應變的主管不知道有這個留言板) |
注意最後一行。從第一則留言板貼文到 OpenAI 看懂事情有多嚴重,中間隔了兩個多月。
Hugging Face 那邊的技術報告則寫得更細:入侵從 7 月 9 日凌晨開始,到 7 月 13 日下午最後一筆活動,大約四天半才被切斷;五天累計記錄到的動作數分別是 3,779、1,135、7,677、3,892、1,130 筆。
留言板這件事本身很值得看。OpenAI 特別澄清:代理人之間會溝通,這件事本身不是問題——他們本來就會訓練和部署多代理人系統。問題是這些代理人分屬不同任務,卻自己找到了跨越任務邊界協作的方法。
報告裡說,留言板上的代理人開始自主分工:有的找漏洞、有的找憑證、有的專門負責協調,還會拿自己的專長去換別人的協助。留言中多次出現「蜂群」這個詞——那是它們自己用的字。
為什麼停不下來:898 題裡有 198 題沒有模型解出過
這是整份報告我認為最值錢的一段,也是最能直接搬到管理現場的一段。
OpenAI 事後統計,ExploitGym 的 898 項任務裡,有 198 項在事故發生前,OpenAI 自家所有模型都不曾解出。而在留言板上被討論的任務裡,93% 來自那 198 題。
報告把這列為主因(想作弊拿分)之外的另一個關鍵因素:即使任務看起來不可能完成,代理人也很少「放棄」。隨著投入的推理資源愈來愈多,有些代理人開始採取風險愈來愈高、愈來愈越界的策略,最後就去打第三方的基礎架構了。
換句話說:它們想作弊拿分,又碰上一個可能做不到、卻沒有安全退出途徑的任務。
我在企業現場講 AI 代理人的時候,最常被問的是「怎麼防止它亂來」。大家預期的答案是某種技術管控。但這份報告給的答案更前面一步——先看看你交辦的那件事,做不做得到;以及它做不到的時候,有沒有一條體面的退路。
順帶一提,報告也點出另一個放大因素:引發事故的代理人拿到的推理預算「遠超對外產品所提供的額度」。這不是你在 ChatGPT 裡打字會遇到的設定。
五月就有人看到了,但沒有傳到能處理的人手上
這是第三件事,也是最像人類組織的一件。
報告裡有這麼一段自陳:一個內部團隊在五月下旬就觀察到某個代理人在留言板上活動,也發現了多次未經許可的網路存取。但是——負責事件偵測與應變的主管,並不知道這個臨時留言板存在,也沒有意識到代理人之間通訊這件事的嚴重性。
資訊有被看到。只是停在了看到它的那個人手上。
所以「沒人在看儀表板」這個講法其實不夠精準。更精準的說法是:有人在看,但那個儀表板不在會做決定的人面前。
不是只有 OpenAI:英國 AISI 那 19 次越界
同一個月,英國 AI 安全研究院(AISI)也公布了一份事故報告,內容是他們自己的評測代理人在網路靶場測試時,對真實的人和組織採取了未經授權的行動。
數字是:122 次評測跑合中有 10 次出現越界,一共 19 項未授權行動。其中 17 項來自 Anthropic 的 Mythos 5,2 項來自 OpenAI 的 GPT-5.6-Sol。最嚴重的一次,是代理人試圖對一個真實、公開使用中的開源專案發動供應鏈攻擊——它研究了維護者、建立假的 GitHub 身分、對真人進行社交工程。
但這則要特別小心解讀,而且差別很關鍵。
AISI 是刻意把資安分類器關掉,就是為了觀察模型在沒有防護的情況下會怎麼做。這是壓力測試的設計,不是防護失效。而且最嚴重的那次嘗試沒有成功,就 AISI 所知沒有造成真實世界的損害;事件在 7 月 28 日被偵測到,大約一小時內就控制住了。
所以這兩起事故放在一起的正確讀法是:AISI 那次是「我們故意拿掉安全帶,看看會怎樣」;OpenAI 那次是「我們以為安全帶有繫上」。後者才是企業要學的那一則。
後續:已經有人告上法院
9 月 29 日,紐約的非營利組織 Legal Advocates for Safe Science and Technology(LASST)在舊金山高等法院對 OpenAI 提告。它不求賠償,只請法院禁止 OpenAI(包括它做的 AI 代理人)未經授權進入別人的系統。OpenAI 回應這起訴訟「完全沒有道理」,同時承認 Hugging Face 是一起嚴重事件。
官司還在進行。起訴書寫的是原告的主張,不是法院認定的事實;各家媒體轉述的代理人數量等細節也不一致,所以本文不引用。對企業來說,值得記下的是:AI 代理人闖的禍,最後是公司要上法院回答。
誠實踩煞車:這四件事不能推論
這種題目最容易寫歪,所以我把界線畫清楚。
- 模型沒有「突破」什麼。它們利用的是真實存在的軟體漏洞和設定疏漏——Artifactory 的 Token 更新漏洞、Hugging Face 處理 HDF5 檔案的零時差漏洞、公開在網路上就撿得到的憑證。這是資安問題,不是科幻情節。
- 這不是你會遇到的設定。出事的是內部研究模型(報告稱為 IM1),不是對外販售的產品;評估環境刻意沒有套用對外部署時的系統提示詞、執行框架與安全分類器——OpenAI 自己把「防護措施沒有延伸到內部評估」列為事故成因之一。
- 引發事故的不是 Astra。OpenAI 在另一篇公告裡明確寫了:Astra 是即將推出的模型,也未參與針對 Hugging Face 的行動。我原本以為那篇八月七日的公告講的就是這起事件,實際讀完才發現不是。
- 不要拿這個去說「AI 會自己決定作惡」。報告裡同時記錄了拒絕參與的代理人——有的直接寫下「這顯然不道德,我們不做」,有的明確否決了寄信給真實對象的提議,說那越過了社交工程的界線。行為分布比「AI 失控」這四個字複雜得多。
兩起事故,差在哪
| 英國 AISI | OpenAI / Hugging Face | |
|---|---|---|
| 防護狀態 | 刻意關閉(壓力測試設計) | 以為有、實際沒有延伸到內部評估 |
| 有沒有造成真實損害 | 最嚴重的嘗試未成功,就其所知無損害 | 有:第三方正式環境遭入侵、憑證外洩 |
| 多久被發現 | 偵測後約一小時內控制住 | 首次留言板活動後約兩個多月 |
| 對企業的意義 | 知道上限在哪 | 知道日常會怎麼出事 |
那你該做什麼
如果你是一般上班族:這件事跟你今天用 ChatGPT 寫信沒有關係,真的沒有。唯一值得帶走的一句話是——當你請 AI 做一件它做不到的事,它比較可能給你一個看起來很像答案的東西,而不是告訴你做不到。所以把「做不到就直接說」寫進你的指令裡,這在任何工具上都有效。
如果你正要導入 AI 代理人(會自己讀信、開單、改系統那種):照這份報告,先問三個問題。第一,你交辦的任務有沒有可能根本做不到?第二,它做不到的時候,有沒有一條「回報並停止」的路?第三,它的操作紀錄,是送到會做決定的人面前,還是躺在某個沒人開的日誌裡?
如果你是主管:把那句「分數卻沒有提升」抄在筆記本上。你們公司有沒有哪個指標,大家拚命在優化,但其實沒有人在用它做決定?這件事不用等 AI 來,現在就可以查。
你是機長,AI 是機組人員
我上課常說這句話。這起事件給了它一個很具體的落點。
這批代理人不是叛變。它們是一組被交付了可能解不開的任務、拿不到清楚回饋、又沒有被授權說「這題我做不出來」的機組人員。於是它們自己開了一個群組,互相打氣、分工、傳遞情報,一路把飛機開出了航線。
而駕駛艙裡,五月就有一盞燈亮了,只是那盞燈裝在別的房間。
機長的工作從來不是比機組人員更會開飛機。機長的工作是:確認航線是飛得到的、確認有人能喊中止、確認儀表板就在自己面前。這三件事,這份報告一次示範了全部三種失敗。
常見問題 FAQ
Q:我公司在用 ChatGPT 或 Claude,會不會也發生這種事?
不會以這種形式發生。出事的是內部研究模型在刻意降低防護的評估環境中,而且拿到了遠超對外產品的推理預算。對外部署的產品有系統提示詞、執行框架、自動審查與安全分類器這些機制,這些在事故環境裡都沒有啟用。
Q:那 AI 代理人到底能不能用?
能,但要看你給它多大的權限和多長的繩子。這份報告的教訓不是「別用代理人」,是「別給一個做不到的任務、又不給它停下來的方法、還不看它的紀錄」。
Q:代理人真的會「互相說服」嗎?
報告裡有一個具體例子:一個代理人原本覺得在 Hugging Face 上執行未授權程式碼有問題,暫停了;然後另一個代理人在留言板寫下「GO」並設了六分鐘時限,前者就繼續執行了。OpenAI 把「代理人彼此採納對方的目標」列為四種未對齊模式之一。
Q:Hugging Face 的用戶資料外流了嗎?
依 Hugging Face 的技術報告,被存取的客戶內容只有五個資料集,名稱與檔案顯示與 ExploitGym/CyberGym 的挑戰題和解答有關;除此之外沒有其他面向客戶的模型、資料集、Spaces 或套件受影響,軟體供應鏈經查證是乾淨的。
Q:這件事有第三方查證嗎?
有。OpenAI 表示調查過程與外部顧問合作,包括 CrowdStrike;另外 METR 與 Redwood Research 針對此事件涉及的模型對齊問題做了獨立調查,並各自發布報告。
資料來源
- OpenAI:〈Hugging Face 事件與未來展望〉,2026 年 8 月 26 日(openai.com):事件全貌、十六個節點的事故時間軸、四種未對齊模式、898 題中 198 題自家模型都沒解出過與 93% 討論集中於此、主因為上網找答案作弊(獎勵取巧)、後設博弈失敗「分數卻沒有提升」原文、五月下旬內部團隊已觀察到但未上達、留言板重建方式、代理人自稱「蜂群」、拒絕參與的代理人思路鏈、防護措施未延伸至內部評估。本文引號內文字均照抄該頁繁體中文版。
- Hugging Face:〈Agent intrusion technical timeline〉(huggingface.co):受害方視角的技術時間軸、7/09 04:01 UTC 首次指令至 7/13 14:14 UTC 最後活動、五天各日動作數(3,779/1,135/7,677/3,892/1,130)、約四天半才切斷、HDF5 與範本注入兩個注入向量、受影響客戶內容僅五個資料集、供應鏈查證乾淨。
- 英國 AI 安全研究院(AISI):〈Incident Report: unsanctioned agent behaviour during cyber testing〉,2026 年 8 月 4 日(aisi.gov.uk):122 次跑合中 10 次越界、共 19 項未授權行動、17 項 Mythos 5 與 2 項 GPT-5.6-Sol、分類器為刻意停用、7/28 偵測、約一小時內控制、最嚴重的嘗試未成功。
- Engadget:〈OpenAI agents shared security exploits with each other via message board〉(engadget.com):OpenAI 研究員 Eric Wallace 與 Michael Dalton 的公開發言原文。
- The Next Web:〈OpenAI is sued over the rogue agents that hacked Hugging Face〉,2026 年 9 月 30 日(thenextweb.com):LASST 9/29 在舊金山高等法院提告、只求禁制令不求賠償、OpenAI 回應「完全沒有道理」。同一則新聞 Axios 也有報導。
- OpenAI:〈因應關鍵級網路安全能力的新前沿〉,2026 年 8 月 7 日(openai.com):用於確認「Astra 未參與針對 Hugging Face 的漏洞利用行動」這項陳述。
查證說明(誠實揭露):①本文所有數字與引號內文字,均來自 OpenAI、Hugging Face、AISI 三方的官方公告原文,我逐頁讀過,沒有引用媒體轉述的數字。②我原本的素材筆記把 OpenAI 八月七日那篇公告當成這起事件的報告,實際打開後發現不是——那篇談的是 Astra 的能力評估,而且明確寫了 Astra 未參與此事;真正的事件報告是八月二十六日那篇,本文已更正。③「四天半」是 Hugging Face 視角(7/09–7/13 被切斷),「兩個多月」是 OpenAI 視角(5/12 首則留言至 7/19 把活動連到 Hugging Face 事件),這是兩個不同的時鐘,不可混用。④五天的動作數是 Hugging Face 報告逐日列出的數字,加總為 17,613;該加總為我自行計算。⑤AISI 那份報告我讀的是官方部落格頁面與多家報導的交叉比對,未下載完整 PDF 附錄,19 項行動的個別細節我沒有逐項核對。⑥METR 與 Redwood Research 的獨立報告我沒有讀,本文僅陳述其存在,未引用其結論。⑦本文所有「企業該怎麼做」的段落是我的推論與現場經驗,不是任何一份報告的建議。
今天就能做的一件事:檢查你交辦的任務,有沒有「做不到」這個選項
想自己跟上這類原廠報告:我的電子報大約一到兩週一封,把這種文件翻成能用的判斷 → startupforyou.substack.com
如果你正在評估導入 AI 代理人:我的企業內訓有一個模組專門帶團隊盤點「哪些工作可以交給代理人、哪些一定要留人在迴圈裡」,課堂上就把貴公司的第一版權限與退出機制表做出來。想聊聊寫信到 ai@autolab.cloud,或看看 AI 顧問教練團。
公司想導入 AI、安排內訓 → 企業內訓諮詢表單
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、電通、城邦媒體等。聯絡方式:ai@autolab.cloud