一句話結論
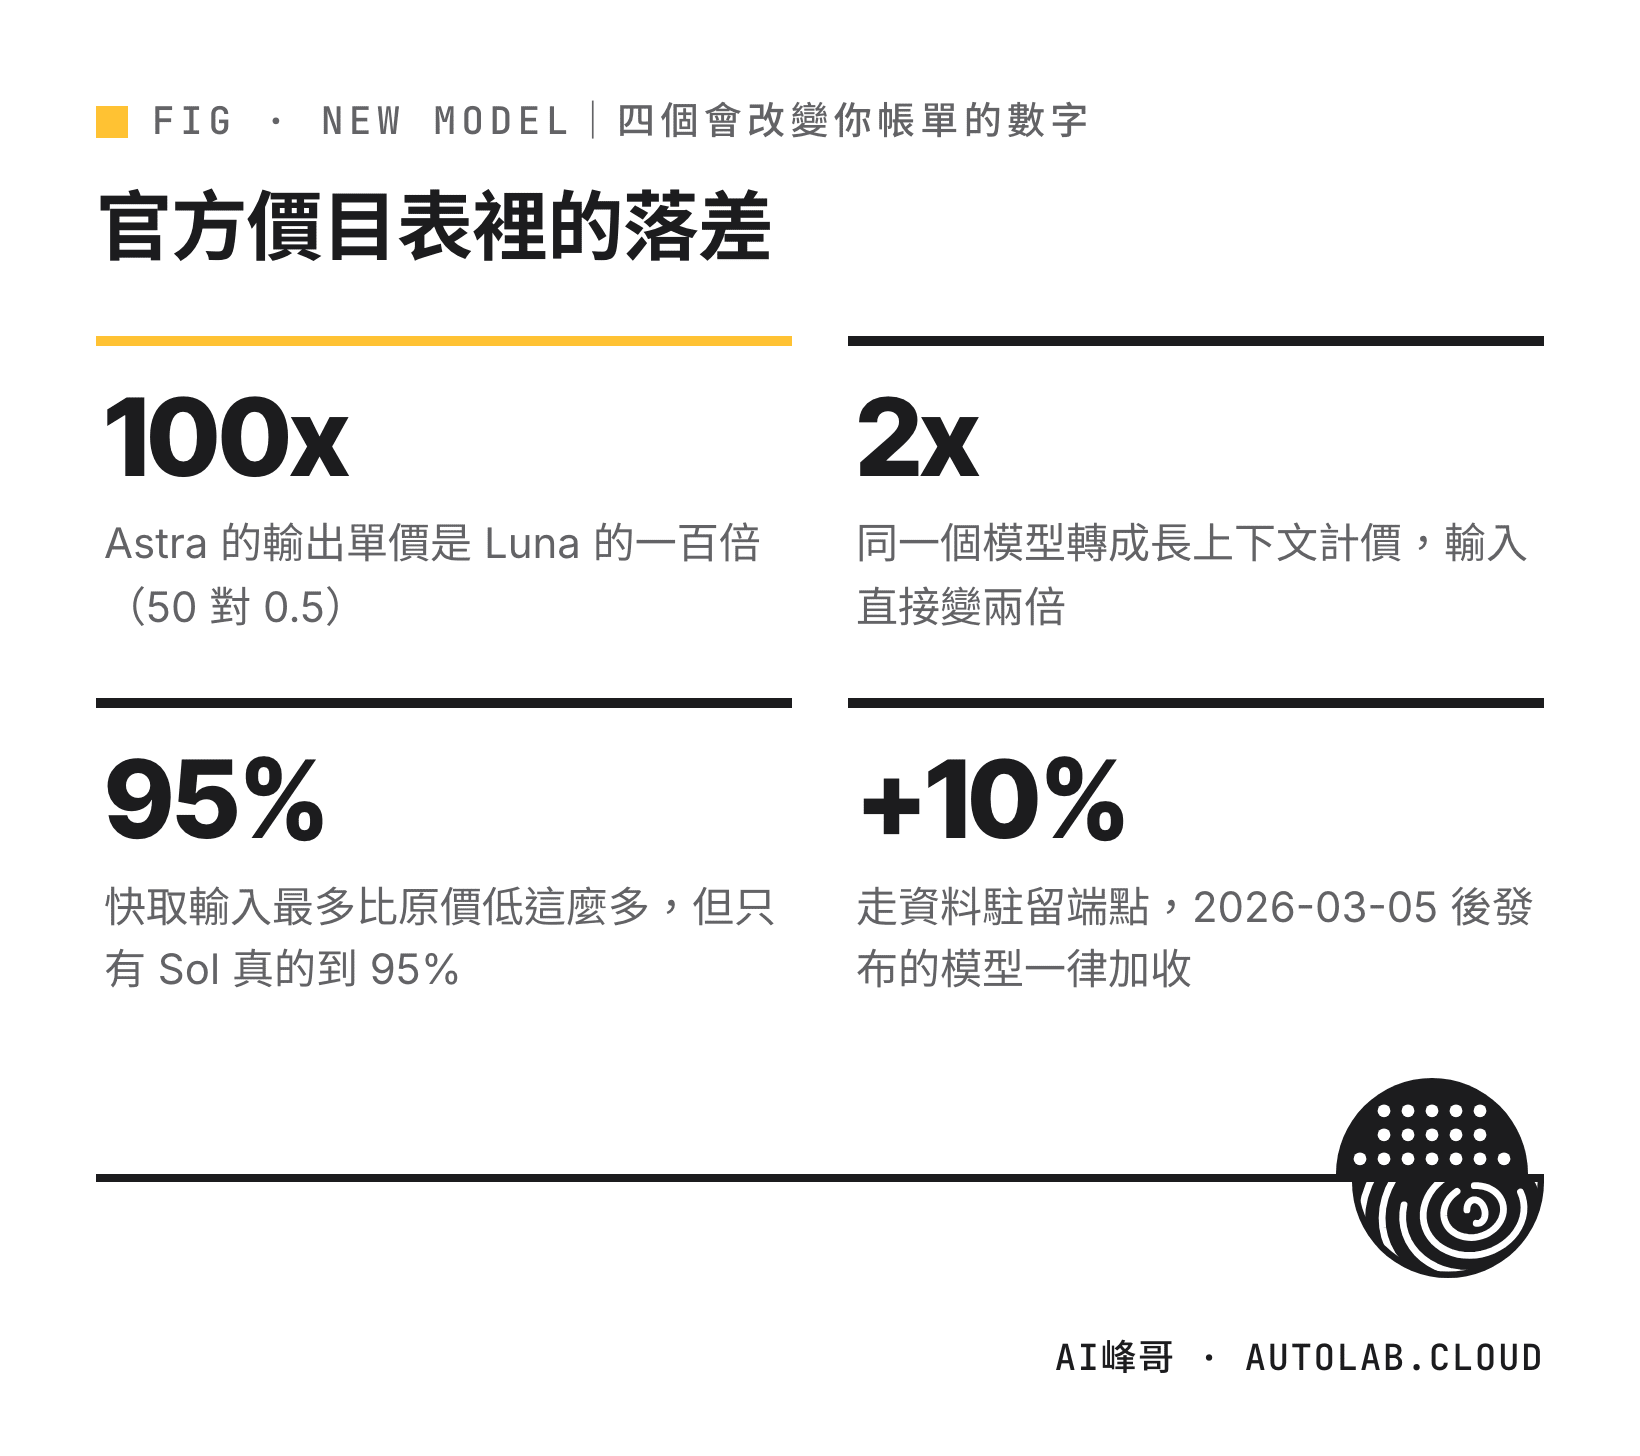
OpenAI 在 10 月 2 日放了一份自家的 GPT-6 選用說明,裡面最誠實的一段是:它建議你把擷取欄位、分類、產摘要這種日常工作交給最便宜的 Luna,不要用最強的 Astra。翻成錢來看,兩者的輸出單價差 100 倍(每百萬 token 50 美元對 0.5 美元)。而且那三張漂亮的價目卡還漏了三件會影響帳單的事:長上下文是另一個價格級距、快取寫入要單獨收費、資料駐留端點要加一成。
先講為什麼這篇值得你花時間,即使你不寫程式。
我在企業現場最常聽到的一句話是「我們想用最好的那個模型」。聽起來很合理——反正要花錢,花在最強的上面總不會錯吧。
但這次是 OpenAI 自己跳出來說:不要。
OpenAI 自己怎麼分這三個模型
這份說明是 2026 年 10 月 2 日發布的,就在 GPT-6.1 Sol(9 月 29 日推出)之後幾天。官方給的分工很直白:
- GPT-6 Astra——「適合需要最強智慧能力、難度最高的推理工作」
- GPT-6.1 Sol——「適合複雜的程式設計、研究與電腦操作」,官方形容是「只需五分之一的價格,即可享有接近 Astra 的智慧水準」
- GPT-6 Luna——「適合大規模執行範圍明確的任務,以及目標清楚、日常重複的工作,例如擷取發票欄位、將請求分類或產生結構化摘要」
請把 Luna 那一行再讀一次。擷取發票欄位、分類、產結構化摘要——這不就是一般公司最想自動化的那三件事嗎?
而這三件事,官方建議你用的是價目表上最便宜的那個。
價目表有第二欄,行銷頁沒給你看
那份選用說明上印了三張價目卡:Astra 10/50、Sol 2/10、Luna 0.1/0.5(每百萬 token 的輸入/輸出,美元)。看起來很清楚。
但我把 OpenAI 的開發者價目表開起來對,發現那三張卡只印了短上下文那一欄。完整的表長這樣:
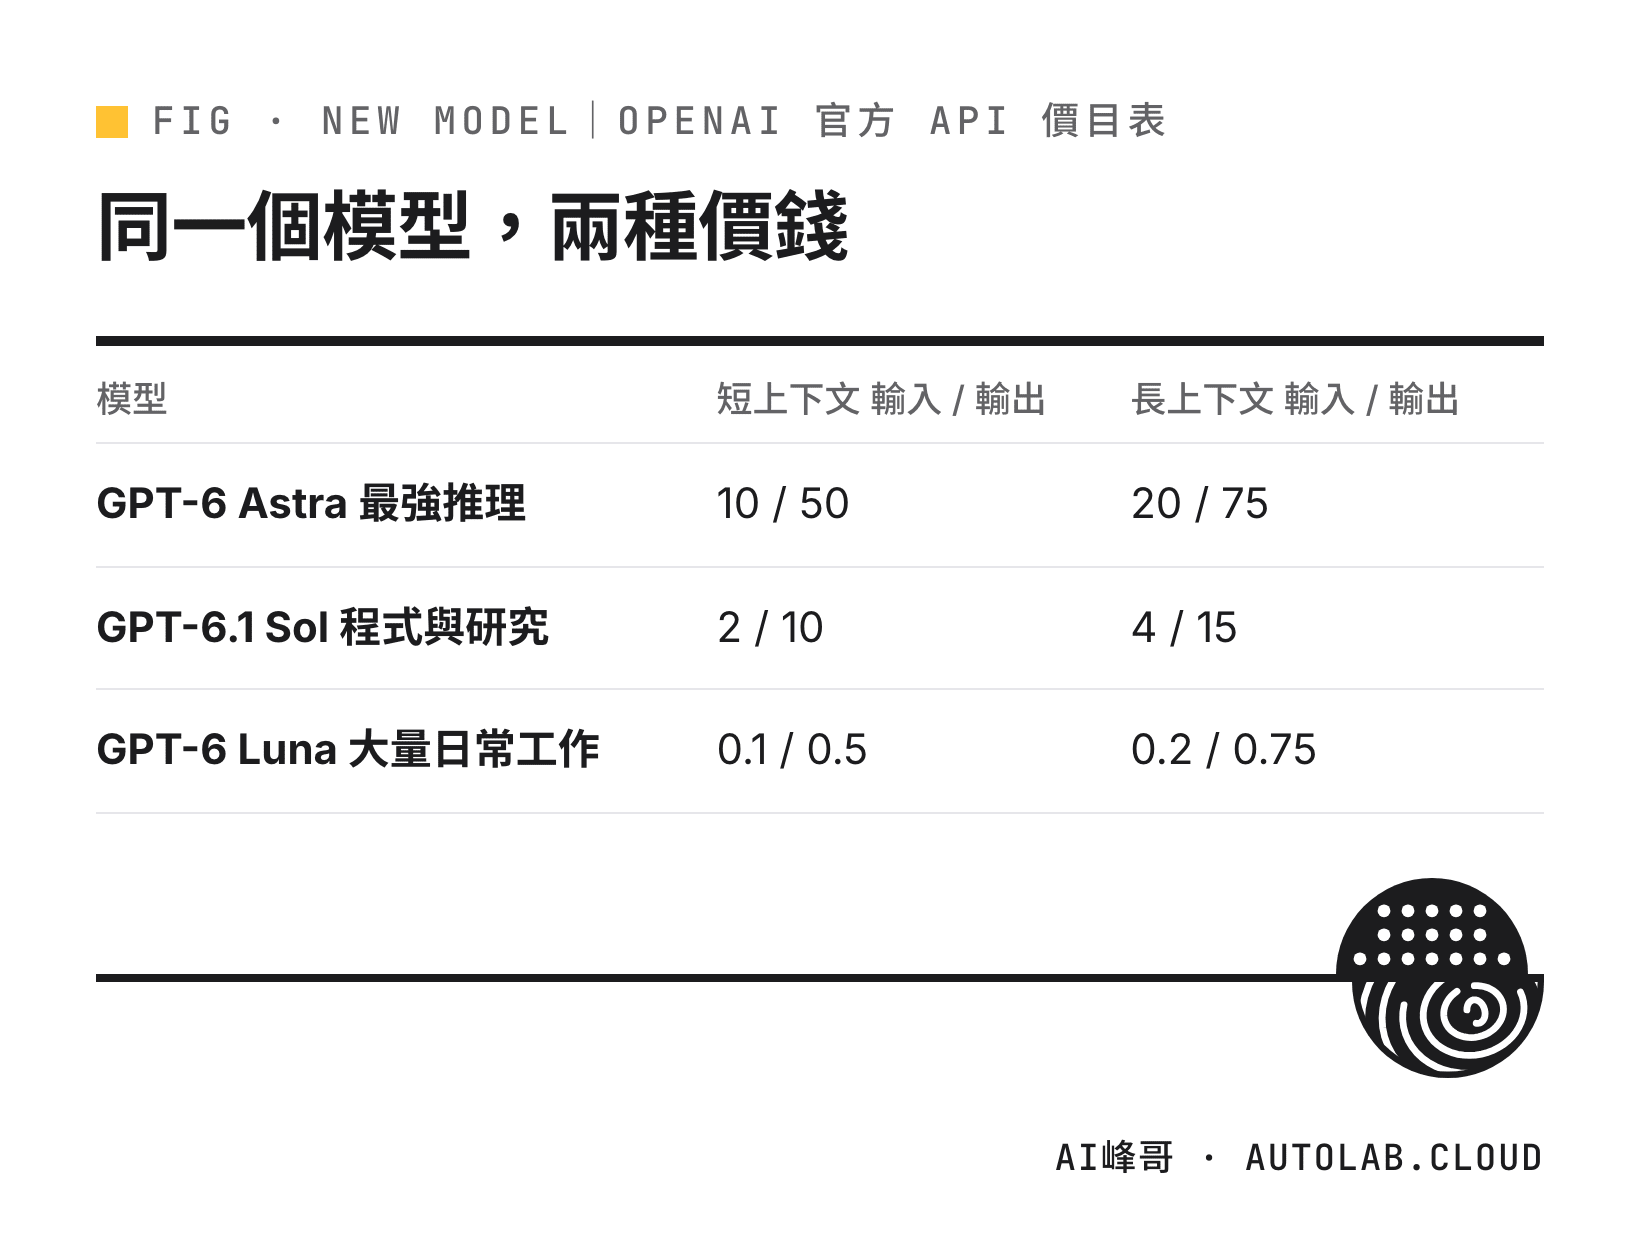
上下文一長,輸入單價直接變兩倍,輸出也漲五成。
這件事對企業用法的影響很大,因為「把整份文件丟進去」正是大家最愛的用法。價目表寫明,輸入超過 272K token 就算長上下文。一份合約通常還在門檻內,但你一次丟好幾份大文件、或對話越拉越長,就可能跨到長上下文那一欄——同一個模型、同一個問題,帳單是另一個級距。
所以官方那句「Sol 只需五分之一的價格」,嚴格講是在短上下文的前提下成立。
快取不是免費的優化
這一段是我自己對帳時最意外的發現。
官方說明裡有一句:「已快取的輸入 Token 成本比未快取的輸入 Token 最多低 95%。」聽起來是白送的省錢機會,誰不開?
我去把三個模型的快取價格一個一個算了:Astra 是 1.00 對 10.00(低 90%)、Sol 是 0.10 對 2.00(低 95%)、Luna 是 0.01 對 0.10(低 90%)。所以「最多 95%」是真的,但只有 Sol 真的到 95%,另外兩個是九成。這不是什麼大事,但它示範了一件事:官方文案裡的「最多」兩個字,通常指的是某一個特定情況。
真正會踩到的是另一欄:快取寫入(cache writes)是單獨收費的,而且比原價貴。
Astra 的快取寫入是 12.50,但它的一般輸入才 10.00。也就是說——你把一份內容寫進快取的那一次,比你不用快取還貴 25%。
照價目表三欄算一下,同一份固定前綴重複送:
- 只送一次:不用快取 10.00,用快取 12.50 →貴 25%
- 送兩次:不用快取 20.00,用快取 12.50+1.00=13.50 →開始省,約三成
- 送五次:不用快取 50.00,用快取 12.50+4.00=16.50 →省 67%
結論很單純:快取是給「同一份東西要重複用」的情境用的。一次性的工作開快取,反而加錢。這剛好對應官方自己的提醒——「估算完整工作流程的成本時,請納入快取寫入費用」。那句話藏在長長的最佳做法裡,很容易滑過去。
還有一個台灣要特別看的欄位
價目表底下有一行小字:走資料駐留(data residency)端點的,對 2026 年 3 月 5 日之後發布的模型加收 10%;美國政府 FedRAMP 端點也加收 10%。
資料駐留就是「我的資料要留在指定的國家境內處理」。金融、醫療、公部門的案子常常把這條當必要條件。
然後是比加價更要緊的一件事:我去看 OpenAI 的企業方案比較表,ChatGPT 的資料駐留支援地區列了美國、歐洲、英國、日本、加拿大、韓國、新加坡、印度、澳洲和阿拉伯聯合大公國——台灣不在名單上。而且這個功能是 Enterprise 方案才有,Business 方案沒有。
所以如果你們公司的規範是「資料不得出境」,這件事要在評估階段就講清楚,不要等到資安審查才發現。這不是 OpenAI 的問題,各家雲端服務都有類似的地區清單——重點是你要先去查,而不是假設它有。
還有一句話,跟我教的東西直接打架
這份說明裡引了 OpenAI 開發者體驗團隊 Eric Provencher 的一句話:
「模型對細微差異與模糊之處的理解能力已大幅提升,因此,過去有幫助的過度具體指引,如今反而可能影響成效。」
我得老實講:這跟我在提示詞課上教的「角色×情境×期望」寫滿一點,表面上是衝突的。
我的看法沒有變,但補一個條件:寫長寫細的價值不在模型那一端,在人那一端。你把需求寫清楚,是為了讓這份提示詞可以交接給同事、可以被重複使用、可以在出錯時看得出是哪裡沒講清楚。如果只是你自己用一次就丟,那確實不必寫成一份規格書。
真正要刪掉的是「不信任模型的那種囉嗦」——像是「請務必仔細閱讀」「不要編造」「一步一步思考」這類對新模型已經沒什麼作用的咒語。要留下的是資訊:你是誰、對象是誰、要交出什麼、什麼叫做完。前者是雜訊,後者是交辦單。
誠實踩煞車
第一,這些價格會變,而且變得很快。我查的是 2026 年 10 月 4 日的官方頁面。價目表上就寫著 GPT-5.6 Sol 的促銷價期限(10/4 查時寫 11 月 21 日,11/8 再查已改成 11 月 30 日)——它自己就在告訴你這張表有時效。你要做決策請自己去開一次官方價目表,不要照抄這篇。
第二,快取那組計算是我依價目表三個欄位推的。官方列出「輸入/快取輸入/快取寫入」三種費率,但沒有逐步說明計費順序。我假設第一次呼叫的輸入以快取寫入費率計、之後以快取輸入費率計。方向我有把握,實際帳單請以你自己的用量報表為準。
第三,便宜的模型不等於適合。我整篇都在講「別亂用貴的」,但反過來也成立:拿 Luna 去做需要推理的事,省下的錢會在重做和除錯上還回去,而且還回去的是人的時間,那個比 token 貴多了。官方的分法是「依工作負載選」,不是「挑便宜的」。
第四,我沒有實測這三個模型的品質差異。這篇講的是官方的建議與公告價格,不是評測。誰在什麼任務上比較強,要用你自己的真實任務去跑過才算數——這也正是官方那份說明反覆在講的:部署前先跑代表性任務,量成功率、延遲和每次成功的成本。
所以你該做什麼
如果你是一般上班族:你多半是在 ChatGPT 的介面裡用,不會直接碰到這些 token 單價。但這篇對你還是有一個用處——知道「最強的模型」是要拿來做難的推理,不是拿來做每一件事。下次你只是要它幫你把一段文字分類、或從一堆資料裡挑出欄位,不用特地切到最強那個再等它慢慢想。快的那個就夠了,而且快很多。
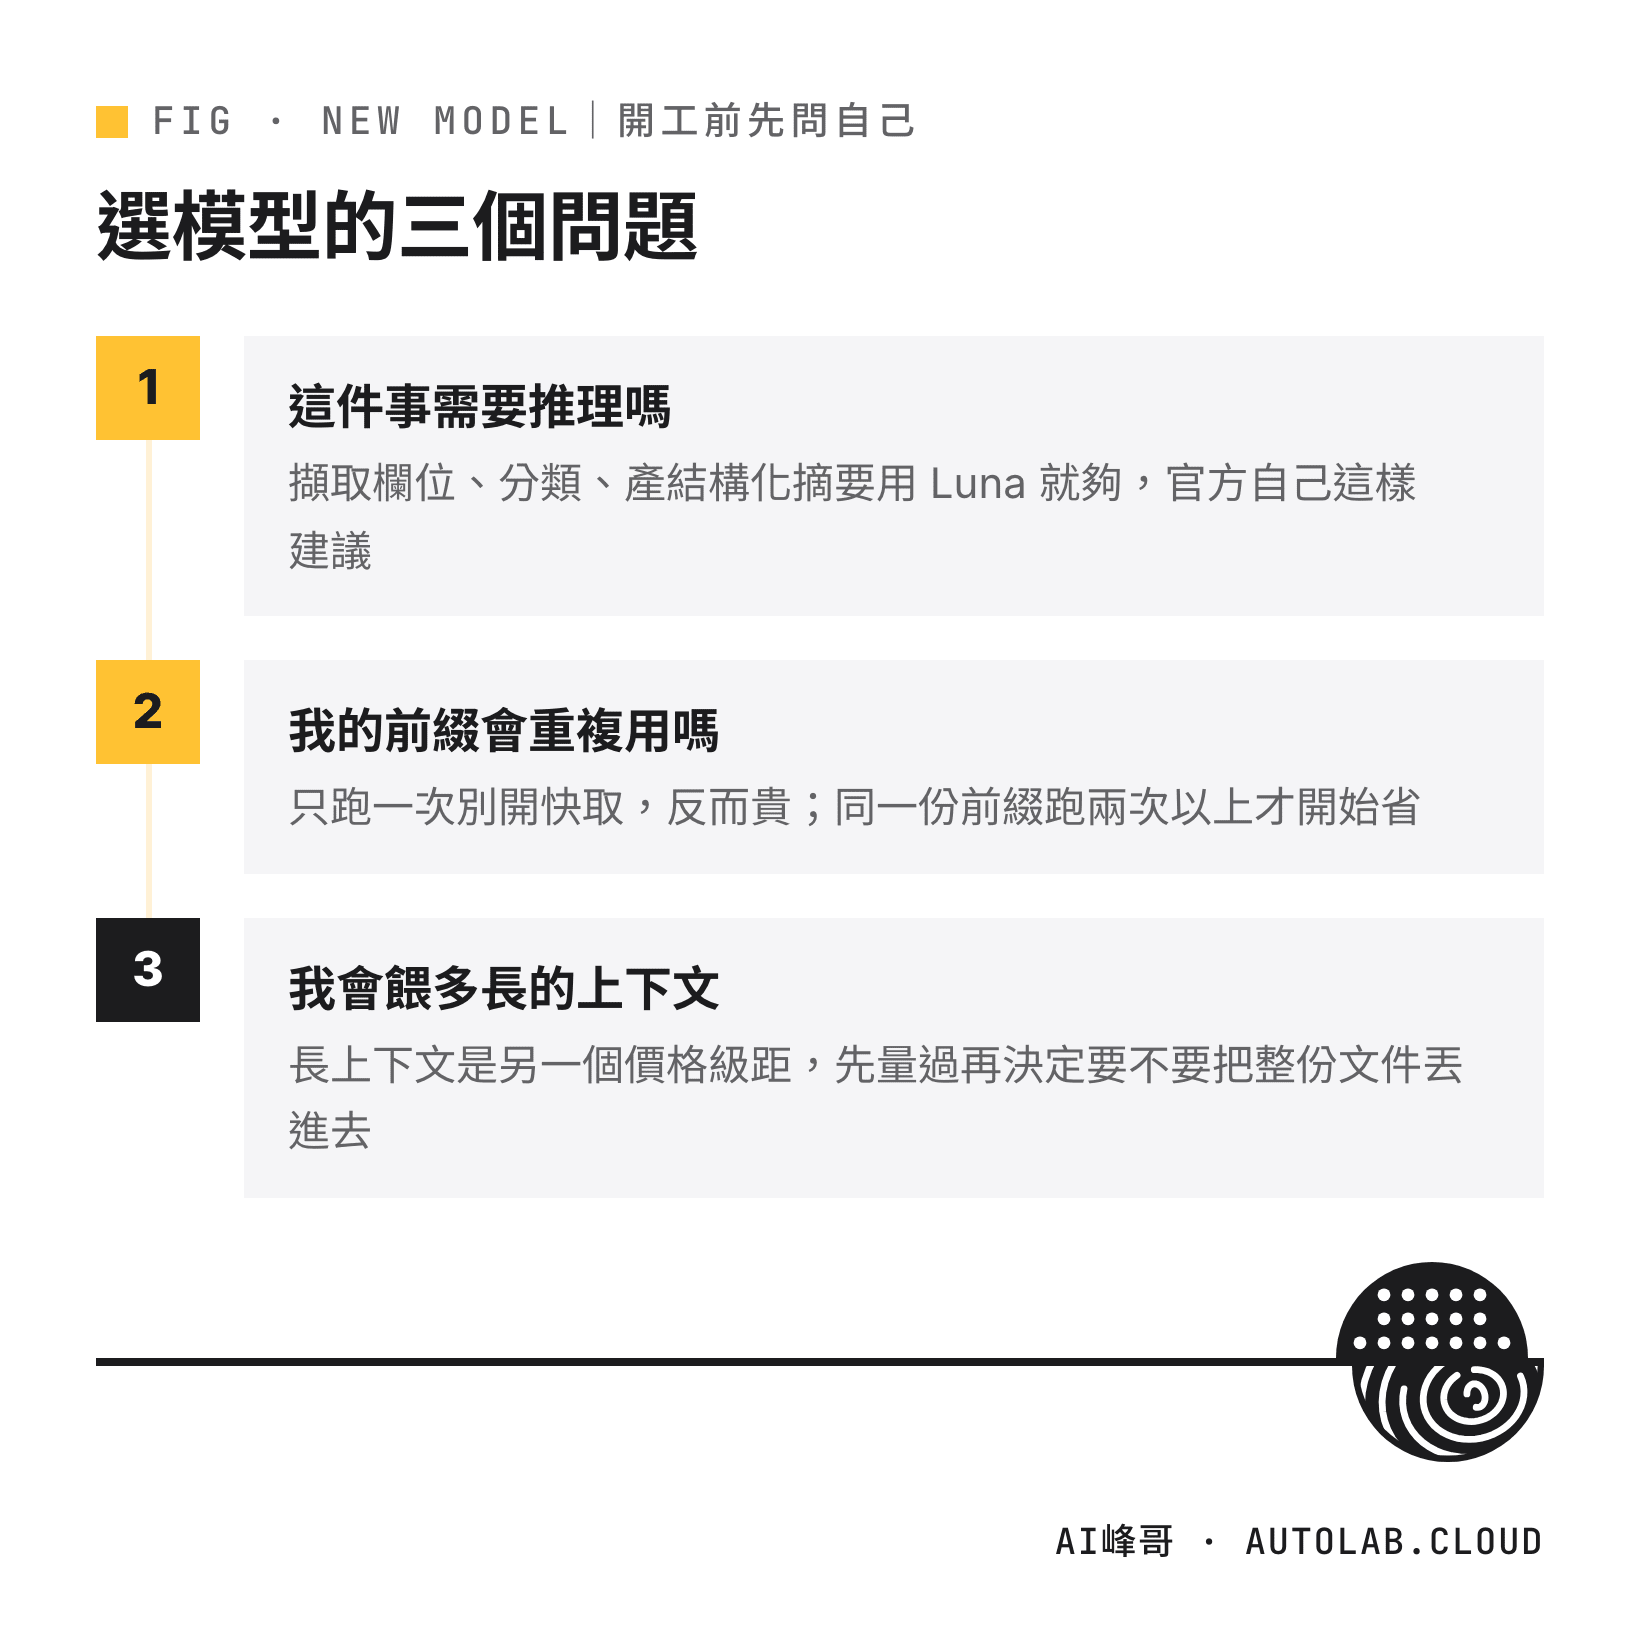
如果你要用 AI 量產東西:做一次分流。把你的工作拆成「需要判斷的」和「照規則做的」兩堆,後面那堆全部丟給便宜的模型。這件事的報酬率高得誇張——同一批工作換個模型,成本可能從 100 變成 1。另外記得那三個問題:需不需要推理、前綴會不會重複用、上下文會多長。
如果你是主管:下次聽到團隊報「我們的 AI 費用很高」,先別急著砍用量,先問一句「我們在哪些工作上用了最貴的模型」。我看過的狀況是,大部分超支不是因為用太多,是因為整條流程從頭到尾都掛在同一個最貴的模型上——包括那些只是在搬資料的步驟。另外,如果你們有資料不出境的要求,把這件事放進評估清單的第一頁,不要放在最後。
你是機長,AI 是機組人員
飛機上有自動駕駛,但機長不會整段航程都開著它最精密的模式。巡航的時候用巡航的設定,進場的時候才把資源集中起來。不是因為小氣,是因為每一種模式有它適合的階段,全程最高檔並不會讓飛機更安全,只會讓它更耗。
你帶 AI 也是一樣。你的工作不是「永遠挑最強的」,是知道哪一段需要它最強。
而這一次,連 OpenAI 自己都把這件事寫在說明書的第一頁了。
常見問題 FAQ
Q:我用 ChatGPT 網頁版,需要管這些 token 價格嗎?
不用,網頁版是按席位月費計算,不是按 token。這篇的價格是 API 的,影響的是你公司拿 API 自己串系統的那種用法。但「什麼工作該用哪一級模型」這個判斷,兩邊都適用。
Q:「長上下文」到底多長才算?
OpenAI 價目表寫明:輸入 272K token 以內算短上下文,超過 272K 算長上下文。一份合約通常還在門檻內,但一次丟好幾份大文件、或對話累積很長,就可能跨過去。要精確估算,建議直接看你帳戶的用量報表——這是會直接讓預算差一倍的事,值得先算清楚。
Q:那我乾脆全部都用最便宜的 Luna 就好了?
不行。官方給 Luna 的定位是「範圍明確、目標清楚、日常重複」的任務。需要多步推理、要跨很多資料做判斷的事,用它會得到一個看起來通順但站不住的答案——然後你要花人的時間去抓,那比省下來的錢貴得多。
Q:快取到底要不要開?
判準只有一個:同一份固定內容會不會重複送。會(例如每天跑同一份公司規章+不同的問題)就開,而且重複愈多次愈划算;只跑一次的臨時任務就別開,因為寫入那一筆比原價還貴。
Q:資料駐留台灣不在名單上,那台灣企業是不是不能用?
不是不能用,是不能宣稱「資料留在台灣境內處理」。很多公司的內規其實沒有那麼嚴,只是要求不得用於訓練、要有加密與存取控管——這些是另一套條件,跟地區駐留不是同一件事。先把你們的規範看清楚要求的到底是哪一條,再去對廠商的條件。
資料來源
以下均於 2026 年 10 月 4 日查證:
- OpenAI 官方〈GPT-6 系列模型指南〉(openai.com,2026 年 10 月 2 日,繁體中文版):三個模型的定位與建議用途原句、Astra 10/50/1、Sol 2/10/0.1、Luna 0.1/0.5/0.01 三張價目卡、「只需五分之一的價格」、「已快取的輸入 Token 成本比未快取的最多低 95%」、「估算完整工作流程的成本時,請納入快取寫入費用」、低/中/高/極高四個推理等級,以及 Eric Provencher 的引言。
- OpenAI 開發者文件・價目表(developers.openai.com/api/docs/pricing):短上下文與長上下文兩組費率(含 cache writes 欄位)、Astra 快取寫入 12.50、Sol 2.50、Luna 0.125;「資料駐留端點對 2026 年 3 月 5 日之後發布的模型加收 10%」;「GPT-5.6 Sol 的促銷價到 2026 年 11 月 30 日」(2026-11-08 再查);長上下文定義「輸入超過 272K token」(2026-11-08 再查)。
- OpenAI 企業方案比較表(openai.com/business/pricing):資料駐留支援地區清單(美國、歐洲、英國、日本、加拿大、韓國、新加坡、印度、澳洲、阿拉伯聯合大公國),以及該功能屬 Enterprise 方案、Business 方案不含。
- OpenAI 官方公告〈推出 GPT-6.1 Sol〉(openai.com,2026 年 9 月 29 日):GPT-6.1 Sol 的發布日期。
查證說明(誠實揭露):①所有價格一律取自 OpenAI 官方頁面,沒有採用任何第三方整理的價目表。②快取的三組試算(貴 25%/省三成/省 67%)是我依官方價目表的「輸入、快取輸入、快取寫入」三欄推算的,官方並未逐步說明計費順序;我假設第一次呼叫以快取寫入費率計、後續以快取輸入費率計。實際帳單請以你的用量報表為準。③「長上下文」的門檻依官方價目表為輸入超過 272K token(初稿時查不到,2026-11-08 再查補上)。④「加收 10%」與「資料駐留地區清單」來自兩個不同產品的頁面——前者是 API 價目表,後者是 ChatGPT 企業方案比較表,本文已分開敘述,請勿混用。⑤官方頁面我是用瀏覽器開的,因為 openai.com 會擋程式抓取(回 403);本文引用的是該站的繁體中文官方版本,若與英文版有出入,以英文版為準。⑥本文不是模型評測,我沒有實測三個模型的品質差異,文中的分工說法是轉述官方建議。⑦價格隨時會調整,這篇是 2026 年 10 月 4 日的快照,請勿當作長期有效的報價。
不是挑最強的,是知道哪一段需要最強
我會把官方文件裡這種「藏在最佳做法裡的錢」挑出來講:我的電子報大約一到兩週一封 → startupforyou.substack.com
如果你是主管:我的企業內訓裡有一個模組專門做「工作分流」——把團隊現在的流程攤開,標出哪幾段其實用便宜的模型就夠,課堂上用貴公司自己的流程當練習題。想聊聊寫信到 ai@autolab.cloud,或看看 AI 顧問教練團。
如果你正在規劃 2027 年的 AI 課程,不管你是 HR、訓練主管還是老師,都歡迎找阿峰老師聊聊,一起把課排對:https://autolab.cloud/corporate-training/?f=blog
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、電通、城邦媒體等。聯絡方式:ai@autolab.cloud