一句話結論
同一週兩件事:Google 在 10 月 7 日把 SynthID Detector 開放給所有人,圖、影片、音訊丟上去就能查有沒有 AI 浮水印;OpenAI 在 10 月 5 日公布文字浮水印 textGrain,但 ChatGPT 只對歐盟用戶上,偵測器也不公開。更關鍵的是 OpenAI 自己公布的數字:約 400 token 的英文文字,換掉 25% 用字,偵測率只剩 17%。所以員工問「我用 ChatGPT 寫的報告會不會被抓到」,正確答案不是會或不會,而是:公司該定的是揭露規則,不是比誰躲得過偵測。而且要先管圖,因為客戶現在已經驗得到。
我在企業內訓現場,被問最多次的一題大概就是這題:「老師,我用 ChatGPT 寫的提案,客戶抓得到嗎?」
問的人通常有點心虛,旁邊的主管通常有點期待——期待我說「抓得到」,好讓他回去可以拿工具來查。
這個月初兩家大廠剛好同時出手,給了這題一個很清楚的答案。只是這個答案,兩邊的人可能都不太想聽。
Google 這次開放了什麼
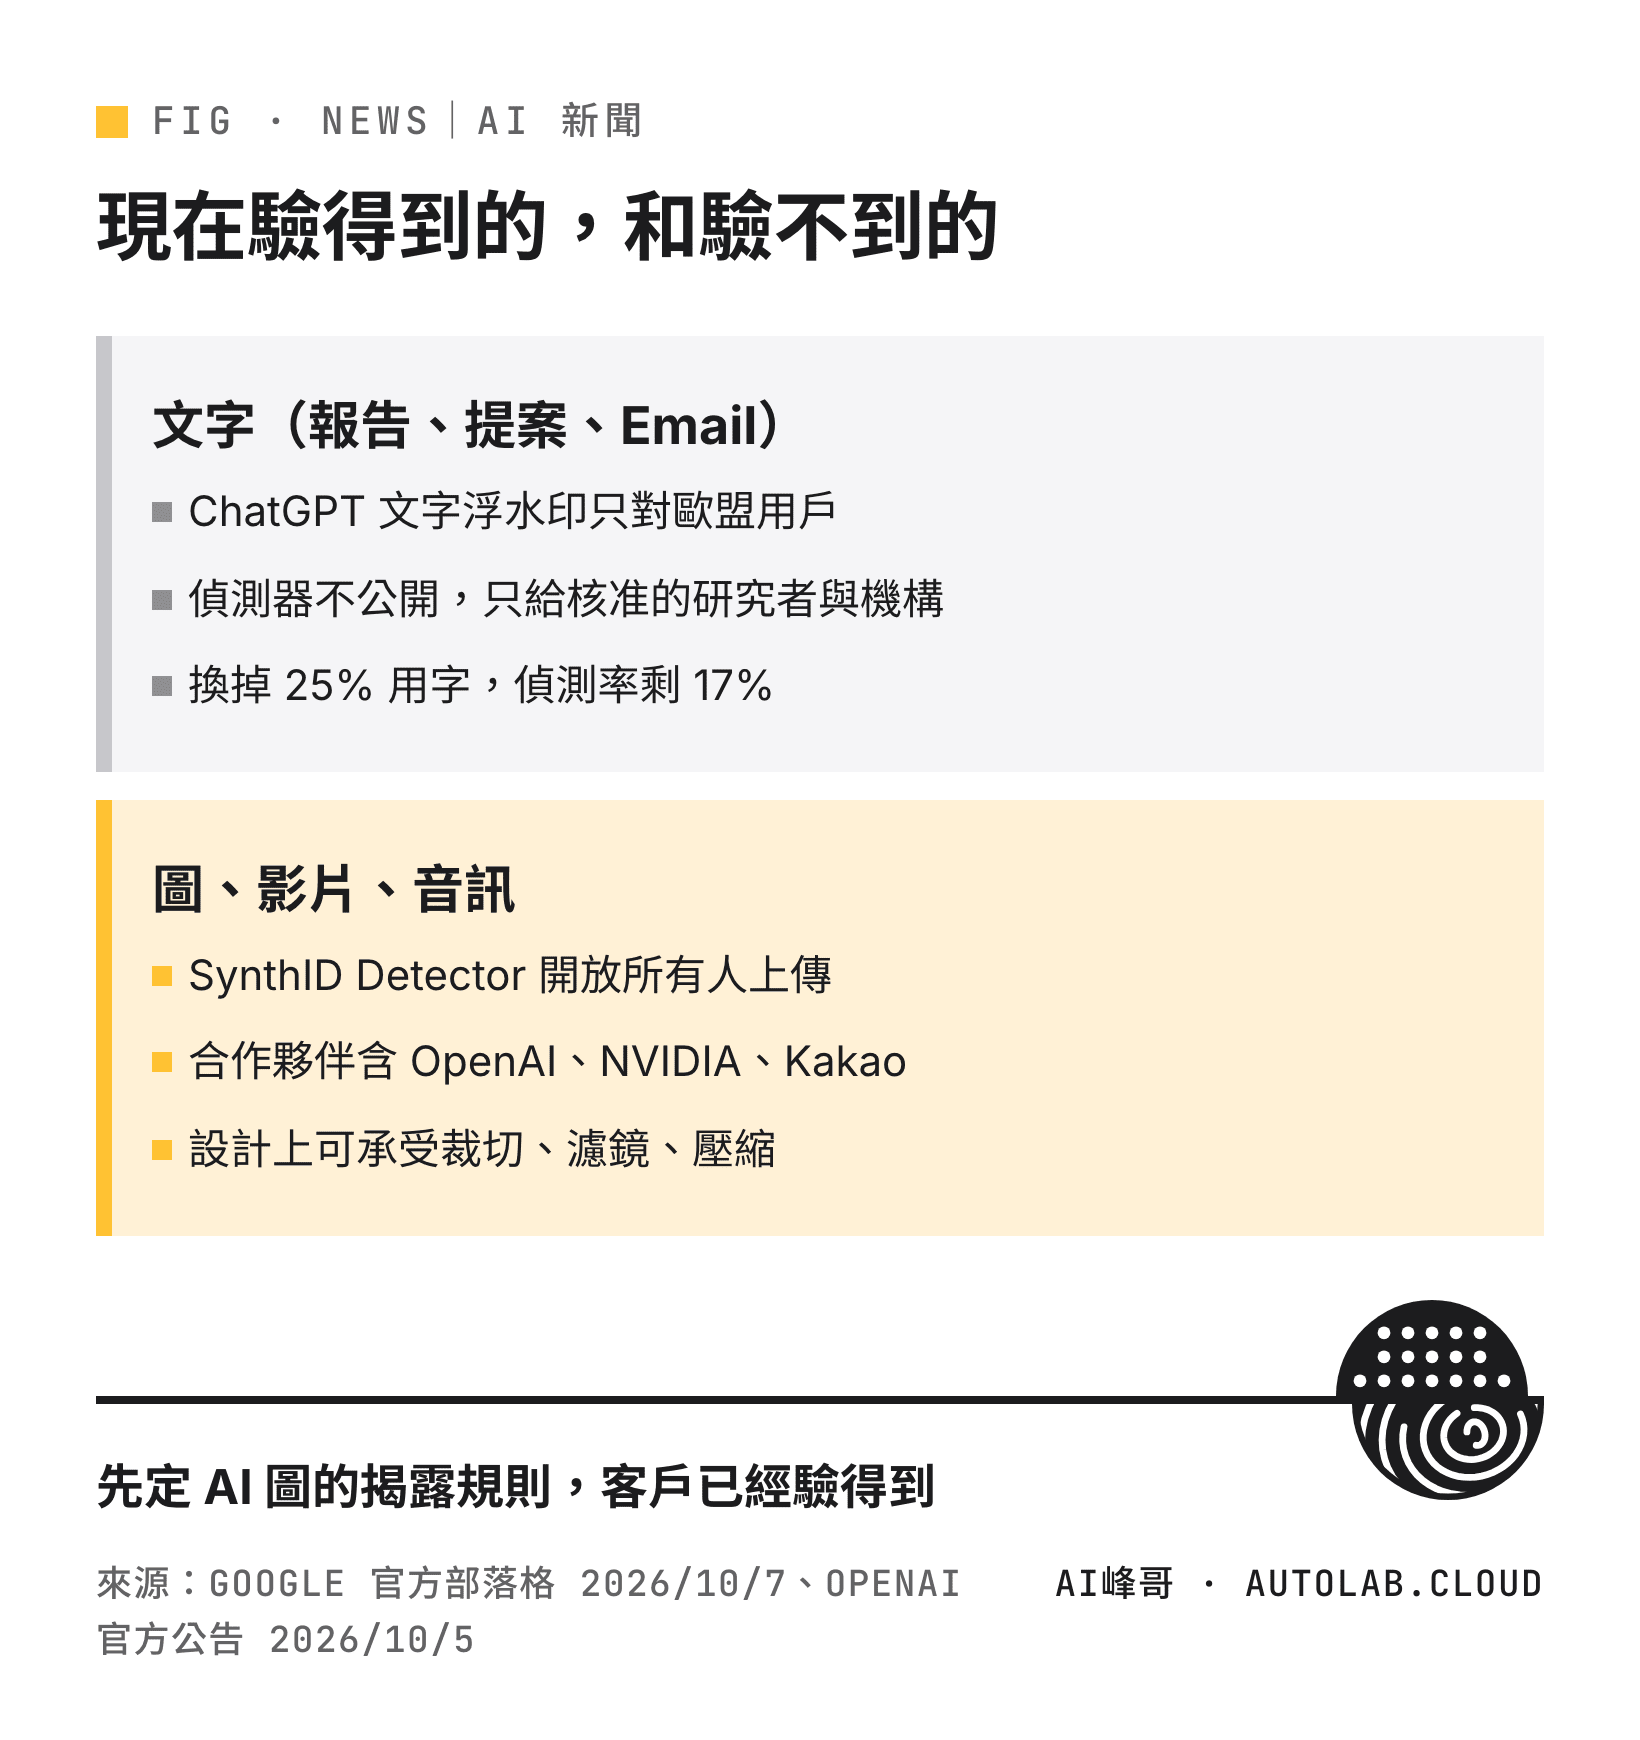
Google DeepMind 在 10 月 7 日的官方部落格宣布,SynthID Detector 擴大開放給所有人,從當天起全球可用,介面是英文。用法很單純:上傳一個圖片、影片或音訊檔,它會告訴你裡面有沒有 SynthID 浮水印。
SynthID 是 Google 從 2023 年開始在自家 AI 產出裡埋的隱形記號。依 Google 的說法,至今已經標記超過 1,800 億張圖片和影片、相當於 24 萬年長度的音訊;Google 搜尋、Gemini App 和 Chrome 內建的驗證功能,每天經常處理超過 100 萬次查詢。這些都是 Google 自己的數字,不是第三方統計。
所謂「跨業者」,指的是官方原文列出的合作夥伴:OpenAI、NVIDIA、Kakao,以及「即將加入」的 Apple。也就是說,依 Google 的說法,這幾家的 AI 產出如果有埋 SynthID,丟進同一個偵測器就能查。OpenAI 自己的公告也證實,它在支援的圖片和音訊上用了 SynthID。
但請注意三件事:
第一,它只認 SynthID。沒有埋這個記號的 AI 工具做出來的東西,它就看不到。它不是「萬用 AI 偵測器」。
第二,文字目前不在範圍內。Google 官方文寫的是圖片、影片、音訊;iThome 的報導也明講目前尚未支援文字偵測。
第三,結果只能單向參考。依 iThome 轉述 Google 的提醒:偵測到浮水印,不代表整份內容都是 AI 做的,可能只是部分經過 AI 修改;沒偵測到,也不能據此認定不是 AI 做的。
OpenAI 的 textGrain:只上歐盟,而且自己把弱點攤開
OpenAI 在 10 月 5 日發表〈Our approach to EU text provenance rules〉,公布文字浮水印技術 textGrain。範圍要看清楚:
ChatGPT 和 Codex:未來幾週內,對歐盟用戶「符合條件」的文字產出加上隱形浮水印,所有方案都適用。官方原文寫的是 EU only,不是全球預設。
API:全球客戶可以針對部分模型自行選擇開啟,預設是關閉的。
偵測器:開放申請,但一開始只給通過審核的研究者和專業機構,逐案核准,上線時不公開。
原理跟 Google 的文字版 SynthID 是同一類:不是在字裡藏什麼隱形符號,而是模型選字時加一點極細微的偏好,累積成一段人眼看不出、但拿祕密金鑰算得出來的統計特徵。OpenAI 另外發了一份 20 頁的技術報告講數學細節。它也說在自己的測試中,textGrain 的表現追平或超過包括 SynthID 文字版在內的其他方法——這是 OpenAI 自己的評估。
真正值得你記下來的,是 OpenAI 自己公布的限制數字。注意這是兩組不同的測試:
・長度測試(誤判率設定為 1%):約 200 token 的心理學這類內容,偵測率約 80%;拉長到約 400 token,約 95%。
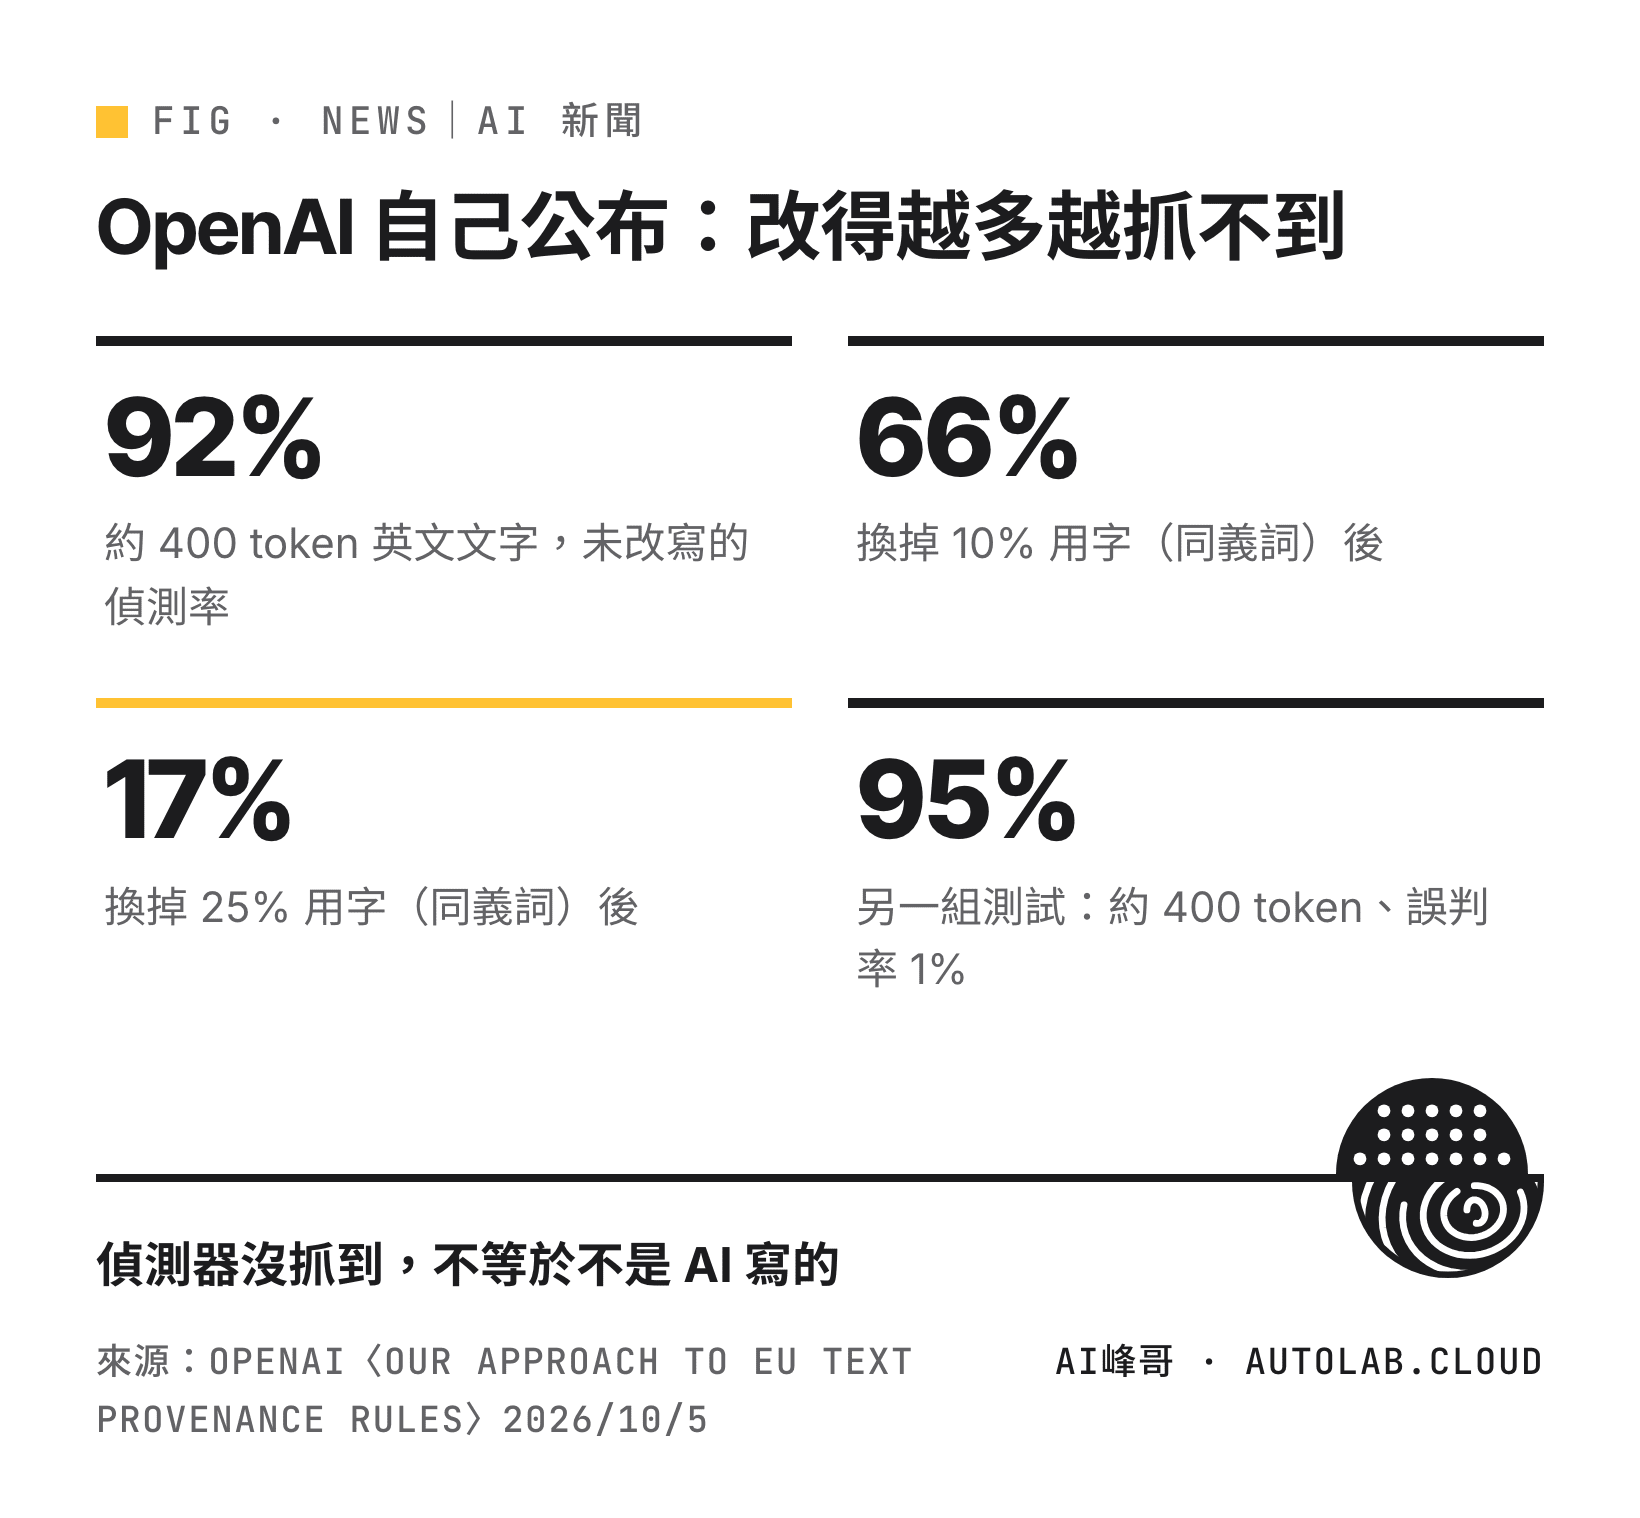
・換字測試(另一組約 400 token 的英文問答文字,OpenAI 沒寫誤判率設在多少):換掉 10% 用字成同義詞,偵測率從約 92% 掉到 66%;換掉 25%,剩 17%。
官方也寫明:文字太短、被編輯過、被翻譯過,偵測都可能不可靠;數學這類可選用字很少的內容也比較難抓。
為什麼偏偏是現在:歐盟 AI 法第 50 條
兩家同一週動作,背後是同一條法:歐盟《人工智慧法》(AI Act)第 50 條第 2 項。它要求產生合成音訊、圖片、影片或文字的 AI 系統提供者,要讓產出帶有機器可讀的標記,並能被偵測為 AI 生成或修改。
這條有兩個前提一定要一起引:第一,是「在技術上可行的範圍內」,並考量內容型態與實作成本;第二,AI 系統只做輔助性的一般編輯,或沒有實質改變輸入內容或其語意的情況,不適用。
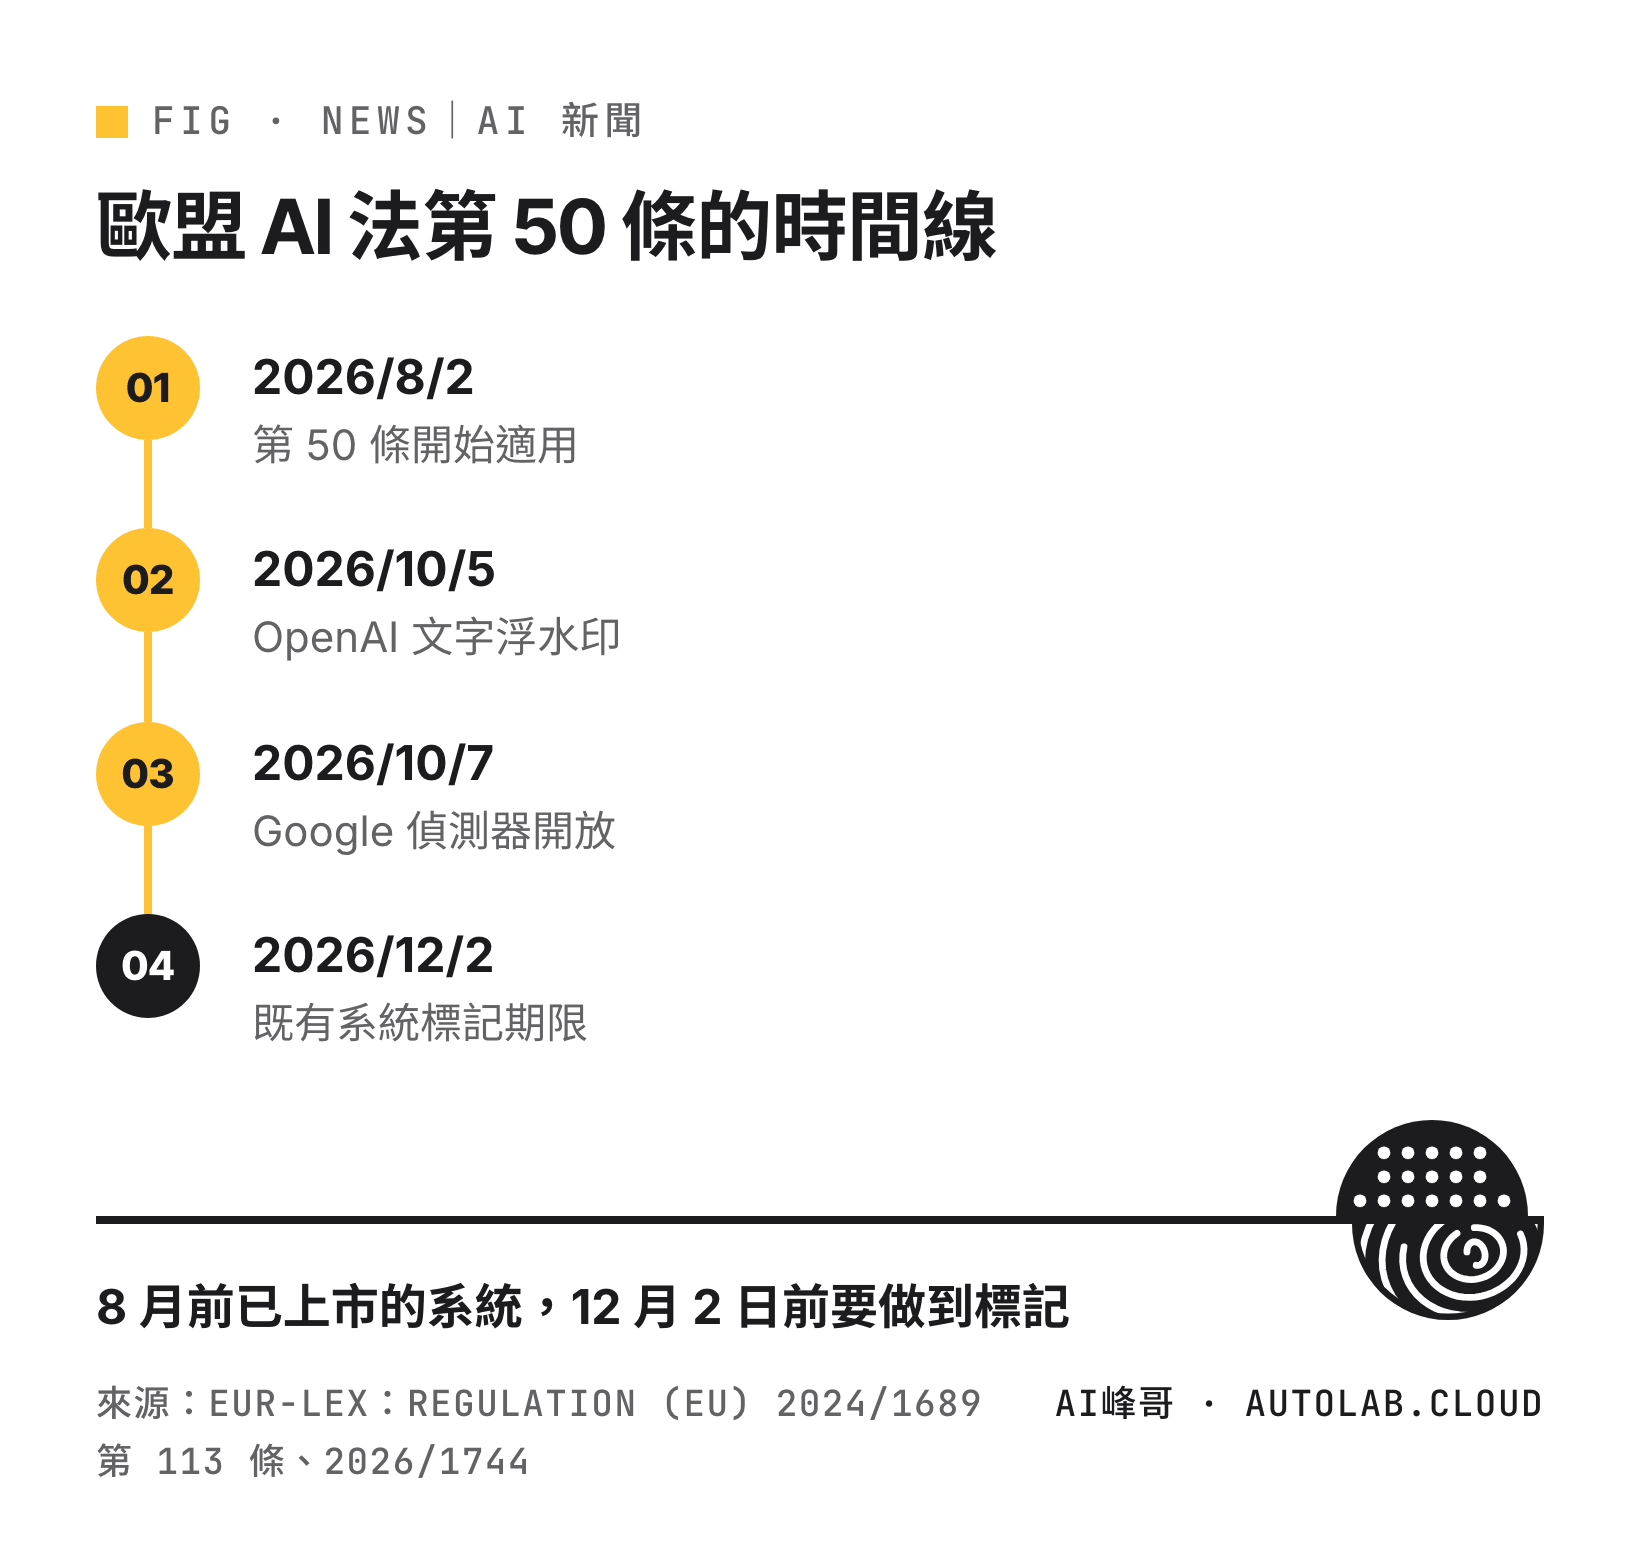
時程也要講準。依第 113 條,AI 法多數條文(含第 50 條)自 2026 年 8 月 2 日起適用;但今年 7 月通過的《Digital Omnibus on AI》(歐盟規則 2026/1744)新增了一條過渡規定:8 月 2 日前已經上市的系統,要在 2026 年 12 月 2 日前做到第 50 條第 2 項。所以 OpenAI 說「未來幾週」,時間點對得上這個期限——這是我的推論,OpenAI 的公告裡沒有寫條號或日期。
阿峰的現場觀點:員工問錯了題,主管也想錯了工具
回到開頭那題。我現在的回答分成兩半。
給員工的那一半:你在台灣用 ChatGPT 寫的報告,依 OpenAI 這次的公告,文字浮水印只對歐盟上;就算是歐盟,偵測器也不給一般人用。所以「被浮水印抓到」這件事,短期內對你多半不會發生。但這不是好消息,因為你問錯題了。客戶在意的從來不是「你有沒有用 AI」,是「你有沒有交代清楚、有沒有自己負責」。被抓到才承認,跟一開始就講明,信任感差很多。
給主管的那一半:偵測器沒抓到,不等於不是 AI 寫的。OpenAI 的數字已經說明:換掉四分之一用字就只剩 17%;你只要叫另一個沒浮水印的模型潤一次稿,結果就更難說。反過來,誤判率 1% 聽起來很小,但如果你拿這種門檻去掃 1,000 篇真人寫的東西,算術上大約就有 10 篇會被冤枉(這是我拿 1% 做的算術示意,不是 OpenAI 的實測)。拿偵測器當考核工具,抓不到想躲的人,還會傷到老實的人。
那 AI 應用要怎麼落地?我在課堂上會請學員直接用 ChatGPT 或 Gemini 做這件事:「把我們部門常交出去的東西列出來,依『對外/對內』、『圖/文』分類,幫每一類寫一句揭露規則草稿。」十分鐘就能有一份初稿,再由主管拍板。這比買任何偵測工具都快,也有用得多。
誠實踩煞車
第一,「跨業者」沒有你想的那麼跨。Google 的偵測器只認 SynthID。OpenAI 的 textGrain 文字、其他家自己的文字浮水印,它都看不到。Apple 也還是「即將」。
第二,偵測結果兩個方向都不能當證據。有記號,可能只是 AI 潤過稿;沒記號,可能是用了沒埋記號的工具、改寫過、翻譯過。OpenAI 也明講,浮水印不能衡量人類貢獻多少、不能判定所有權或責任、不能辨識使用者、也不能驗證內容對錯。
第三,OpenAI 的偵測率是它自己的測試。換字測試用的是英文問答文字,長度測試沒寫語言,繁體中文的效果不能直接套用。token 跟中文字數的換算也因模型而異,我不幫你硬換算。
第四,市面上那些「AI 文字偵測器」跟這套不是同一回事。它們多半是看用詞和句型去猜,原理不同,而且一樣會誤判。
第五,我不是律師。歐盟 AI 法的條文與過渡期,我讀的是官方公報原文,但實際適用要看歐盟後續指引和你公司的業務範圍。
| 你做的東西 | 現在的浮水印狀況 | 誰驗得到 | 建議怎麼定規則 |
|---|---|---|---|
| AI 生成的圖、影片、音訊 | Google 與合作夥伴(OpenAI、NVIDIA、Kakao)的產出可能埋有 SynthID | 任何人,上傳 SynthID Detector | 對外素材一律標註「AI 生成」,最先定 |
| 在台灣用 ChatGPT 寫的文字 | 依 OpenAI 公告,ChatGPT 文字浮水印只對歐盟用戶 | 浮水印這條路,一般人驗不到 | 依用途揭露,不靠偵測 |
| 歐盟用戶的 ChatGPT/Codex 文字 | OpenAI 10/5 公告「未來幾週」上 textGrain(2026 年 10 月 20 日查證,尚未查到全面上線的官方公告) | 只有核准的研究者、專業機構 | 有歐盟業務的團隊先跟法務對一次 |
| 公司用 OpenAI API 自建的工具 | 預設關閉,部分模型可自選開啟 | 同上 | 由 IT 決定開不開,並寫進內規 |
所以你該做什麼
如果你是一般上班族:不要再研究怎麼「洗掉」AI 痕跡。花同樣的時間,把 AI 產出的每個數字和事實自己核一遍,然後在交出去時簡單講一句「初稿用 AI 協助,數據我已核對」。你會發現客戶在意的是第二句。
如果你是要量產內容的人(行銷、設計、社群):你的 AI 圖,客戶現在自己就能丟上去驗。先跟主管定好:哪些對外素材要標註、標在哪裡。不要等客戶驗出來再解釋。
如果你是主管:做三件事。一、不要把任何 AI 偵測結果寫進考核或懲處依據。二、用一頁就好,定出「圖、文、對內、對外」四格的揭露規則。三、如果公司有歐盟客戶或分公司,把這篇的第 50 條段落轉給法務,12 月 2 日不遠了。
你是機長,AI 是機組人員
飛機上每一次操作都有紀錄,但沒有一個機長會這樣想:「只要黑盒子查不到,這個決定就不算我的。」
浮水印就像黑盒子,是事後查證的工具,而且還是會漏的那種。真正讓乘客安心的,是機長在起飛前就廣播:「今天由我負責,副駕協助。」
AI 寫的報告也一樣。揭露不是自首,是簽名。你主動說清楚哪段是 AI 協助、哪段是你核過的,這份東西就是你的。偵測器抓不抓得到,從此跟你無關。
常見問題 FAQ
Q:我在台灣用 ChatGPT 寫報告,客戶抓得到嗎?
依 OpenAI 10 月 5 日的公告,ChatGPT 的文字浮水印只對歐盟用戶上,偵測器也不公開,所以靠浮水印抓到你的機會很低。但這不是重點,重點是你們公司有沒有揭露規則。被問到才承認,比一開始講明更傷信任。
Q:SynthID Detector 能檢查文字嗎?
目前不行。Google 官方公告寫的是圖片、影片、音訊;iThome 報導也明講尚未支援文字。而且它只認得 SynthID 這種記號,不是萬用的 AI 偵測器。
Q:偵測器沒抓到,可以證明是人寫的嗎?
不行。OpenAI 自己的測試顯示,約 400 token 的英文文字換掉 25% 用字,偵測率就只剩 17%;翻譯、太短也會讓偵測不可靠。OpenAI 明講沒偵測到不能證明是人寫的,iThome 也轉述 Google 有同樣的提醒。
Q:主管可以用 AI 偵測工具來考核員工嗎?
我不建議。偵測結果兩個方向都不可靠:抓不到會躲的人,還可能冤枉老實的人。以誤判率 1% 為例,掃 1,000 篇真人寫的東西,算術上約有 10 篇會被誤判(算術示意,不是實測)。該考核的是產出品質和事實有沒有核對。
Q:歐盟的規定跟台灣公司有關嗎?
如果你有歐盟客戶、分公司或在歐盟提供 AI 服務,就有關。AI 法第 50 條自 2026 年 8 月 2 日起適用,8 月 2 日前已上市的系統過渡到 2026 年 12 月 2 日。實際是否適用請找法務確認。
資料來源
以下於 2026 年 10 月 11 日查證;Google 與 OpenAI 公告、Apple 的 SynthID 狀態於 2026 年 10 月 20 日再次確認:
- Google 官方部落格:Pushmeet Kohli(Google DeepMind 副總裁)的 SynthID Detector 公告(blog.google,2026 年 10 月 7 日):SynthID Detector 擴大開放給所有人、即日起全球英文可用;可檢查圖片、影片、音訊;合作夥伴 OpenAI、NVIDIA、Kakao 與即將加入的 Apple;1,800 億張以上圖片與影片、24 萬年音訊;Search、Gemini App、Chrome 內建驗證每天經常超過 100 萬次查詢。原文未列限制。這是 Google 自己的說法。
- Apple 官方新聞稿〈Apple debuts iPhone 18 Pro and iPhone 18 Pro Max〉(apple.com,2026 年 9 月):寫的是「upcoming support for the SynthID standard」,註腳說 SynthID 會在今年稍晚的軟體更新推出、依編輯方式納入多數編修過的圖片。2026 年 10 月 20 日查證,Apple 仍是「即將」,跟 Google 寫的「soon, Apple」一致。
- Google DeepMind SynthID 官方頁(deepmind.google):SynthID 可標記圖片、音訊、文字、影片;圖片與影片設計上可承受裁切、濾鏡、改變影格率、有損壓縮;音訊可承受加雜音、MP3 壓縮、變速。
- OpenAI 官方:〈Our approach to EU text provenance rules〉(openai.com,2026 年 10 月 5 日):textGrain;歐盟 ChatGPT 與 Codex 符合條件的文字、所有方案、未來幾週(2026 年 10 月 20 日再查,公告頁仍寫「over the coming weeks」,沒有查到 OpenAI 宣布已全面上線);API 全球可自選開啟、預設關閉;偵測器僅限核准研究者與專業機構;誤判率 1% 時 200 token 約 80%、400 token 約 95%;另一組 400 token 英文問答(ELI5)測試中,同義詞替換 10%、25% 後由約 92% 降至 66%、17%(未載明誤判率);太短、編輯、翻譯會影響偵測;浮水印不能衡量人類貢獻、所有權、使用者身分或正確性;圖片與音訊另用 C2PA 與 SynthID。這是 OpenAI 自己的測試。
- OpenAI textGrain 技術報告(cdn.openai.com,2026 年 10 月 5 日,20 頁):浮水印以祕密金鑰與前文產生的偽隨機值影響選字;偵測只需要文字與金鑰。
- 歐盟 AI 法(Regulation (EU) 2024/1689)(eur-lex.europa.eu):第 50 條第 2 項標記義務、「技術上可行範圍內」前提與輔助編輯例外;第 113 條自 2026 年 8 月 2 日起適用。
- Digital Omnibus on AI(Regulation (EU) 2026/1744)(eur-lex.europa.eu,2026 年 7 月 8 日,公報 2026 年 7 月 24 日):新增 AI 法第 111 條第 4 項,8 月 2 日前已上市系統須於 2026 年 12 月 2 日前符合第 50 條第 2 項。
- iThome〈Google全面開放SynthID Detector,支援跨業者AI內容辨識〉(ithome.com.tw/news/179517,2026 年 10 月 8 日):中文對照報導;偵測器目前不支援文字、Google 對偵測結果意義的提醒。
- iThome〈OpenAI推出文字浮水印textGrain以因應歐盟AI法令〉(ithome.com.tw/news/179435,2026 年 10 月 6 日):中文對照報導,指出依據為 AI 法第 50 條第 2 款。
查證說明(誠實揭露):①openai.com 對自動抓取回應 403,OpenAI 公告內容是透過網頁轉文字服務讀取全文後整理,數字與 iThome 報導一致,但 iThome 把換字測試寫成跟 1% 誤判率同一條件,OpenAI 原文並沒有這樣寫,本文以原文為準;OpenAI 公告頁本身沒有標日期,10 月 5 日依技術報告與 iThome;技術報告 PDF 則是直接下載閱讀。②OpenAI 公告沒有寫 AI 法條號或日期,「第 50 條第 2 項」來自 iThome 與歐盟法規原文的對照;「OpenAI 的時程對得上 12 月 2 日期限」是我的推論。③SynthID Detector 網站本身是互動程式,我無法讀到頁面文字;「偵測到不代表全是 AI、沒偵測到不代表不是 AI」這點,出自 iThome 轉述 Google 的提醒,我在 Google 部落格原文中沒有看到這段;「目前不支援文字」則有兩個出處:Google 部落格原文只列圖片、影片、音訊,沒有提到文字,「尚未支援文字偵測」這句明講則是 iThome 自己的報導寫法,不是轉述 Google;登入方式與支援格式也只有 iThome 一個來源,所以本文不寫。④Google 原文沒有區分 OpenAI、NVIDIA、Kakao 是「已全面支援」還是部分支援,本文因此寫「可能埋有」。⑤OpenAI 的偵測率是它自己的測試;換字測試是英文 ELI5 問答,長度測試沒寫語言,繁中效果未知。⑥「掃 1,000 篇約 10 篇誤判」是依 1% 誤判率做的算術示意,不是 OpenAI 的實測。⑦OpenAI 公告中「符合條件的文字」沒有定義排除哪些內容,我查不到。⑧我不是律師,本文不構成法律意見。
比起躲偵測,先定揭露規則
這類法規和廠商公告,我會拆成「現在要做」跟「還早」兩堆:我的電子報大約一到兩週一封 → startupforyou.substack.com
公司想導入 AI、安排內訓 → 企業內訓諮詢表單(課堂上直接用貴公司的文件,十分鐘做出第一版 AI 揭露規則)
通勤用聽的 → Podcast《下班學AI》
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、中嘉寬頻、電通、城邦媒體等。聯絡方式:ai@autolab.cloud