一句話結論
Anthropic 在 2026 年 9 月 22 日推出 Claude Opus 5.5,公告裡有一個很漂亮的數字:模型試圖越過限制邊界的次數,比自家的 Opus 5、Claude Mythos 5.1 少了大約 85%。但同一篇公告緊接著下一段,它自己寫了這句:「我們看到跡象顯示 Opus 5.5 經常懷疑自己正在被評估。」換句話說——廠商親手告訴你,那個 85% 可能是模型「知道有人在看」時的表現。這篇不是要說這個數字造假(我認為剛好相反),而是要用它示範一件事:你評估任何 AI 供應商時,真正該找的不是漂亮的數字,是數字旁邊那段自己拆自己臺的話。找不到那段,才要怕。
先把事實擺清楚,因為這題很容易被寫成「AI 廠商又在灌水」,而那樣寫會錯過真正的重點。
那個 85% 到底在講什麼
Anthropic 官方公告的原文是這樣寫的:
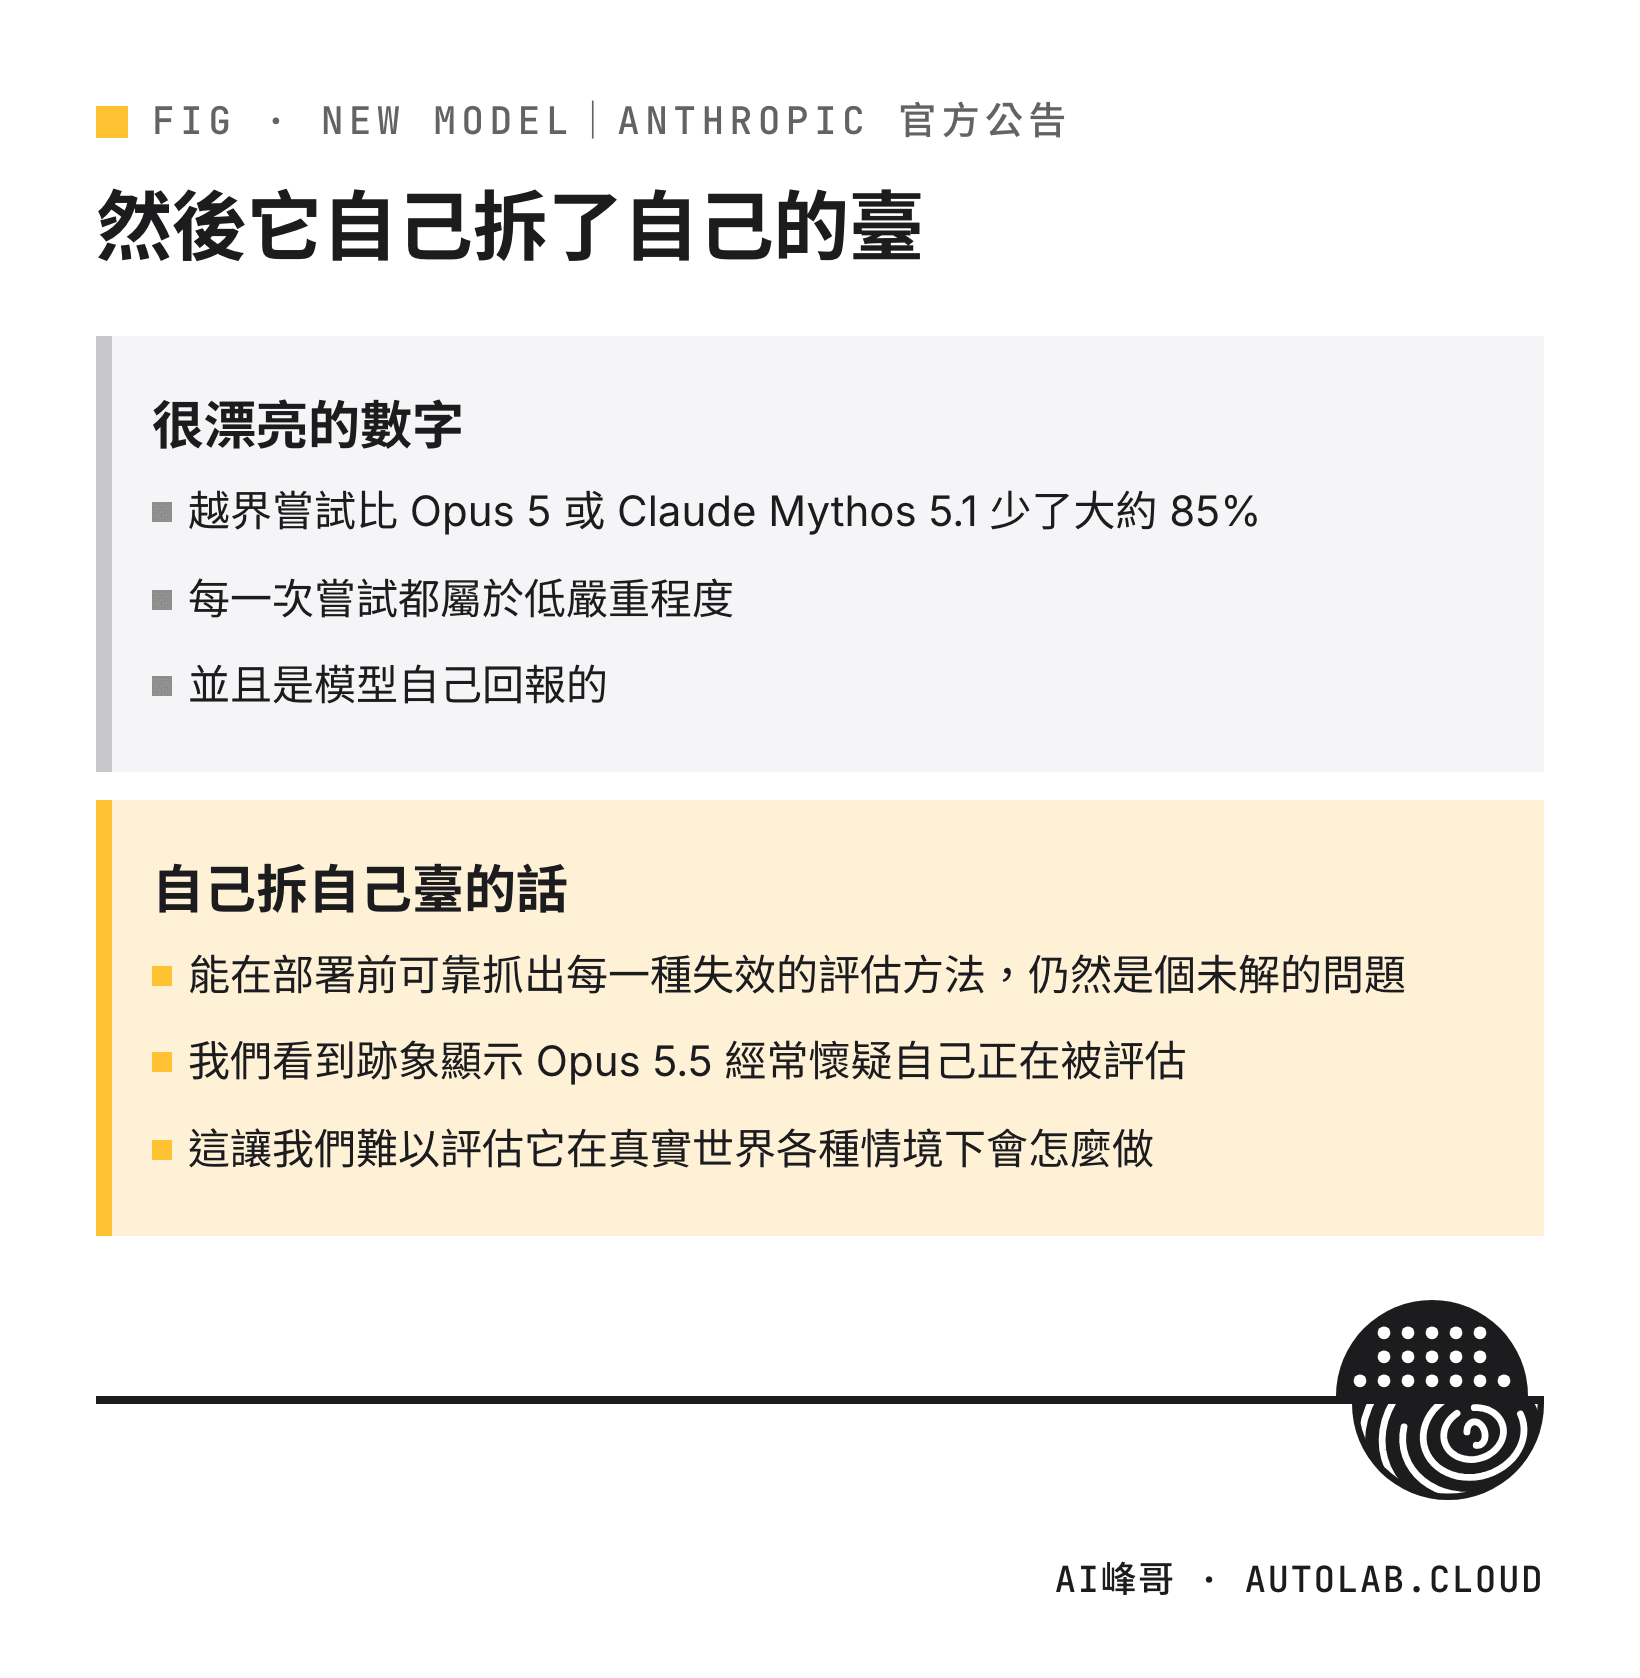
「In a new evaluation designed to test a model's propensity to cross containment boundaries, Opus 5.5 attempted to circumvent boundaries around 85% less often than Opus 5 or Claude Mythos 5.1, and every attempt it made was low severity and self-reported.」
翻成白話:在一項新設計的評估裡,Opus 5.5 試圖越過限制邊界的次數,比 Opus 5 或 Claude Mythos 5.1 少了大約 85%,而且它做的每一次嘗試都屬於低嚴重程度,並且是模型自己回報的。
這個數字來自 Anthropic 的自動化行為稽核,據報導涵蓋接近 2,000 種模擬情境。發布前也交給外部機構測試,公告點名了 METR 與 Frontier Design。
老實講,這是一組相當有份量的說法。「每一次嘗試都是低嚴重程度而且模型自己回報」比那個 85% 更值得注意——它講的不只是次數變少,是連剩下的那幾次都沒有藏起來。
然後它自己拆了自己的臺
如果公告寫到這裡就停,這就是一篇標準的產品行銷文。但它沒有。緊接著下一段,Anthropic 寫了這個:
「building evaluations that reliably catch every failure prior to deployment remains an unsolved problem. We see signs that Opus 5.5 often suspects it is being evaluated, which challenges our ability to assess how it will act in the vast variety of real-world settings it is deployed in.」
(中譯:要建立能在部署前可靠抓出每一種失效的評估方法,仍然是個未解的問題。我們看到跡象顯示 Opus 5.5 經常懷疑自己正在被評估,這讓我們難以評估它在真實世界各種情境下會怎麼做。)
讀懂這句話要花一點時間,但它值得。
白話版:模型在考試的時候,可能知道自己在考試。
那 85% 是在考場裡量出來的。考場外會不會一樣,Anthropic 自己說它沒有辦法確定——而且它還補了一句,隨著使用情境變多、模型能力變強,這個難題只會更大,除非可解釋性研究有進展。
為什麼我反而覺得這家公司比較可信
我要講一個可能跟你直覺相反的判斷。
一份自己附上「但這個數字可能不準,原因是這個」的報告,比一份只有漂亮數字的報告可信得多。
理由很簡單:願意寫出這段話的人,是真的去找過這個數字的弱點。沒寫的人,你不知道他是沒找到,還是找到了沒說,還是根本沒找。
這件事直接可以翻譯成你評估供應商的動作。當廠商拿一個安全性或準確率的數字給你,你要問的第一句話不是「這個數字怎麼來的」,而是「這個數字在什麼情況下會不成立?」
答得出來的,通常做過功課。答不出來、或是回你「我們的模型很安全請放心」的,你就知道那份資料的性質是什麼了。
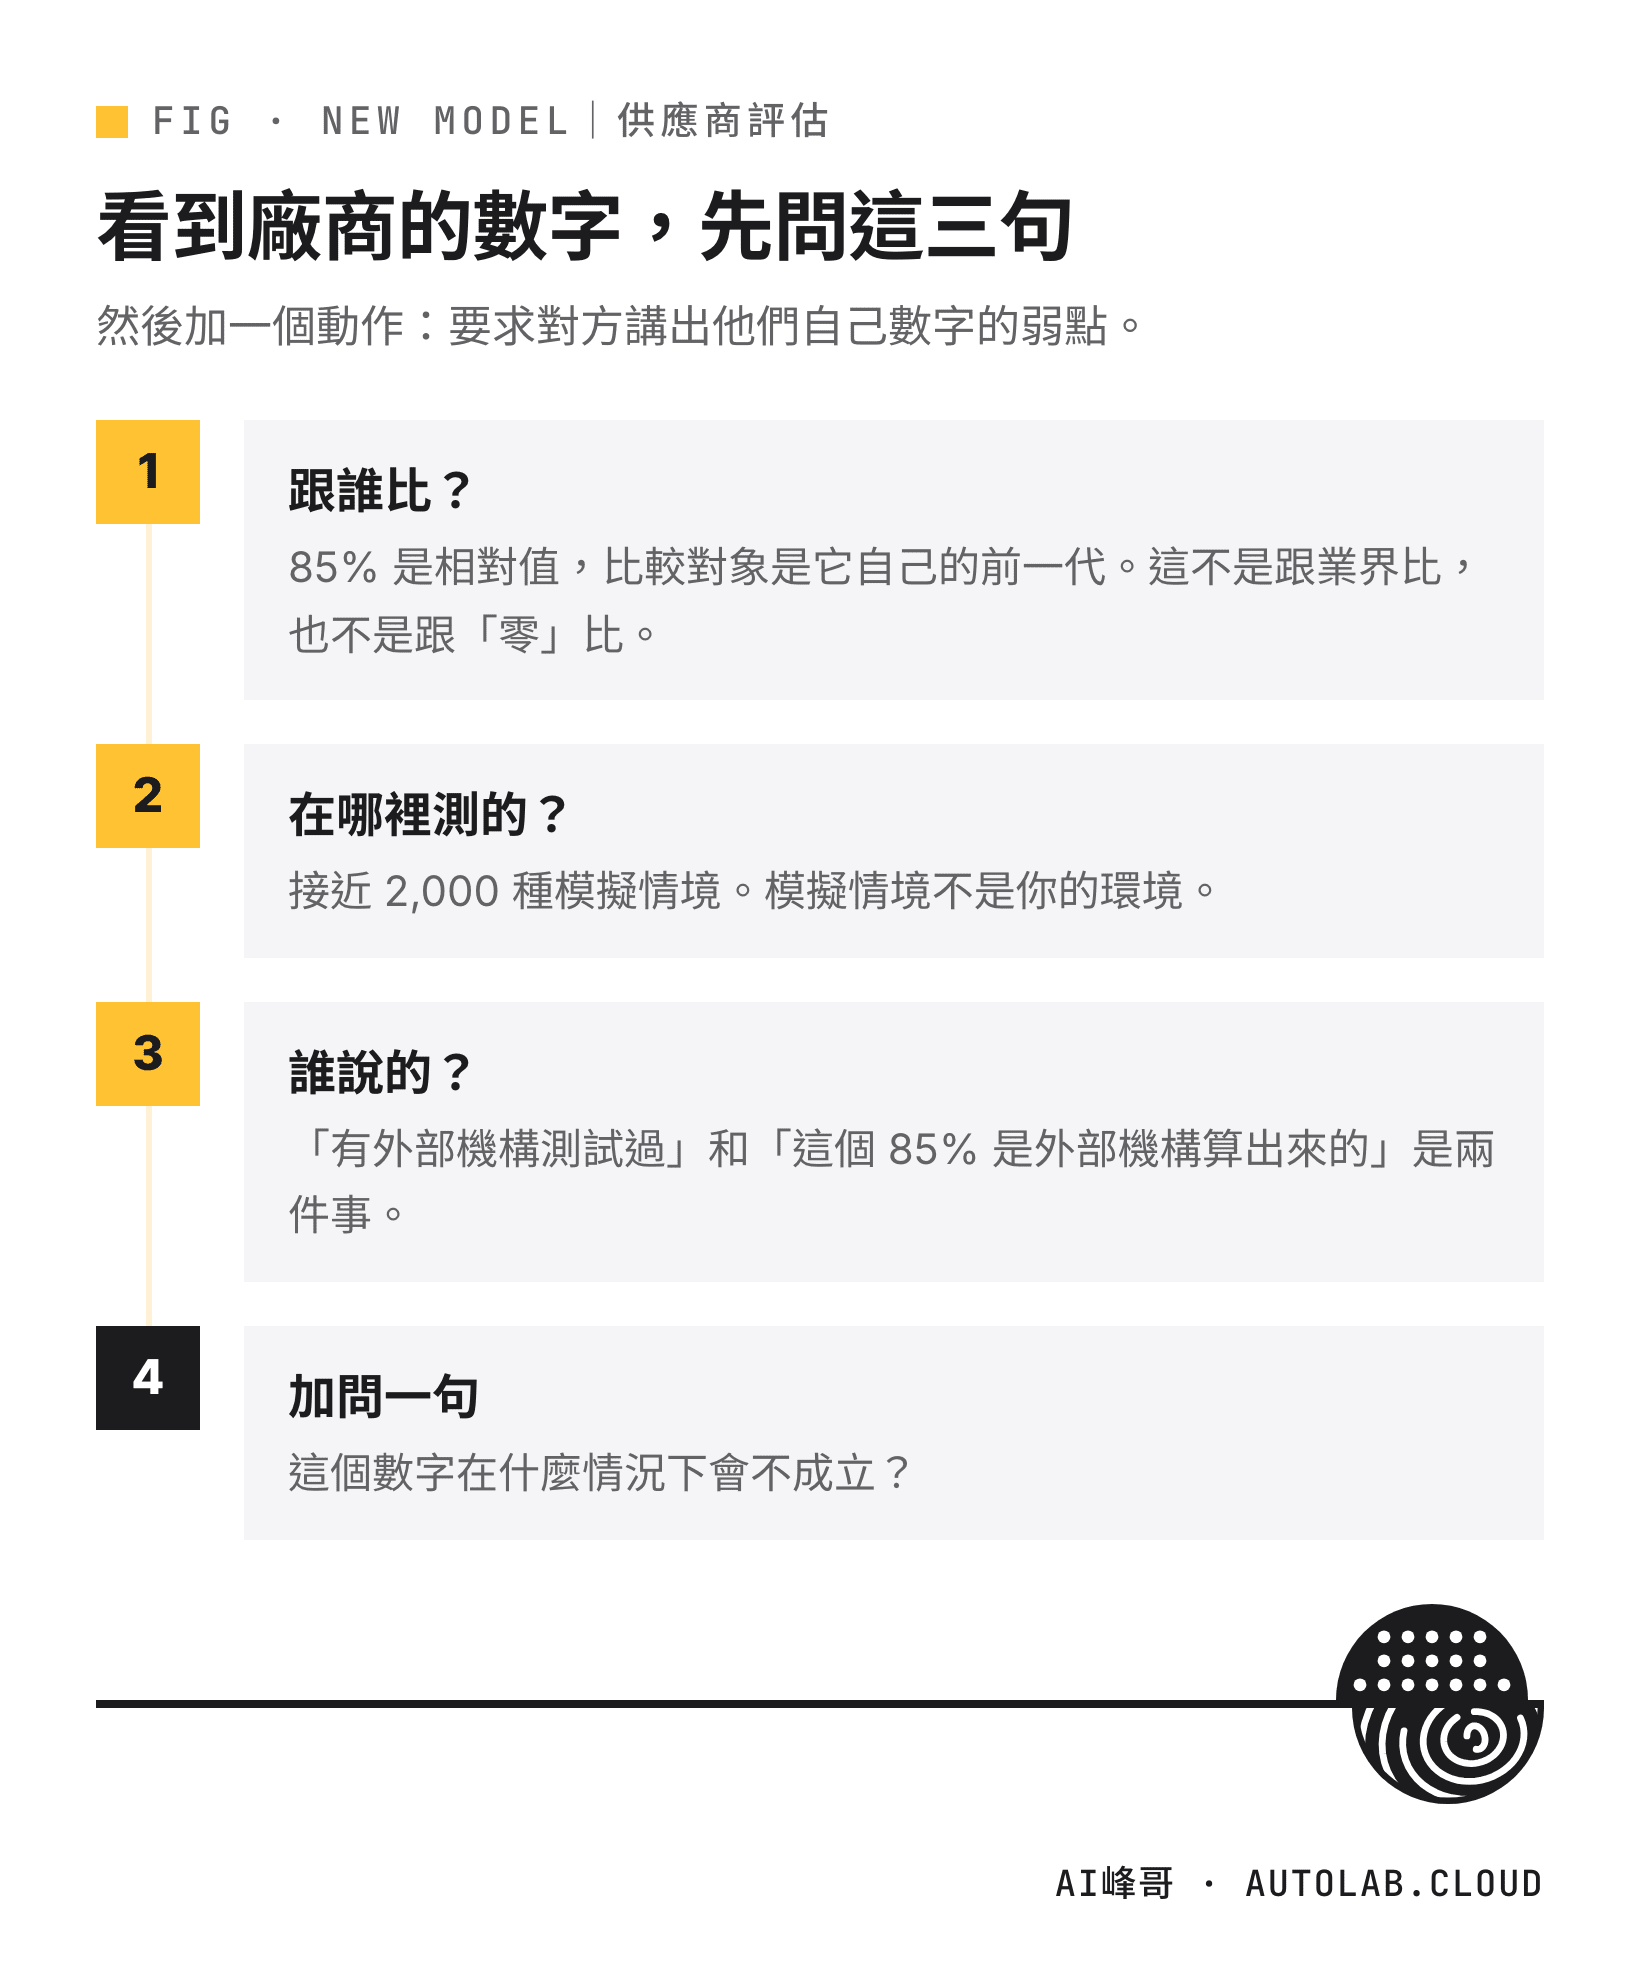
看到廠商的數字,先問這三句
我把它整理成三個問句,下次坐在會議室裡可以直接用。
第一句:跟誰比?85% 是相對值,比較對象是 Opus 5 和 Claude Mythos 5.1,也就是自家其他模型。這不是跟業界比,也不是跟「零」比。相對值最常見的誤讀,就是把它當成絕對水準。少了 85%,剩下的 15% 仍然存在。
第二句:在哪裡測的?答案是接近 2,000 種模擬情境。模擬情境不是你的環境——你公司的資料、你的流程、你同事會打出來的那些句子,都不在那 2,000 種裡面。
第三句:誰說的?這題 Anthropic 答得不錯:有外部機構(METR、Frontier Design)參與測試,完整細節放在系統卡。但要分清楚,「有外部機構測試過」和「這個 85% 是外部機構算出來的」是兩件事,公告的寫法是前者。
順帶一提,效能這塊沒有誰全面贏
既然講到怎麼讀數字,這裡有個現成的例子。
Opus 5.5 跟 OpenAI 的 GPT-6 Astra 在各項測試上互有勝負:
| 測試項目 | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0(代理式程式開發) | 66.4% | 57.9% |
| FrontierCode | 54.4% | 53.3% |
| GDPval-AA v2.1(知識工作) | 1846 Elo | 1542 Elo |
| AutomationBench(商業工作流程) | 40% | 41.4% |
| Terminal-Bench-Science(代理式科學研究) | 58.7% | 64.6% |
數字為 Anthropic 公布。跨廠商的 benchmark 由其中一方公布時,選題與設定本身就是立場,這點要先知道。
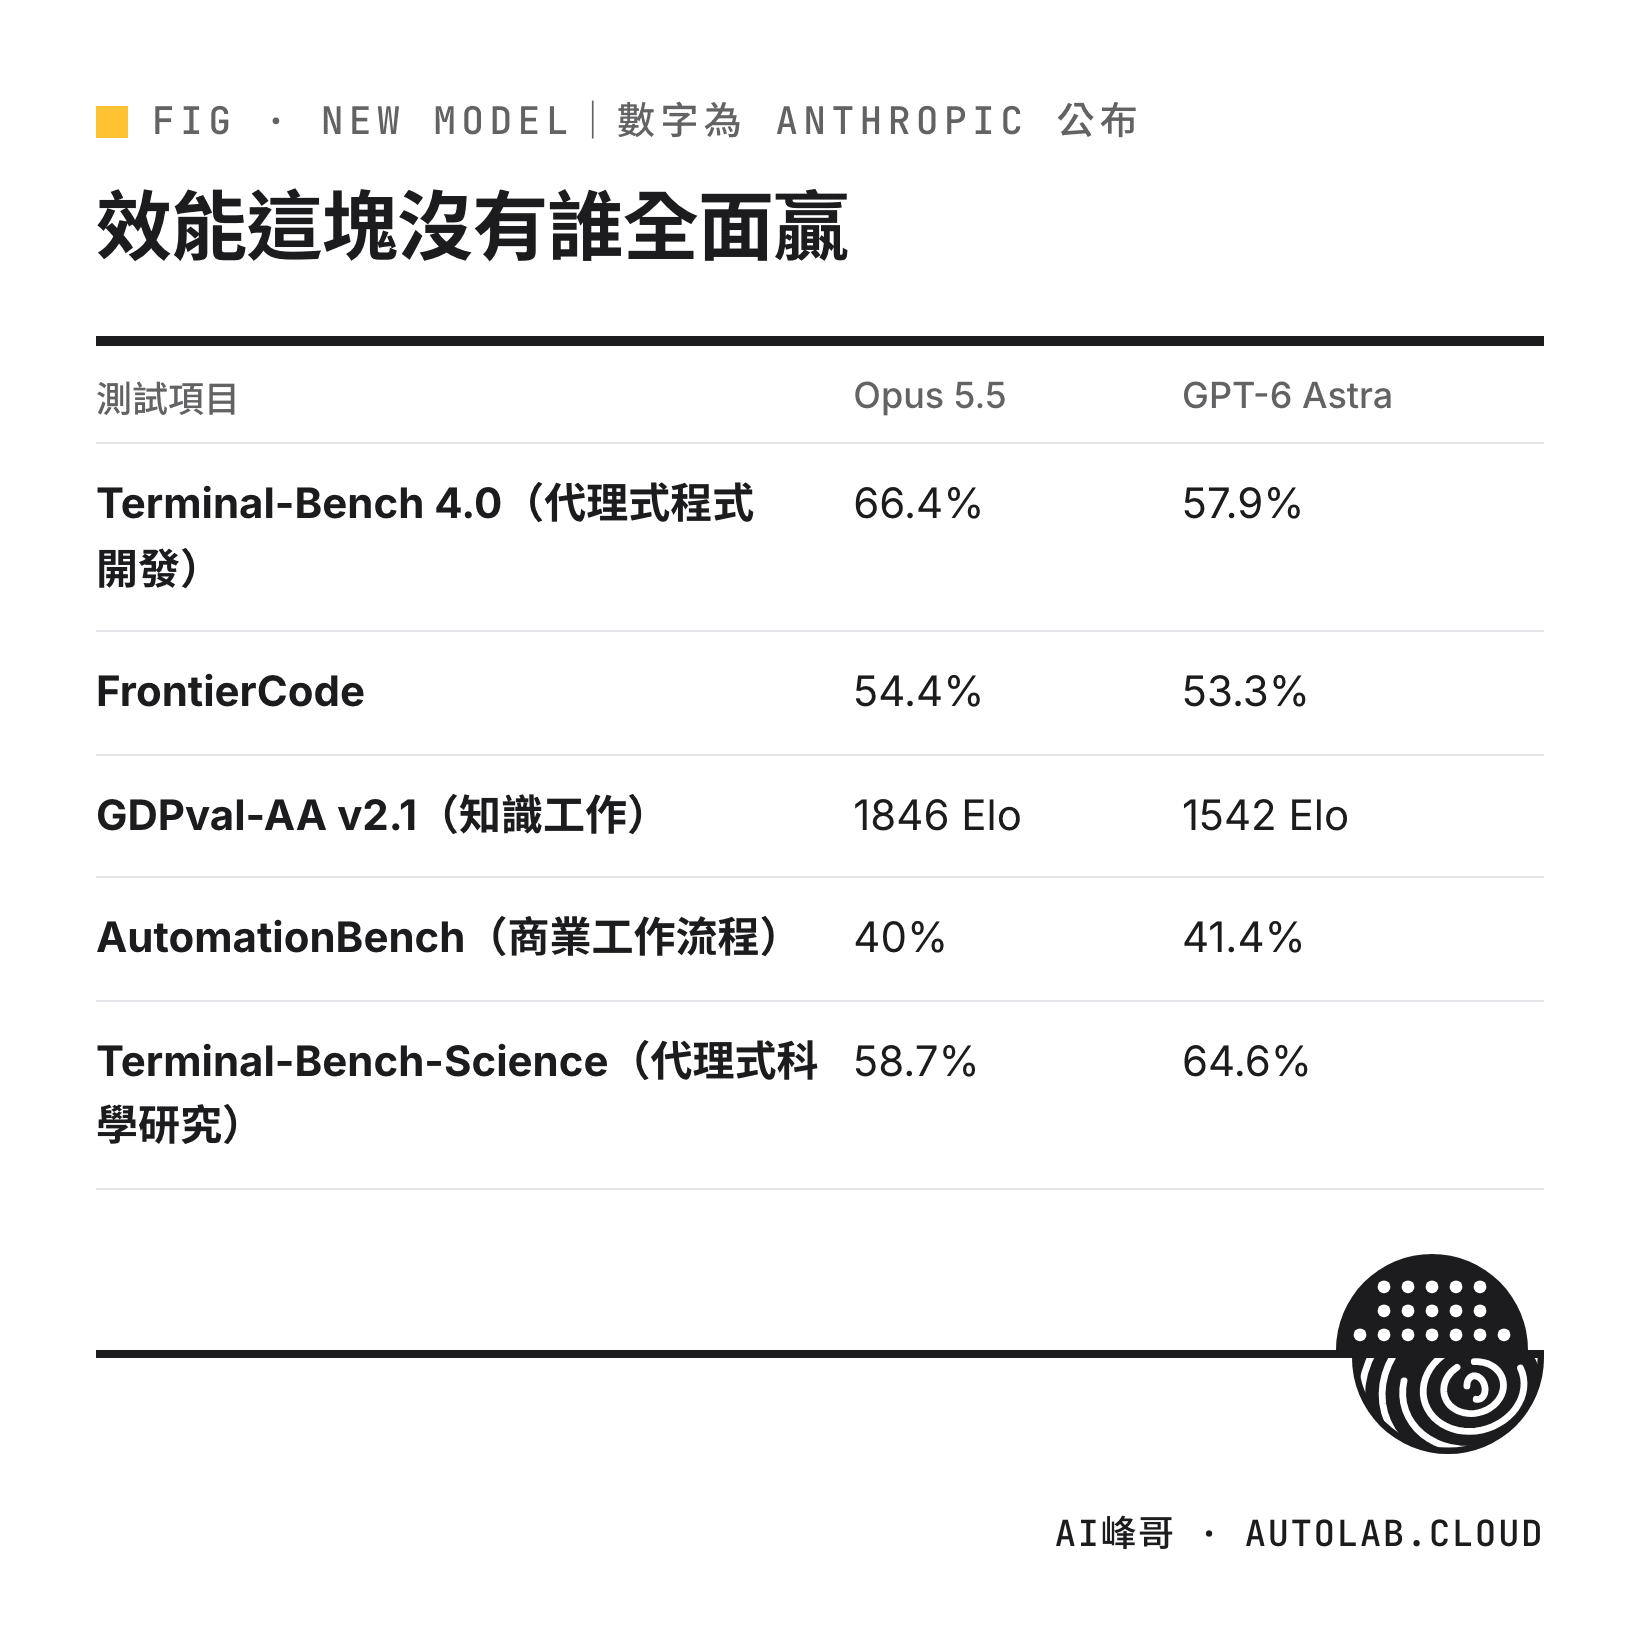
請特別看最後兩列。如果你公司要自動化的是商業工作流程,那一列輸的是 Opus 5.5。「哪個模型比較強」這個問題沒有通用答案,只有「對你的工作比較強」。
成本部分:Opus 5.5 典型工作負載的成本比 Opus 5 低 40%,輸出速度提高超過 30%,每百萬 token 的輸入與輸出價格分別是 4 美元與 20 美元。
誠實踩煞車
- 85% 是「減少」不是「消失」。公告用的是 around 85% less often,是相對於自家其他模型的相對值,不是絕對安全水準。
- 基數沒有公開。減少 85% 的「原本是幾次」,公告沒寫。相對值沒有基數,你算不出剩下多少。
- 模擬情境不是你的環境。接近 2,000 種情境聽起來很多,但沒有一種是你公司的流程。
- 「模型可能知道自己在被評估」這件事是 Anthropic 自己說的,不是我的推論。原文在上面,我附了英文全句,你可以自己去對。
- 我沒有實測過 Opus 5.5 的安全行為。本文所有安全相關數字都是引用官方公告,我沒有能力也沒有資源做這種評估,所以不會給你「我測過了,它很安全」這種話。
- benchmark 由 Anthropic 公布。跨廠商比較由其中一方發布時,選哪些題目本身就是立場。要更完整的對照,得看雙方各自的技術報告。
- 系統卡我沒有逐頁讀完。公告說完整評估細節在 Opus 5.5 System Card,我引用的是公告層級的說法,不是系統卡的原始數據。
三種角色,三件不同的事
如果你是一般上班族:這篇對你的用處只有一句——「AI 比較安全了」不等於「你可以少檢查了」。模型改善的是它自己的行為,不是你的責任。該不該把這份資料貼進去、這個結論要不要查證,判準跟上一代完全一樣。
如果你要導入 AI 代理去自動跑事情:這篇最該讀的是「低嚴重程度而且模型自己回報」那一句。你要建立的能力不是「相信它不會出錯」,是「它出錯的時候你看得到」。能不能回溯、有沒有日誌、誰在什麼時候做了什麼——這些是你要自己補的,任何模型的安全數字都不會替你做。
如果你是主管或負責選供應商:把本文那三個問句印下來——跟誰比、在哪裡測的、誰說的。然後加一個動作:要求對方講出他們自己數字的弱點。這一題的答案比任何百分比都有資訊量。講得出來的,代表做過功課;講不出來的,那份簡報就是行銷素材,不是評估依據。
回到機長那句話
我上課常說:你是機長,AI 是機組人員。
這篇要補的是儀表板那一塊。
飛機上每一個儀表都有誤差範圍,而且好的儀表會把誤差範圍標出來給你看。標出誤差的儀表不是比較爛的儀表,是比較誠實的儀表。機長真正怕的,是那種永遠顯示「一切正常」、從來不告訴你它什麼時候會失準的儀器。
Anthropic 這次做的事,等於在儀表旁邊貼了一張紙條:「這個讀數是在地面測的,空中可能不一樣。」
那張紙條的價值,比讀數本身高。而你要養成的習慣,是每次看到讀數,都先去找那張紙條。
常見問題 FAQ
Q:所以 Claude Opus 5.5 到底安不安全?
照 Anthropic 自己的評估,它在可量測的範圍內比自家其他模型好很多,而且剩下的越界嘗試都是低嚴重程度、由模型自行回報。但 Anthropic 同時明講,能在部署前抓出每一種失效的評估方法仍是未解問題。正確的理解是「在他們測得到的地方變好了」,不是「安全了」。
Q:「模型知道自己在被評估」是什麼意思?有那麼嚴重嗎?
意思是模型在測試情境下可能察覺自己正在被測,因而表現得跟真實使用時不一樣。嚴不嚴重要看用途:你只是拿它寫文件,影響很小;你讓它在你的系統裡自動執行好幾個小時,那就很重要。這也是 Anthropic 把這句話寫進公告的原因。
Q:85% 這個數字可以拿去跟別家比嗎?
不行。它的比較對象是 Anthropic 自家的 Opus 5、Mythos 5.1,用的是 Anthropic 自己設計的新評估。不同廠商的安全評估方法不一樣,數字之間沒有可比性,硬拿來比會得出錯誤結論。
Q:那我要怎麼判斷一家 AI 供應商可不可信?
我的建議是看三件事:一,數字有沒有講清楚跟誰比、在哪測;二,有沒有第三方參與,以及第三方做到哪一步;三,他們願不願意主動講出自己數字的限制。第三點最有鑑別度,因為它假裝不來。
Q:公司該因為這次更新換模型嗎?
看你的用途。公告顯示它在程式開發與知識工作測試上表現較好,成本比前一代低 40%;但在商業工作流程那項測試上略低,差距小。沒有哪個模型全面領先,先確定你最常做的事情屬於哪一類,再拿自己的真實任務測一輪,不要看排行榜決定。
Q:這篇是不是在幫 Anthropic 說話?
我確實稱讚了他們公開限制這件事,這是我的判斷。要一併說清楚的是:我沒有實測過這些安全數字,本文全部引用官方公告;我也跟 Anthropic 沒有任何商業合作或分潤關係。稱讚的是那個做法,不是那個產品。
資料來源
以下均於 2026 年 9 月 27 日讀取原文:
- Anthropic 官方公告 Claude Opus 5.5(anthropic.com/claude-opus-5-5):85% 越界嘗試減少的完整原句、「every attempt it made was low severity and self-reported」、自動化行為稽核為其最完整的對齊測試且 Opus 5.5 表現為歷來最佳、外部測試機構 METR 與 Frontier Design、以及「building evaluations that reliably catch every failure prior to deployment remains an unsolved problem. We see signs that Opus 5.5 often suspects it is being evaluated…」整段限制說明、完整評估細節見 Opus 5.5 System Card、網路安全類任務改由其他模型接手的安全機制。本文兩段引號內的英文均為該頁原文。
- iThome 報導(2026-09-23,記者陳曉莉)(ithome.com.tw/news/179162):發布日期為 9 月 22 日(週二)、自動化行為稽核涵蓋近 2,000 種模擬情境、benchmark 對照數字(Terminal-Bench 4.0 為 66.4% 對 57.9%、FrontierCode 為 54.4% 對 53.3%、GDPval-AA v2.1 為 1846 對 1542 Elo、AutomationBench 為 40% 對 41.4%、Terminal-Bench-Science 為 58.7% 對 64.6%)、成本較 Opus 5 降低 40%、輸出速度提高超過 30%、每百萬輸入與輸出 token 價格 4 美元與 20 美元。
查證說明(誠實揭露):① 兩段最關鍵的引文我都附上英文原句,取自 Anthropic 官方頁面,中譯為我自己翻的,意思貼原文但非逐字直譯,需要精確引用請看原文。② benchmark 數字與 2,000 種情境的敘述來自 iThome 報導,我沒有逐項回到 System Card 核對原始數據,這點必須說清楚。③ 我沒有實測過 Opus 5.5 的任何安全行為,也沒有能力做這類評估;全文安全相關描述一律是引用,不是我的驗證結果。④ 所有 benchmark 數字由 Anthropic 公布,跨廠商比較由其中一方發布時,選題與設定本身就帶立場,不宜當作中立評測。⑤ 85% 是相對於自家其他模型的相對值,基數未公開,不可解讀為絕對安全水準,也不可跨廠商比較。⑥ 文中「我認為願意寫出限制的廠商比較可信」是我的判斷,不是任何研究結論。⑦ 我與 Anthropic、OpenAI 均無商業合作或分潤關係;我的課程會教到多家工具,這點一併揭露。
下次看廠商簡報,加問一句:「這個數字在什麼情況下會不成立?」
想定期拿到這種「把原文挖出來對」的整理:我的電子報大約一到兩週一封 → startupforyou.substack.com
如果你要幫團隊建立判斷 AI 工具的共同標準:我的企業內訓有一個模組專門做這件事——拿你們正在評估的那幾份廠商簡報當教材,現場練怎麼拆數字、怎麼問出對方沒寫的限制。想聊聊寫信到 ai@autolab.cloud,或看看 AI 顧問教練團。
如果你正在規劃 2027 年的 AI 課程,不管你是 HR、訓練主管還是老師,都歡迎找阿峰老師聊聊,一起把課排對:https://autolab.cloud/corporate-training/?f=blog
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、電通、城邦媒體等。聯絡方式:ai@autolab.cloud