一句話結論
Anthropic 公布了一份自己量自己的指數:到 2026 年 8 月,Claude 在該公司 26% 的 AI 研發工作裡是「主導者」,而 2026 年 2 月這個數字還不到 1%。半年之間的跳升確實驚人。但同一份文件裡還藏著另一個數字:替這些工作打分數的人類評分員,彼此完全一致的比例只有 35%。所以真正該帶走的不是「AI 做了幾成」,而是——連最有條件量的那家公司,量起來都這麼勉強,你公司內部那句「AI 幫我省了一半時間」是怎麼算出來的?
這陣子只要提到 AI 取代工作,大家問的都是同一種問題:幾成?多久?輪到我了沒?
九月中有一份文件,剛好把這個問題往前推了一格。它不是預測,是一家公司回頭量自己。
26%,而且半年前還不到 1%
Anthropic 發表了一份它稱為 R&D Automation Index(研發自動化指數)的東西,量的是「Anthropic 自己的 AI 研發工作,有多少是由 Claude 執行的」。
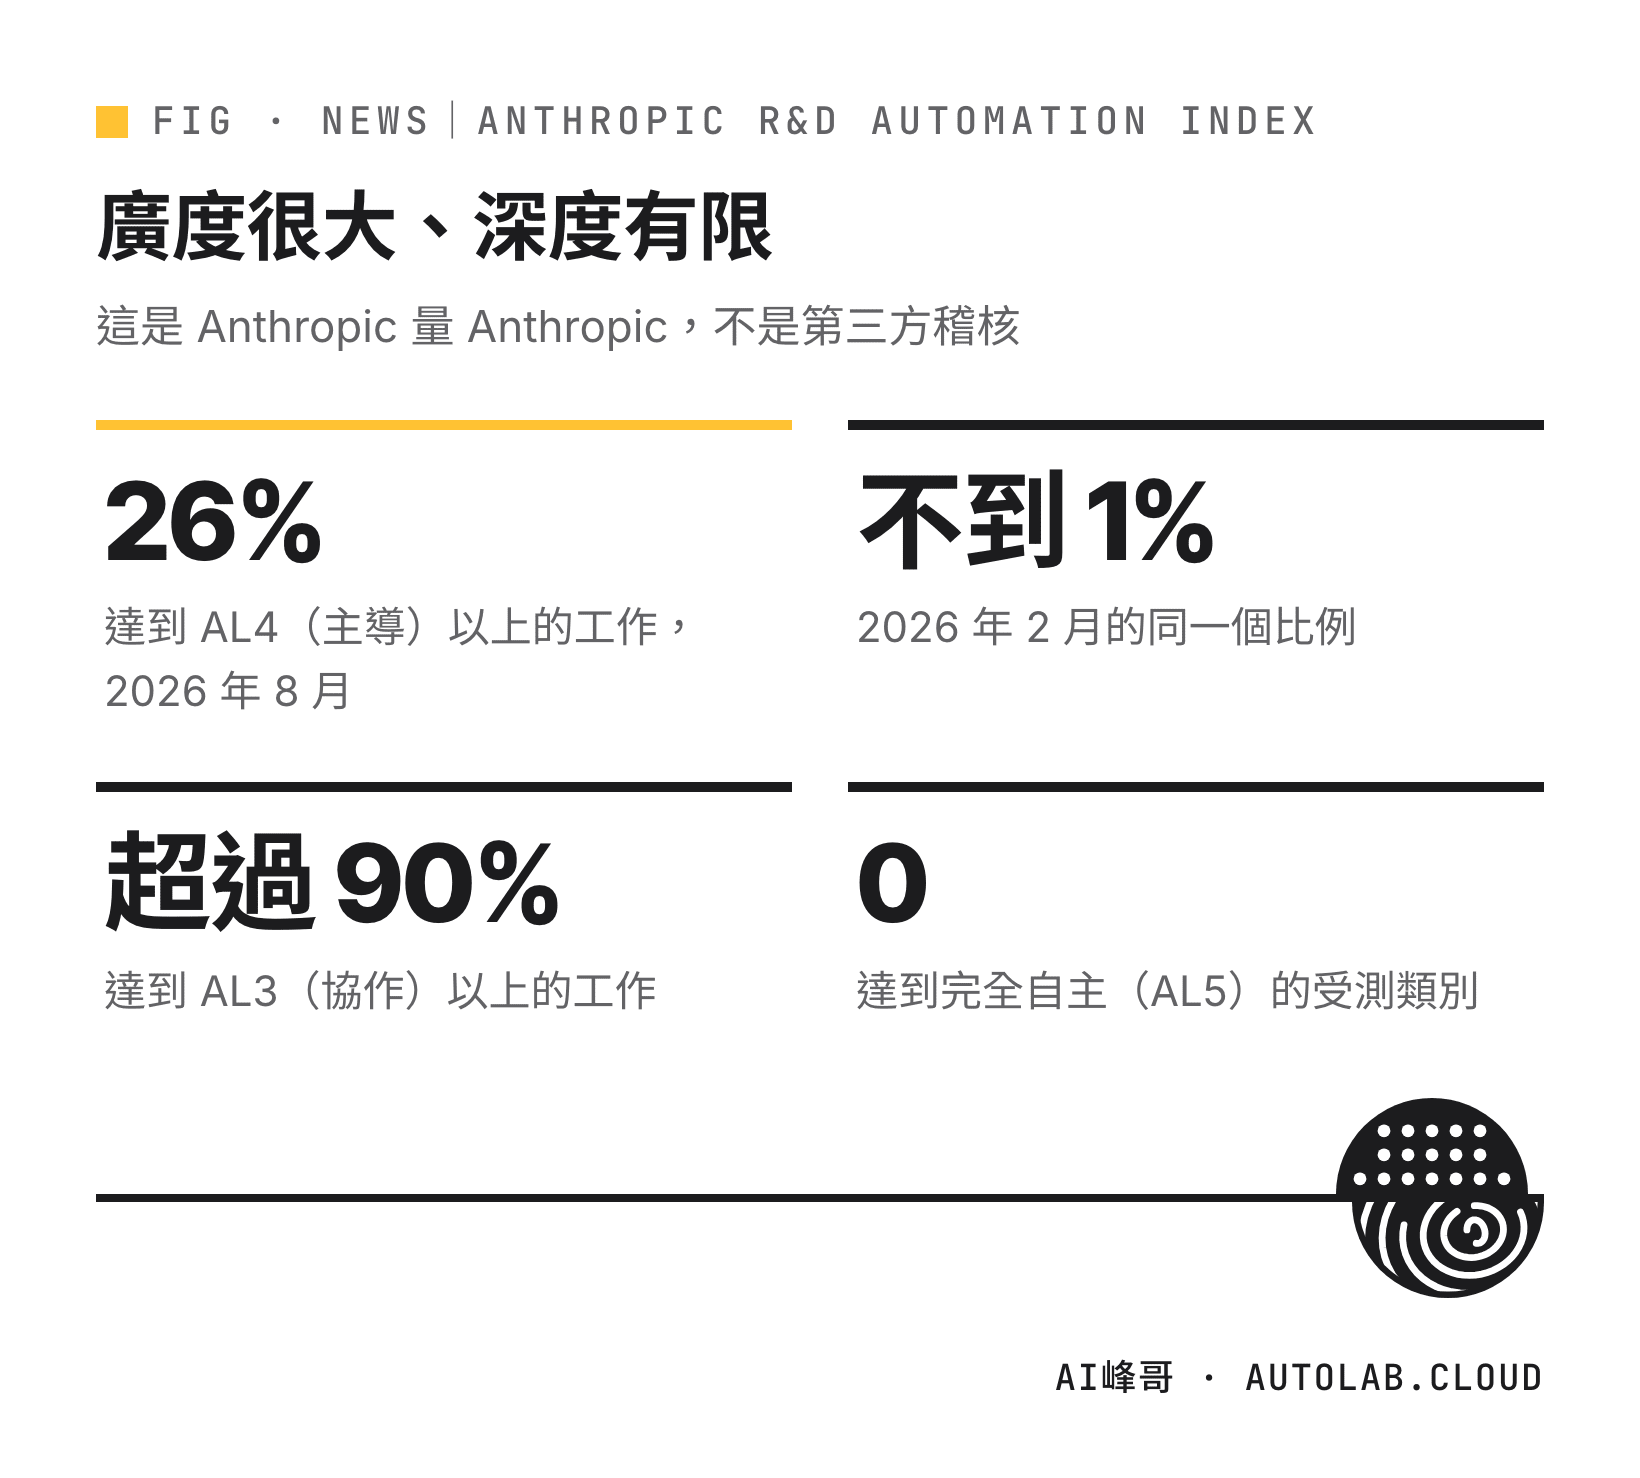
結論數字是:2026 年 8 月,Claude 在 26% 的 AI 研發工作上達到「主導」等級。而在 2026 年 2 月,這個比例還不到 1%。
先別急著換算成你的工作。這句話裡每一個詞都有很嚴格的定義,而定義才是重點。
「主導」不等於「取代」——中間差了一整個人
這份指數用的是一套叫做 AL(Automation Level,自動化等級)的量表,從 AL0 到 AL5。Anthropic 在文件裡寫明這套量表是引用外部研究機構 Epoch AI 開發的,不是自己發明的。
其中三級的定義最關鍵:
- AL0:完全沒有 AI 參與。
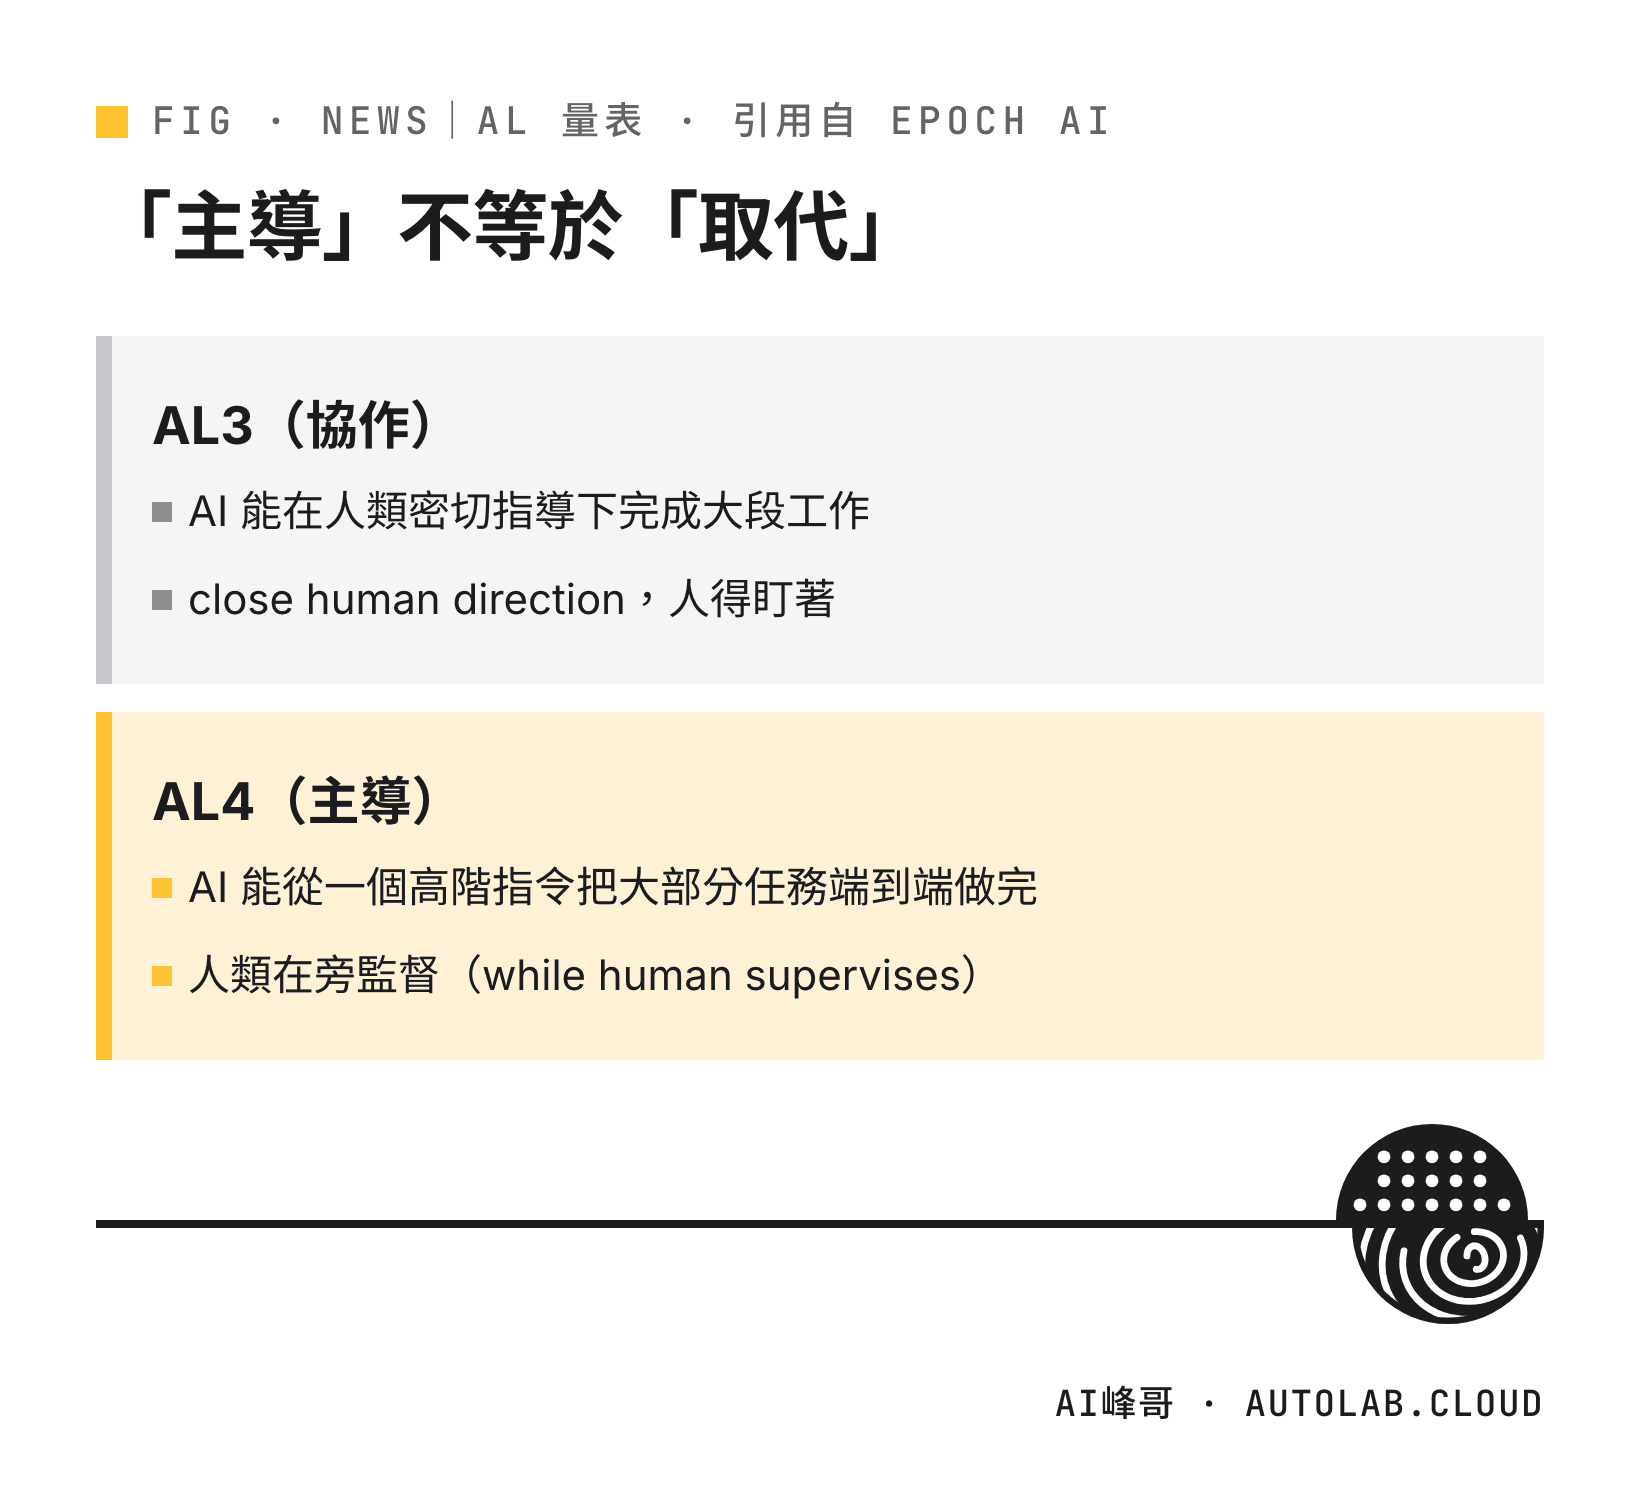
- AL3(協作):AI 能在人類密切指導下完成大段工作。原文是「can do large chunks of work under close human direction」——close human direction,人得盯著。
- AL4(主導):AI 能從一個高階指令把大部分任務端到端做完,人類在旁監督(while human supervises)。
- AL5:AI 完全自主,流程裡沒有人。
那個 26%,指的是達到 AL4 以上的工作比例。
所以「Claude 主導 26% 的研發」這句話翻成白話是:有四分之一的研發工作,工程師可以丟一句高階指令出去,然後不用一直盯著,但還是要驗收。
而 AL5 呢?Anthropic 明講了:在任何一個受測類別裡,Claude 都沒有達到完全自主。一個都沒有。
其實更該看的是另一個數字:90%
26% 是標題數字,但我認為對企業工作者更有意義的是這一個:
達到 AL3(協作)以上的工作,超過 90%。
把兩個數字擺在一起看,圖像就清楚了:在這家公司,AI 幾乎碰到了所有的研發工作(90%+ 至少是協作),但真正能放手讓它主導的,只有四分之一,而完全放手的是零。
這個形狀——廣度很大、深度有限——才是目前 AI 在專業工作裡的真實樣子。它不是在一格一格地吃掉整份工作,它是在每一份工作裡都切走一塊,而那塊的大小,取決於你有沒有辦法驗收它。
然後是那個 35%
這份文件最有價值的一段,藏在方法論裡。
要得出「26%」,必須有人替每一類工作打一個 AL 等級。那這個分數打得準嗎?Anthropic 自己做了一致性檢驗,結果是:
- 模型評分 vs 人類評分,完全一致的比例是 59%。
- 人類評分 vs 另一個人類評分,完全一致的比例是 35%。
- 不過,如果放寬到「差距在一級之內」,模型評分和人類評分的一致率是 97%(人跟人放寬後是多少,官方沒有公布)。
請把中間那行再看一次。兩個懂這份工作的人,看同一件事,對「AI 在這裡到底算參與到什麼程度」的看法,完全一致的機率只有三分之一。
而且是模型跟人的一致率(59%),還比人跟人的一致率(35%)高。這不代表模型更準,比較可能的解釋是模型打分比較穩定、比較不受個人判斷影響——但這正好說明了一件事:這種評分本來就沒有客觀答案。
Anthropic 自己怎麼形容?文件裡寫的是「邊界案例存在實質的分歧空間(real room for disagreement on borderline cases)」。而且他們從頭到尾把這份東西稱為 prototype(原型),不是定論。
所以這件事跟你有什麼關係
我在企業現場最常被問到的一句話是:「老師,導入 AI 之後效率提升多少?有沒有數字?」
而最常聽到的回答版本是:「我們團隊用了之後,效率大概提升三成。」
現在把這句話跟上面那個 35% 擺在一起看。
Anthropic 有什麼條件?它有模型原始碼、有完整的內部工作紀錄、有可以在 7 月每週從研發相關部門各隨機抽 20% 員工去盤點工作的權限、有 Claude 幫忙把約 15,000 項工作整理成一棵 542 個節點的分類樹、還有專業研究團隊做一致性檢驗。在這種條件下,兩個人打同一件事的分數,完全一致的機率是 35%。
那麼,你們公司那個「提升三成」,是誰、用什麼方法、跟什麼基準比出來的?
我不是要說那句話一定是錯的。我是要說:它多半不是一個量出來的數字,而是一個體感。體感沒有不好,體感也是資訊。但把體感當成 KPI 往上報,再拿那個 KPI 去決定要不要擴大投資——中間那一段是空的。
誠實踩煞車
這份文件有幾個限制,我認為比那個 26% 更值得你記住:
- 這是 Anthropic 量 Anthropic。不是第三方稽核。這家公司有誠意揭露方法論(它連自己評分不一致都寫出來了,這很少見),但它同時也有「證明 AI 很強」的商業利益。兩件事同時為真。
- 這是上限,不是平均。世界上最會用 AI 的一群人,用自家最熟的模型,做自己最熟的工作。你公司的數字不會長這樣,也不該拿來比。
- 「AI 研發」是一種極度適合 AI 的工作。寫程式、跑實驗、讀日誌、比對輸出——這些有明確的對錯、可以自動驗證、失敗了重跑就好。你公司大部分工作不具備這三個條件。
- 指數本身有「籃子凍結」的問題,這是他們自己講的。意思是:這個指數量的是「既有的那些工作被自動化了多少」,它量不到新冒出來的工作類型。數字上升,不必然等於人變閒了;也可能是工作內容整個換了。
- 沒有公開的原始資料可供外部重現。15,000 項任務、542 個節點的分類樹,外面的人看不到。我們只能就它公布的說法討論。
把 AL 量表搬進你公司
這份文件真正可以帶走的東西,不是 26%,是那把尺。
大部分公司討論 AI,只有兩格:「有用 AI」跟「沒用 AI」。這太粗了,粗到沒辦法管理。AL 量表的價值在於它把中間切開,而一切開,責任歸屬就跟著清楚了。
| 等級 | 辦公室裡長什麼樣 | 出錯時誰要負責驗收 |
|---|---|---|
| AL0 沒有 AI | 全手工。合約最後一遍逐條看、對客戶的道歉信 | 本人 |
| AL3 協作 | 你開著對話一來一往:它產一版、你改、再產一版。會議紀錄整理、簡報初稿、資料表整併 | 本人,而且是邊做邊驗 |
| AL4 主導 | 你丟一句交辦就去忙別的,回來看成品。固定格式的週報、批次改圖、大量資料的初步分類 | 本人,但變成事後抽驗——所以抽驗方法要先設計好 |
| AL5 全自主 | 沒有人看,直接出去。自動回信、自動發布、自動送出申請 | 連 Anthropic 都還沒讓任何一類工作走到這格。你也先別急 |
這張表怎麼用?很簡單:下次有人說「我們部門已經在用 AI 了」,你就問一句:用到第幾級?
你會立刻發現,大家講的根本不是同一件事。有人是 AL3 拚命來回改,有人是 AL4 丟出去就收,還有人偷偷在做 AL5——而 AL5 那個人,通常沒告訴任何人。
所以你該做什麼
如果你是一般上班族:拿你這週最花時間的三件工作,各標一個 AL 等級。標完你會看到一件事——你花最多時間的,通常卡在 AL3,也就是「一直來回改」。那才是你該改進的地方,而改進的方向通常不是換更強的模型,是把驗收標準先寫清楚。你之所以要來回三次,是因為第一次交辦時你自己也還沒想清楚要什麼。
如果你要用 AI 量產東西:你真正該爭取的不是「讓 AI 做更多」,而是「讓某一類工作從 AL3 升到 AL4」。這兩件事完全不同。升級的前提只有一個:你得先有一個不用逐字讀就能判斷好壞的驗收方法。沒有那個方法,硬升到 AL4 只是把錯誤延後發現而已。
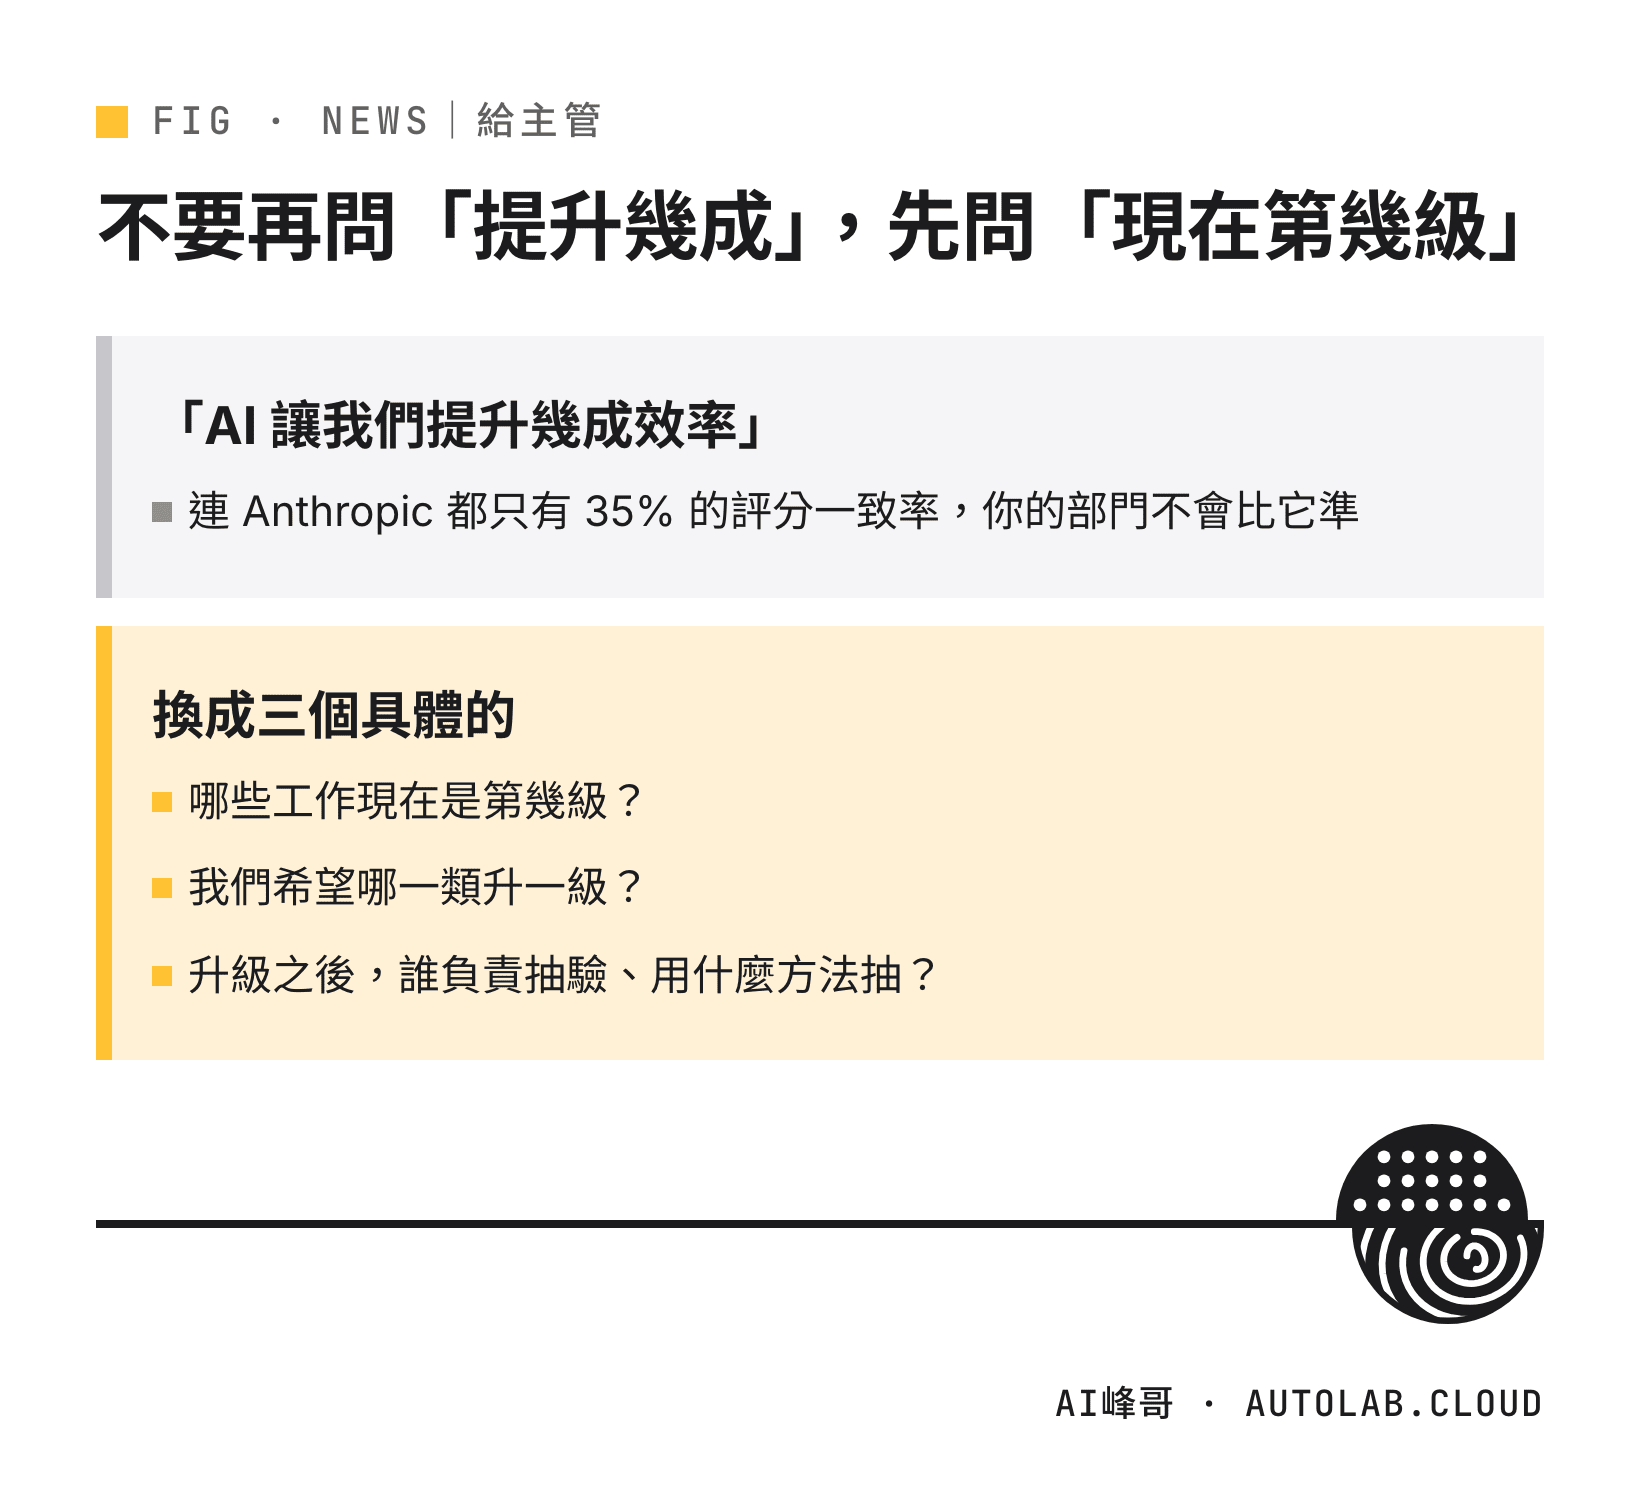
如果你是主管:請把「AI 讓我們提升幾成效率」這個問題,換成三個具體的:哪些工作現在是第幾級?我們希望哪一類升一級?升級之後,誰負責抽驗、用什麼方法抽?這三題有答案,你才有東西可以管。第一個問題沒有答案——連 Anthropic 都只有 35% 的評分一致率,你的部門不會比它準。
你是機長,AI 是機組人員
AL4 這個等級,在航空業裡有一個現成的對照:自動駕駛。
一趟長程航班,自動駕駛負責飛的時間遠遠超過人手操縱的時間。但沒有人因此說機長被取代了,因為大家都知道,機長的工作從來就不是「握著操縱桿」。
真正發生的事情是:機長的工作內容被換掉了。從操作,變成監控、判斷、以及在系統交還控制權的那幾秒鐘內做對的事。而航空業為了這件事,把整套訓練跟檢定制度重新設計過——不是因為自動駕駛不可靠,正好相反,是因為它太可靠了,可靠到人會鬆懈。
Anthropic 那個 26%,講的就是這件事。它不是在說有 26% 的人不用了。它是在說:有 26% 的工作,你的角色從操作換成了監督。
而監督是一種技能,它跟操作是兩回事,要另外練。這是 AL4 唯一真正的門檻,也是大部分公司升不上去的原因——他們把 AI 交辦出去了,卻沒有人被訓練成那個看儀表的人。
常見問題 FAQ
Q:26% 是不是代表 Anthropic 裁掉了四分之一的研究員?
沒有這個推論。這份指數量的是「工作的自動化等級」,不是人力配置。而且文件自己就點出「籃子凍結」的限制:它量不到新出現的工作類型。同一批人做的事情可能整個換掉了,但指數看不出來。任何從這個數字推導裁員的說法,都是自己加上去的。
Q:那我的工作會不會也有 26% 被 AI 主導?
幾乎確定不會是這個數字。AI 研發是一種對 AI 特別友善的工作:對錯明確、可以自動驗證、失敗重跑成本很低。你的工作只要少掉其中一個條件,能自動化的比例就會大幅下降。與其猜比例,不如用上面那張表實際標一次——標完你會有一個屬於自己的、比較誠實的答案。
Q:人類評分只有 35% 一致,那這份報告是不是根本不可信?
不是。同一段還有另一個數字:放寬到「誤差一級之內」,模型評分和人類評分的一致率是 97%,代表評分大致落在哪一區是穩的,只是在切點上會爭(人跟人放寬後是多少,官方沒有公布)。所以這份指數拿來看趨勢(從不到 1% 到 26%)是合理的,拿來當作精確刻度就不合理。我認為它願意把這個弱點寫出來,反而讓這份文件更可信,不是更不可信。
Q:我們公司想學它做一個自己的指數,可行嗎?
可行,但不要一次做全公司。挑一個部門、一種重複性高的工作,找兩個熟悉這份工作的人各自獨立標一次 AL 等級,然後看你們差多少。光是這一步就有價值——你們對不齊的地方,通常就是流程裡沒有講清楚的地方。比起最後那個百分比,這個副產品有用得多。
Q:AL5 既然一個都沒有,是不是表示 AI 短期內不會全自動?
在「AI 研發」這個領域、到 2026 年 8 月為止、依照 Anthropic 自己的評分,是這樣。這句話的每一個前提都不能拿掉。它不保證別的領域、別的公司、別的時間點也是如此,也不保證下一季不會變。它只告訴你一件事:連最有動機把自己推到全自動的那家公司,現在也還留著人在流程裡。你公司要跳過那一格,理由最好比它更充分。
資料來源
以下均於 2026 年 9 月 20 日查證:
- Anthropic 官方文件〈Measurements for understanding the pace of AI development inside frontier labs〉(anthropic.com/institute):R&D Automation Index 的定義與「prototype」的自述、26%(2026 年 8 月,AL4 以上)、2026 年 2 月不到 1%、AL3 以上超過 90%、AL0/AL3/AL4/AL5 的定義原文、AL 量表引用自 Epoch AI 的說明、2026 年 7 月隨機抽樣各部門 20% 員工、約 15,000 項任務整理成 542 節點/378 葉節點的分類樹、評分一致性(模型對人類完全一致 59%、人類對人類 35%、模型對人類一級之內 97%)、「real room for disagreement on borderline cases」與「籃子凍結」的限制自述。
- Bloomberg:〈Anthropic Says Claude Drives 26% of Its Research and Development〉(bloomberg.com,2026 年 9 月 17 日):用來確認這份數字的公開揭露日期為 2026 年 9 月 17 日。
- Quartz:〈Anthropic says Claude leads 26% of its AI R&D work〉(qz.com):第二個獨立來源,交叉確認揭露時間與「Claude 未在任何受測類別達到完全自主」的說法。
查證說明(誠實揭露):①所有百分比與等級定義均以 Anthropic 官方文件原文為準,媒體報導僅用於交叉確認發布時間。②官方文件頁面上我沒有查到明確標示的發布日期,文中的「9 月 17 日」是依據 Bloomberg 與 Quartz 兩家的報導日期,非官方頁面自述,特此標明。③AL 量表原始出處為 Epoch AI,我查到 Anthropic 文件中引用它的原句,但沒有進一步去讀 Epoch AI 的原始定義,因此本文只引用 Anthropic 文件中呈現的 AL0/AL3/AL4/AL5 四級;AL1 與 AL2 的定義我查不到,所以不寫,上文表格也因此跳過這兩級。④這是 Anthropic 調查 Anthropic,不是第三方稽核,原始資料(15,000 項任務與分類樹)未公開,我無法獨立重現任何一個數字。⑤文中「你公司那句提升三成是怎麼算的」是我的教學現場觀察與推論,不是報告內容。⑥表格中「辦公室裡長什麼樣」與「誰負責驗收」兩欄是我依據 AL 定義自行對應到一般企業場景的說明,不是 Anthropic 的分類,請當成教學用的類比而非原始資料。⑦自動駕駛與機組訓練的類比是我用來解釋機制的比喻,與本報告無關。
不要再問「提升幾成」,先問「現在第幾級」
我會把這類報告拆成「哪些能用、哪些是廠商話術」:我的電子報大約一到兩週一封 → startupforyou.substack.com
如果你是主管:我的企業內訓有一個模組就是帶主管把部門工作逐項標等級,再挑一類設計驗收方法——課堂上用貴公司自己的工作清單當練習題,不是用範例。想聊聊寫信到 ai@autolab.cloud,或看看 AI 顧問教練團。
公司想導入 AI、安排內訓 → 企業內訓諮詢表單
關於作者
黃敬峰(AI峰哥/阿峰老師),企業 AI 實戰培訓專家,服務客戶包含國泰人壽、工研院、士林電機、電通、城邦媒體等。聯絡方式:ai@autolab.cloud